[논문리뷰] Sparse Feature Policy Unlearning Mitigates State Hallucination in Vision-Language-Action Models
링크: 논문 PDF로 바로 열기
메타데이터
저자: Jiho Lee, Jeongeun Park, Heayoun Choi, Taekyung Kim, Eunwoo Kim
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- VLA (Vision-Language-Action Models): 시각 및 언어 이해와 로봇 동작 생성을 통합하여 고수준의 지시를 연속적인 로봇 제어 명령으로 변환하는 모델입니다.
- State Hallucination: 로봇이 물리적으로 달성하지 못한 로봇-객체 상태를 달성했다고 가정하고 동작을 이어가는 재귀적인 실패 패턴입니다.
- SAE (Sparse Autoencoders): 모델의 dense한 활성화 값을 해석 가능한 희소(sparse) 잠재 표현으로 분해하여, 특정 행동 패턴과 관련된 내부 특징을 식별하는 기법입니다.
- SOUL (Sparse feature pOlicy UnLearning): 상태 환각(State Hallucination)과 관련된 sparse feature를 억제하고 성공적인 동작과 관련된 feature를 강화하여 정책을 선택적으로 수정하는 방법론입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 논문은 VLA가 실제 환경에서 로봇-객체 상태를 오인하여 발생하는 State Hallucination 문제를 해결하는 것을 목적으로 합니다. 기존 모델들은 로봇이 물체를 잡지 않았음에도 잡은 것처럼 간주하여 이후 동작(운반, 배치 등)을 수행하는 등, 국소적인 오류가 전체 시퀀스로 전파되는 심각한 신뢰성 결함을 보입니다 [Figure 1]. 저자들은 이러한 현상이 과제와 관련된 시각적 영역에 대한 주의력(attention)이 약화된 상태에서 발생한다는 점을 발견하였습니다. 기존의 추론 시점 개입이나 단순한 파라미터 업데이트 방식은 의도치 않게 다른 유용한 기능을 저해할 위험이 있어, 특정 환각 패턴만을 제거할 수 있는 정교한 메커니즘이 요구됩니다.
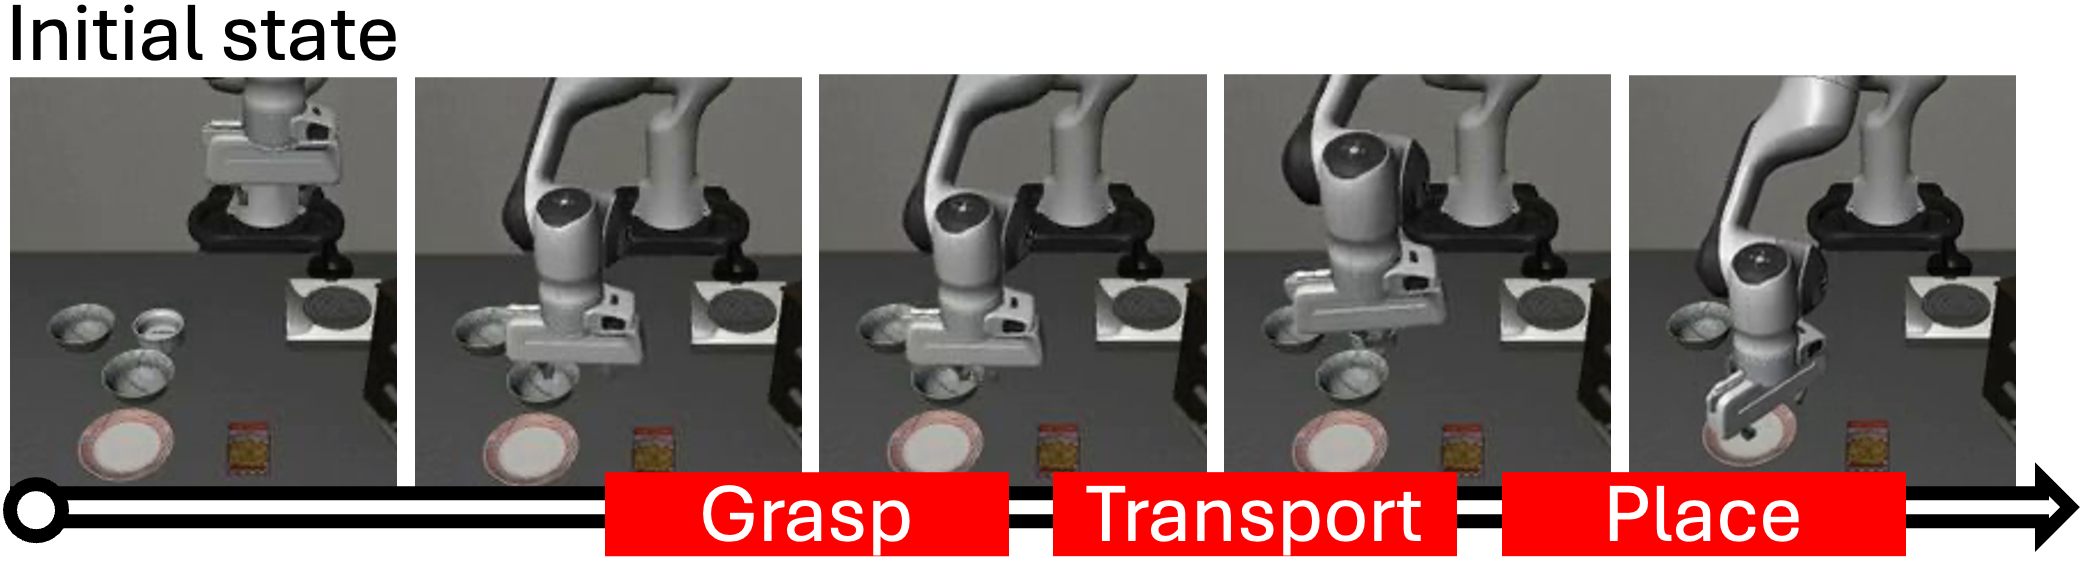
Figure 1 — 상태 환각 발생 예시
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 본 논문은 SOUL을 제안하여 환각 실패와 성공적 수행을 구분하는 sparse feature를 명시적으로 식별하고, 이를 통해 정책을 선택적으로 학습(Unlearning)합니다 [Figure 4]. 저자들은 SAE를 활용해 시각적 영역별로 활성화되는 특징을 분석하고, 상태 환각과 높은 연관성을 보이는 feature는 'forget' 타겟으로, 성공적 수행과 연관된 feature는 'retain' 타겟으로 선정합니다 [Figure 3]. 이들을 각각 억제 및 강화하는 손실 함수를 설계하여 LoRA 어댑터를 최적화함으로써 정책을 수정합니다. 실험 결과, SOUL은 기존 모델 대비 평균 환각률을 55.0%에서 33.5%로 대폭 감소시켰으며, Clean success(환각 없는 성공) 지표를 27.5%에서 52.2%로 향상시켰습니다 [Table I]. 또한, 기존에 성공했던 행동의 89%를 유지하면서 실패한 시나리오를 효과적으로 수정하는 높은 보존성을 확인하였습니다 [Figure 7].
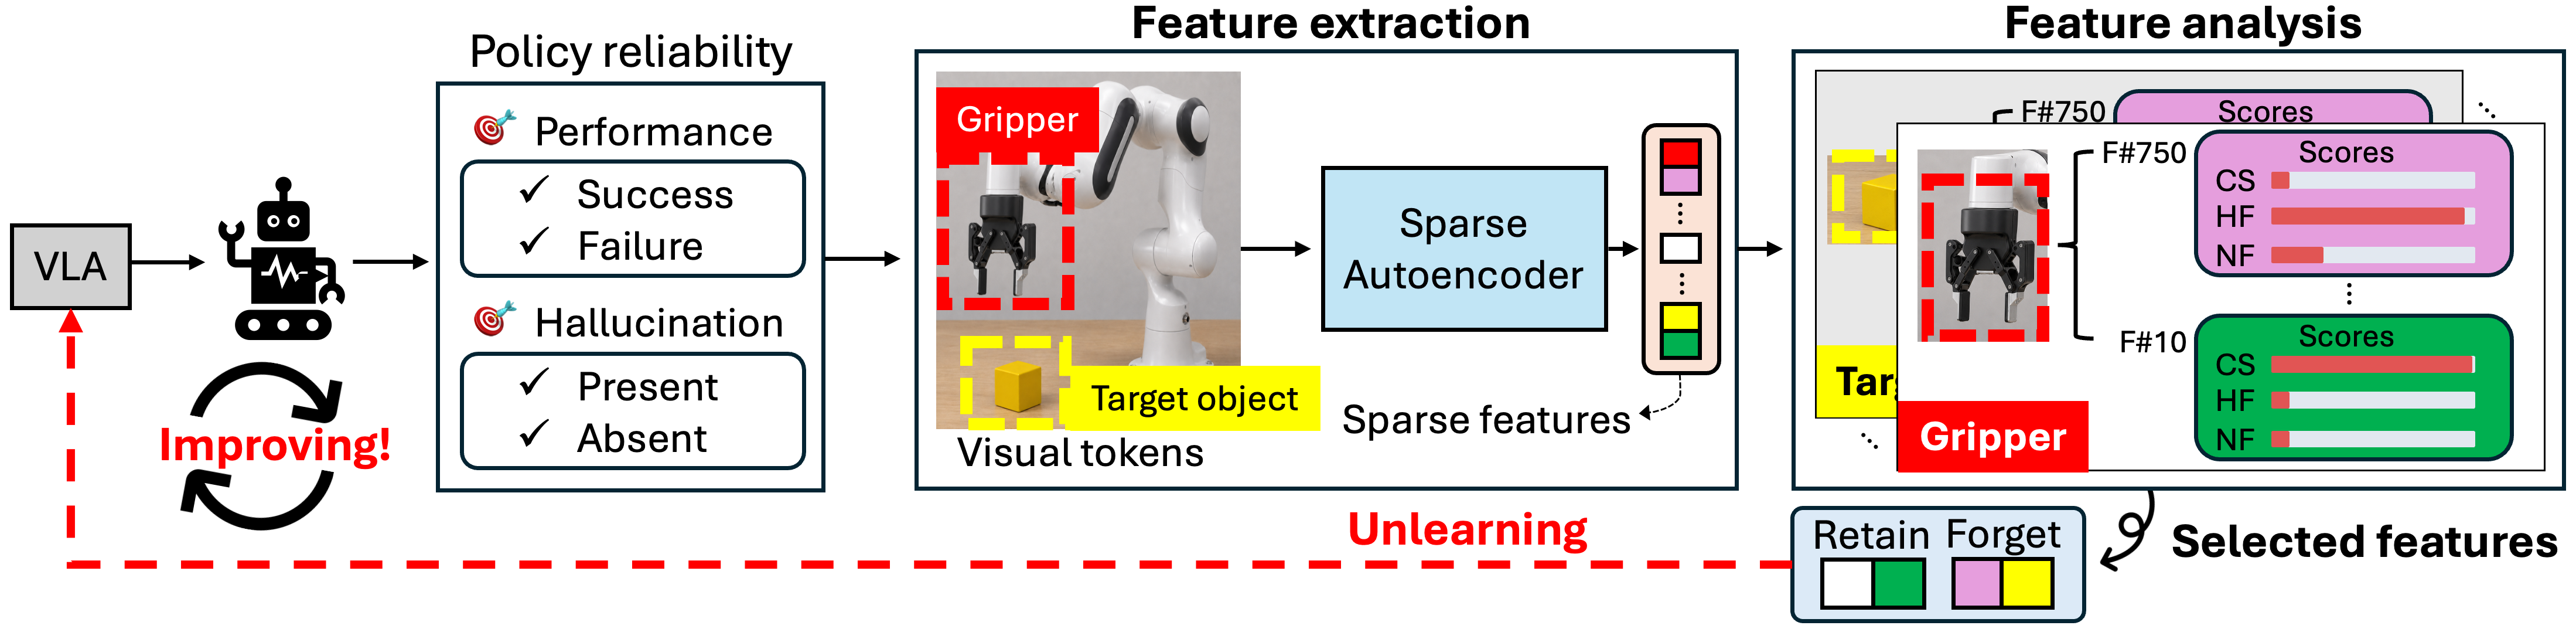
Figure 4 — SOUL 전체 프레임워크
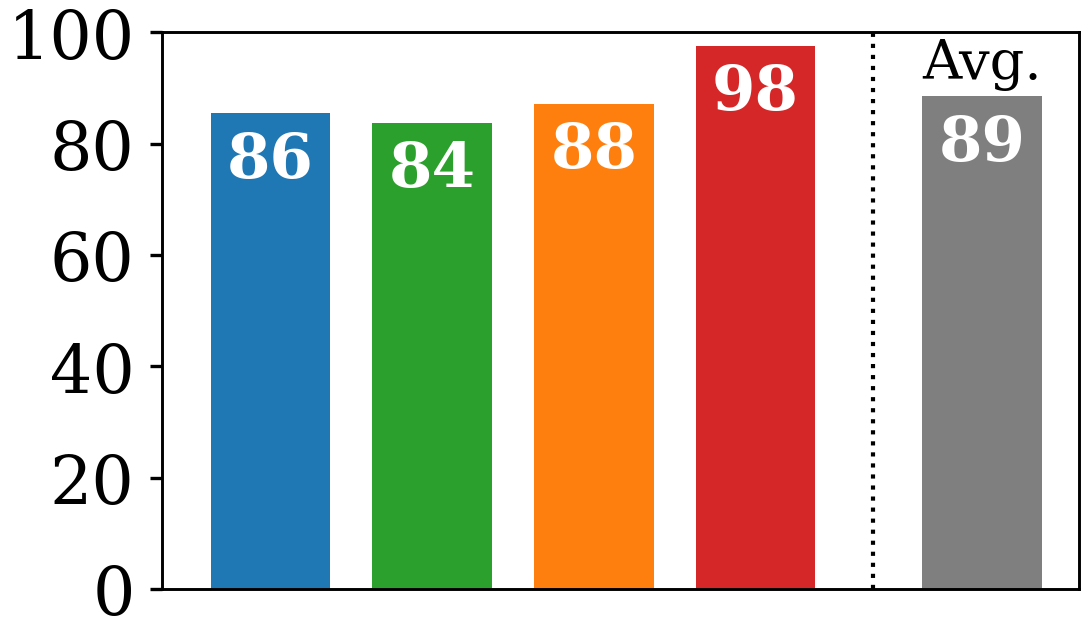
Figure 7 — 행동 보존 및 수정 성능
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 상태 환각이라는 재귀적 실패 패턴을 분석하고, SAE 기반의 interpretable feature analysis를 통해 이를 선택적으로 unlearning하는 SOUL 프레임워크를 성공적으로 구축하였습니다. 이 연구는 로봇 정책의 내부 표현을 명확히 이해하고, 모델 전체의 재학습 없이도 특정 불량 행동을 개선할 수 있는 실질적인 경로를 제시합니다. 본 방법론은 embodied foundation models의 신뢰성을 높이는 데 핵심적인 기여를 하며, 향후 로봇의 실세계 배포를 위한 안전한 정책 수정 기술의 표준으로 활용될 잠재력이 큽니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] VLA-Precision: Asymmetric Co-Bootstrapping for Efficient Real-World Online RL of Vision-Language-Action Models
- [논문리뷰] Act with Intent: Distilling Behavior Intent for Vision-Language-Action Models
- [논문리뷰] TacForcing: Streaming Action Generation with Execution-Time Tactile Feedback
- [논문리뷰] Generalizable VLA Finetuning via Representation Anchoring and Language-Action Alignment
- [논문리뷰] InternVLA-A1.5: Unifying Understanding, Latent Foresight, and Action for Compositional Generalization
Review 의 다른글
- 이전글 [논문리뷰] Self-Evolving Coding Agents via Harness-Policy Optimization
- 현재글 : [논문리뷰] Sparse Feature Policy Unlearning Mitigates State Hallucination in Vision-Language-Action Models
- 다음글 [논문리뷰] SpecMRL: Redesign Matryoshka Representation Learning within Parametric Spectrum
댓글