[논문리뷰] CulturalRiddles: A Multicultural Benchmark of Riddles
링크: 논문 PDF로 바로 열기
저자: My Chiffon Nguyen, Tianyi Hu, Vinod Anbalagan, Henry Gagnier, Pouya Sadeghi, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- CulturalRiddles: 다양한 문화적 배경을 가진 인간 참여자들이 직접 작성하고 검증한 6,191개의 원본 수수께끼로 구성된 다문화 벤치마크 데이터셋입니다.
- Participatory Benchmark: 연구자뿐만 아니라 실제 해당 문화권의 원어민들이 직접 데이터를 생성, 검증, 평가하는 협력적 데이터 수집 모델입니다.
- LLM Jury: 두 개의 고성능 모델(
Gemini 3.5 Flash,DeepSeek V4.1 Flash)을 사용하여 인간의 평가를 보조하고, 모델의 답변이 정답인지 검증하는 평가 파이프라인입니다. - Resource Level:
Common Crawl페이지 수를 기준으로 언어를 분류한 것으로, 데이터가 풍부한High-resource부터 거의 존재하지 않는Extremely low-resource까지 구분됩니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 기존 LLM 벤치마크가 대부분 영어를 중심으로 한 사실 기반 지식에 편중되어 있어, 실제 세계의 다양한 문화적 맥락을 이해하고 추론하는 능력을 적절히 평가하지 못한다는 문제의식에서 출발합니다. 기존 벤치마크들은 특정 지리적/언어적 영역에만 한정되거나 데이터의 품질 및 평가 프로토콜의 엄격함이 부족한 한계를 보입니다. 저자들은 문화적 이해가 단순히 단편적인 지식 암기를 넘어, 실제 삶의 경험과 연결된 맥락적 추론을 요구한다고 주장합니다. [Figure 1]에서 제시하는 바와 같이, 문화적 편향을 극복하고 실질적인 문화적 추론 역량을 정교하게 측정하기 위한 새로운 인간 중심의 평가 프레임워크가 필수적입니다.
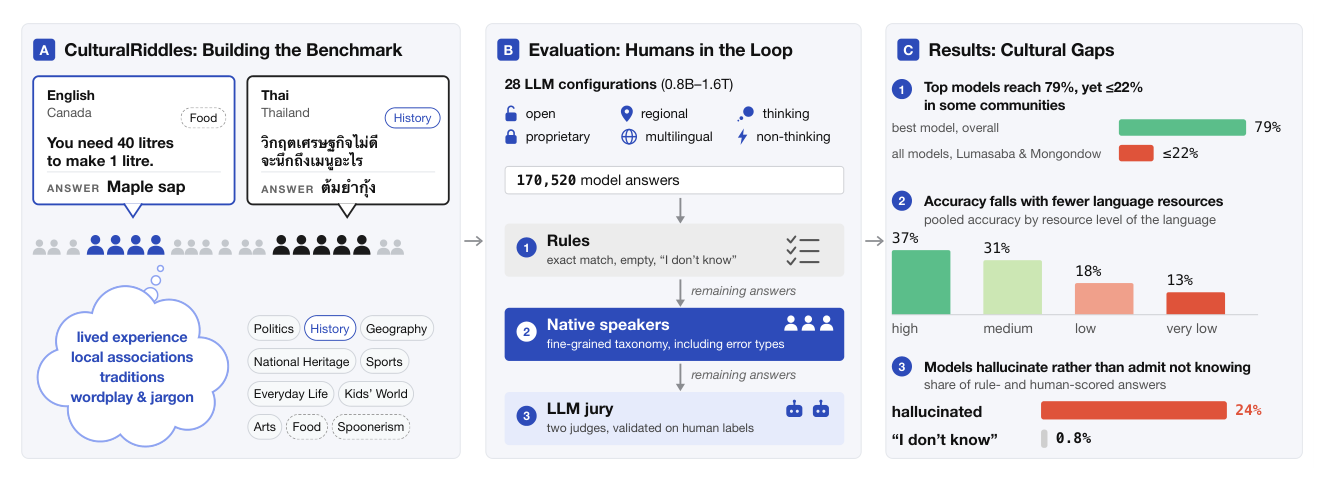
Figure 1 — 벤치마크의 전체적인 구조와 평가 파이프라인 및 핵심 결과 요약
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 연구는 전 세계 45개국, 51개 언어를 아우르는 62개 커뮤니티에서 총 6,191개의 수수께끼를 수집하여 28개의 다양한 모델 구성을 평가하는 대규모 실험을 수행하였습니다. 모델의 답변에 대해 Exact match, Native speaker 검증, 그리고 LLM jury를 거치는 다단계 스코어링 파이프라인을 구축하였습니다. [Figure 6]에 따르면, Gemini 3.1 Pro Preview와 같은 최신 frontier 모델이 79.4%의 최고 정확도를 기록했으나, 특정 문화권(Lumasaba, Mongondow)에서는 모델의 성능이 22% 이하로 급격히 저하되었습니다. 또한, 연구 결과는 단순한 Exact match 방식이 정답의 절반 이상을 놓치고 있음을 보여주며, 인간 원어민의 검증이 모델 순위를 재평가하는 데 결정적인 역할을 함을 증명합니다. 특히, 언어 자원 수준이 낮을수록 정확도가 유의미하게 하락하는 경향을 확인하였으며, [Figure 8]과 같이 동일한 언어 자원 내에서도 문화적 커뮤니티에 따라 성능 편차가 크게 나타나는 것을 확인했습니다.
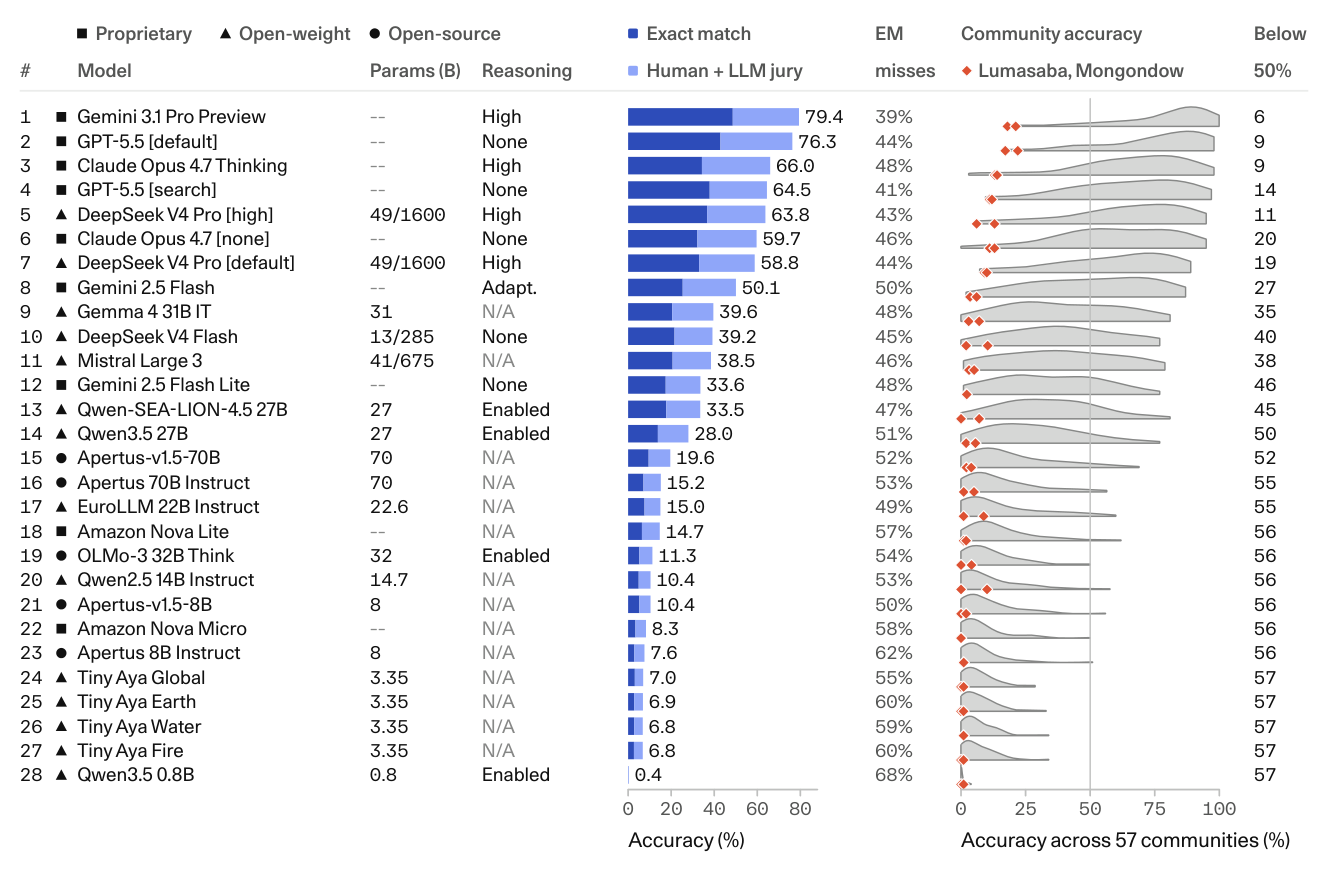
Figure 6 — 모델별 정확도 비교 및 문화적 성능 사각지대를 보여주는 핵심 결과 그래프
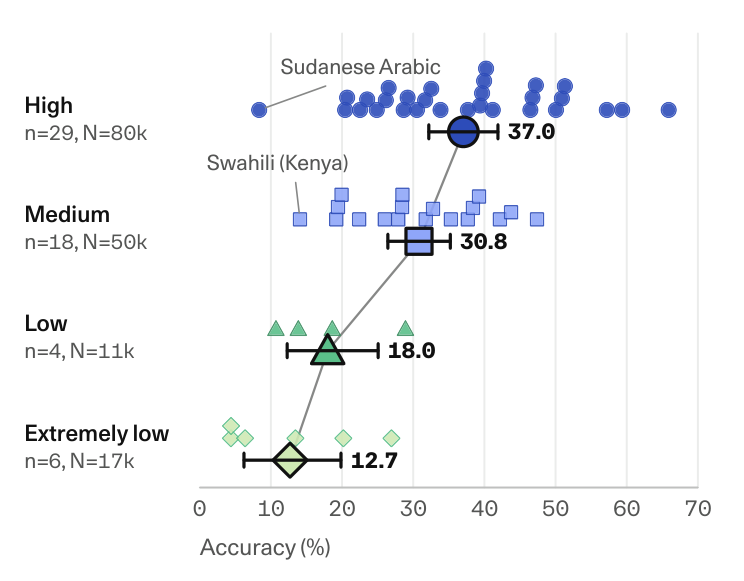
Figure 8 — 언어 자원 수준에 따른 커뮤니티별 성능 차이 분석
4. Conclusion & Impact (결론 및 시사점)
본 연구는 대규모 다문화 벤치마크를 통해 현재의 LLM이 문화적 고유성이나 세부적인 지역 지식 처리에 있어 심각한 사각지대를 가지고 있음을 명확히 드러냈습니다. 연구 결과는 단순히 모델의 파라미터 크기나 언어 자원의 확보만으로는 문화적 장벽을 완전히 해소할 수 없음을 시사하며, 해당 문화권 구성원이 직접 참여하는 데이터셋 구축이 미래의 문화적 추론 능력 향상에 필수적임을 강조합니다. 이 벤치마크와 평가 파이프라인은 향후 모델들이 전 세계 다양한 문화적 맥락을 더욱 효과적으로 이해하도록 유도하는 중요한 지표로 활용될 것입니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Are We Testing Too Much? A Survey of Benchmark Compression for Efficient Evaluation of Large Language Models
- [논문리뷰] AMLworld-Compact: Importance-Weighted Downsampling for Cost-Effective LLM Evaluation and Error Diagnosis
- [논문리뷰] WideSWE: Can Coding Agents Coordinate Changes Across Repositories?
- [논문리뷰] Benchmark Radar: A Living Database and Search Engine for AI Benchmarks and Evaluation
- [논문리뷰] RESCUE-BENCH: Towards Relation-Aware Multi-Party Emotional Support Conversation Systems
Review 의 다른글
- 이전글 [논문리뷰] CompactSplat: Spatially Adaptive Gaussian Distribution for Feedforward Scene Reconstruction
- 현재글 : [논문리뷰] CulturalRiddles: A Multicultural Benchmark of Riddles
- 다음글 [논문리뷰] DONIC: Generalist Dexterous Bimanual Tracking Control from Human Demonstrations
댓글