[논문리뷰] DeLoop: Repeated Actions as Self-Supervision for Long-Horizon Agents
링크: 논문 PDF로 바로 열기
저자: Tianle Chen, Pushkar Singh, Ketan Todi, Biswajit Paria, Qijia He, Wenqi Wang, Yuwen Tan, Jike Zhong, Sugato Basu, Deepti Ghadiyaram, Arjun Akula et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Loop (Looping action): 에이전트가 이전에 수행했던 도구 호출을 동일한 인자로 다시 실행하고 동일한 관찰(observation)을 받아 새로운 정보가 추가되지 않는 실패 사례입니다.
- Long-Horizon Agents: 여러 상호작용 단계(interaction steps)에 걸쳐 작업을 해결하며, 저장소 검사, 명령어 실행, 도구 호출 등을 포함하는 언어 모델 에이전트를 지칭합니다.
- Context Compression: 에이전트의 증가하는 상호작용 기록(interaction history)을 제한된 Context Window에 맞추기 위해 요약하거나 잘라내는(truncating) 데 사용되는 기법입니다.
- Direct Preference Optimization (DPO): 명시적인 보상 모델(reward model) 없이, 하나의 응답(response)을 다른 응답보다 선호하도록 정책(policy)을 직접 훈련시키는 방법론입니다.
- Loop Rate: 적어도 하나의 Looping Action을 포함하는 작업의 비율(percentage)입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Long-Horizon Language-Model Agents가 이전에 실행했던 작업을 반복하는, 즉 동일한 도구 호출을 같은 인자로 다시 발행하고 동일한 Observation을 받는 "Loop" 현상을 핵심 문제로 지적합니다. 이러한 반복은 에이전트의 Context Window를 맞추기 위한 Context Compression 상황에서 훨씬 더 빈번하게 발생하며, 이는 불필요한 토큰 소비와 도구 실행으로 이어져 상호작용 비용을 증가시킵니다. 예를 들어, Qwen3-8B 에이전트는 CodeGym 벤치마크에서 Full History를 사용할 때 Loop Rate가 29.0%였지만, 요약(summarization)을 적용하면 57.3%로 급증합니다. 더 중요한 것은, Loop에 진입한 Trajectory는 Task Failure로 이어질 가능성이 훨씬 높다는 점입니다. 평가된 Qwen3 및 Gemini 모델들에서 Loop가 발생하는 실행(looping runs)의 평균 59.5%가 실패하는 반면, Loop가 없는 실행(loop-free runs)은 33.4%만 실패하여, Loop가 Task Failure의 강력한 지표임을 보여줍니다 [Figure 2]. 기존의 Context Management 연구는 어떤 기록을 유지할지에 초점을 맞추거나, Reflection, Early Stopping과 같은 Inference-Time Controls는 에이전트 Policy 자체를 변경하지 않습니다. 또한, 대부분의 에이전트 훈련 방법론은 Gold Answer, LLM Judge 또는 외부 보상과 같은 외부 Supervison을 필요로 합니다. 따라서, 본 연구는 Long-Horizon Agents의 고유한 반복(repetition) 문제, 특히 Context Compression이 Loop를 증폭시키는 문제에 대한 효과적이고 Self-Supervised된 Policy 개선 방법의 필요성을 강조합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 압축된 Context 하에서 반복적인 Action을 줄이기 위해 Self-Mined Loop Pairs에 대한 Preference Optimization 기반의 DeLoop라는 Self-Supervised Training Method를 제안합니다. 이 방법론의 핵심은 에이전트의 고유한 실행(rollout) 내에서 발생하는 Loop 자체가 유용한 Training Signal을 제공한다는 관찰에 있습니다. 구체적으로, Loop를 유발하는 Action은 Negative Example(y−)으로 사용되고, 동일한 Rollout에서 이후에 발생하여 Loop를 벗어나는 첫 번째 Non-Looping Action은 Positive Example(y+)으로 사용됩니다 [Figure 4]. 이러한 Preference Pair는 Task Reward, Gold Label, LLM Judge 또는 외부 Supervision 없이 Action과 Observation만으로 Trajectory에서 직접 추출됩니다. 추출된 Pair들을 사용하여 Policy πθ는 Direct Preference Optimization (DPO)를 통해 Reference Policy πref에 비해 Chosen Action을 Rejected Action보다 선호하도록 훈련됩니다.
DeLoop는 CodeGym 벤치마크에서 Qwen3-8B 에이전트가 4,096 토큰 Summarization 환경에서 57.3%에 달했던 Loop Rate를 6.1%로 9.4배 감소시키는 탁월한 성능을 보였습니다. 이는 다른 어떤 Baseline 방법론보다 낮은 Loop Rate이며, 동시에 Task Success는 유지하면서 상호작용 비용을 크게 줄였습니다. 구체적으로, 평균 Steps per task는 15.00에서 4.67로 감소했고, Tokens per task는 47% 줄어들어 모든 평가 방법 중 가장 효율적인 결과를 달성했습니다 [Table 1]. DeLoop의 효과는 모델 스케일링에서도 일관되게 나타났습니다. Qwen3-14B에서는 Loop Rate를 3.5배, Qwen3-32B에서는 3.0배 감소시켰으며, 특히 Task Success를 Qwen3-14B에서 45.1%에서 52.3%로, Qwen3-32B에서 37.7%에서 44.8%로 크게 향상시켰습니다 [Figure 5]. Ablation Study를 통해 Loop-Breaking Action과 Looping Action 간의 Contrast가 필수적이며, 단순히 Loop-Breaking Action만 모방하는 SFT(Supervised Fine-Tuning)는 37.7%의 높은 Loop Rate를 보인다는 점이 확인되었습니다. 또한, ALFWorld, Open-AgentRL, Terminal-Bench 등 다른 에이전트 환경에서 추출한 Cross-Domain Pair를 추가한 DeLoop-Mix는 Qwen3-8B의 Task Success를 25.1%에서 30.3%로 더욱 높였습니다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Context Compression을 사용하는 Long-Horizon Agents에서 반복적인 Action, 즉 "Loop"가 발생하는 문제에 대한 효과적인 해결책으로 DeLoop를 제시합니다. DeLoop는 에이전트 자신의 실패 Trajectory에서 Loop를 Self-Supervised Signal로 활용하여, Loop-Generating Action과 Loop-Breaking Action을 Pair로 구성하고 Direct Preference Optimization (DPO)를 통해 Policy를 훈련합니다. 이 방법론은 CodeGym을 비롯한 다양한 벤치마크에서 Qwen, Llama, Gemini 모델들의 Loop Rate를 9.4배까지 감소시키고, Steps per task 및 Tokens per task와 같은 상호작용 비용을 크게 줄이는 동시에 Task Success를 유지하거나 향상시켰습니다. DeLoop의 중요한 시사점은 외부의 Gold Answer, LLM Judge, 또는 보상 신호 없이 에이전트의 자체 경험에서 가치 있는 Supervison을 추출하여 Policy를 개선할 수 있음을 입증한 것입니다. 이는 LLM Agents의 효율성과 신뢰성을 크게 향상시킬 수 있는 확장 가능하고 견고한 접근 방식을 제공하며, 학계 및 산업계 모두에서 더욱 자율적이고 유능한 AI 시스템 개발에 기여할 것으로 기대됩니다.
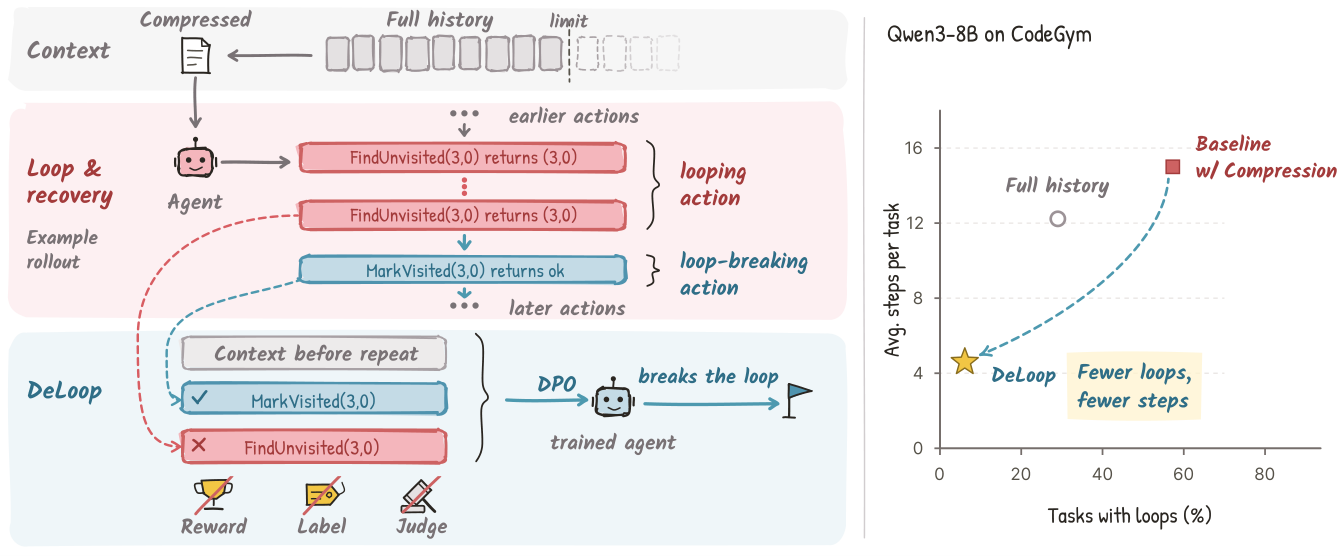
Figure 1 — DeLoop 훈련 및 주요 결과
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Asking for What Was Never Requested: Horizontal and Vertical Proactivity in Agents
- [논문리뷰] Which Agent's Skill Should Change? Group-Relative Credit Assignment for Evolving Multi-Agent Teams
- [논문리뷰] BizBench: Unveiling Hidden Challenges in Deploying Long-Horizon Agents for Real-World Business
- [논문리뷰] Harness-Zero: Harness Distillation via Agent-as-Harness
- [논문리뷰] CaSKG: Counterfactual-Causal Skill Graphs for Scalable Agent Skill Retrieval
Review 의 다른글
- 이전글 [논문리뷰] DONIC: Generalist Dexterous Bimanual Tracking Control from Human Demonstrations
- 현재글 : [논문리뷰] DeLoop: Repeated Actions as Self-Supervision for Long-Horizon Agents
- 다음글 [논문리뷰] Design Anything, Design at Scale
댓글