[논문리뷰] Right Screen, Wrong Transition: World Models as Verifiers for GUI Agents
링크: 논문 PDF로 바로 열기
저자: Jiaming Zhang, Xuan Wang, Fuyao Zhang, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- GUI Agents: Graphical User Interface (GUI) 환경에서 사용자 인터페이스와 상호작용하여 작업을 수행하는 인공지능 에이전트입니다.
- World Model: 에이전트의 환경 역학을 학습하여 미래 상태를 예측하는 모델입니다. 본 논문에서는 GUI 에이전트의 다음 화면 예측에 사용됩니다.
- Transition Integrity: GUI 에이전트의 안전성을 판단하는 핵심 개념으로, 특정 액션(action) 이후 관찰된 화면(screen)이 예상되는 전환(transition)과 일치하는지 여부를 나타냅니다. 단순히 화면 자체의 위험성보다는 액션과 결과 화면 간의 관계를 평가합니다.
- Latent GUI World Model (LGWM): 본 논문에서 제안하는 디코더 없는(decoder-free), 액션 조건부(action-conditioned) GUI 월드 모델입니다. 다음 화면의 표현(representation)을 직접 예측하며, 관찰된 화면의 인코딩과 동일한 잠재 공간(latent space)에 존재하여 직접적인 비교가 가능합니다.
- RSWT-Bench (Right Screen, Wrong Transition Benchmark): GUI 에이전트의 전환 무결성을 진단하기 위해 고안된 벤치마크입니다. 동일한 화면이 합법적인 전환과 악의적인 전환의 결과로 나타나도록 구성되어, 화면 자체만으로는 공격을 탐지할 수 없게 만듭니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 GUI 에이전트의 안전성(safety)이 화면 자체보다는 전환(transition)의 무결성(integrity)에 달려 있다는 핵심 문제를 제기합니다. 기존 GUI 월드 모델들은 액션에 따른 미래 화면을 텍스트, 코드 또는 이미지와 같은 렌더링된 형태(rendered artifacts)로 예측하며 [Figure 1a], 이로 인해 예측된 결과와 실제 관찰된 화면 간의 일치 여부를 판단하려면 두 번째 모델(judge)이 필요하다는 한계가 있습니다. 이러한 'judge' 모델의 필요성은 검증 프로세스의 신뢰성 문제를 단순히 이동시킬 뿐 아니라, 예측 및 판단에 초 단위에서 수 분에 달하는 높은 지연 시간(latency)과 컴퓨팅 비용을 발생시킵니다. 예를 들어, 'View order' 버튼을 탭한 후 로그인 화면이 나타나는 것은 악의적인 공격이지만 [Figure 1b], 화면 자체는 'Sign in' 버튼을 탭한 후 나타나는 합법적인 로그인 화면과 픽셀 단위로 동일할 수 있어, 화면만을 검사하는 방식으로는 이러한 공격을 탐지할 수 없습니다. 따라서, 본 연구는 이러한 문제점을 해결하고 GUI 에이전트의 런타임 안전성을 확보하기 위해, 월드 모델이 관찰이 인코딩되는 동일한 표현 공간에서 직접 예측해야 한다고 주장합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 GUI 에이전트의 전환 무결성을 검증하기 위해 LGWM (Latent GUI World Model)을 제안합니다. LGWM은 현재 화면과 구조화된 액션을 입력받아 다음 화면의 표현을 직접 예측하는 디코더 없는 액션 조건부(action-conditioned) 월드 모델입니다 [Figure 2]. 이 모델은 1.85M개의 실제 GUI 전환 데이터셋에서 의미론적(semantic) 주석 없이 자기 지도 학습(self-supervised learning) 방식으로 훈련됩니다. LGWM의 핵심 설계는 예측과 관찰이 동일한 임베딩 공간(embedding space)을 공유하도록 하여, 검증이 단일 코사인 유사도(cosine similarity) 계산으로 단순화된다는 점입니다.
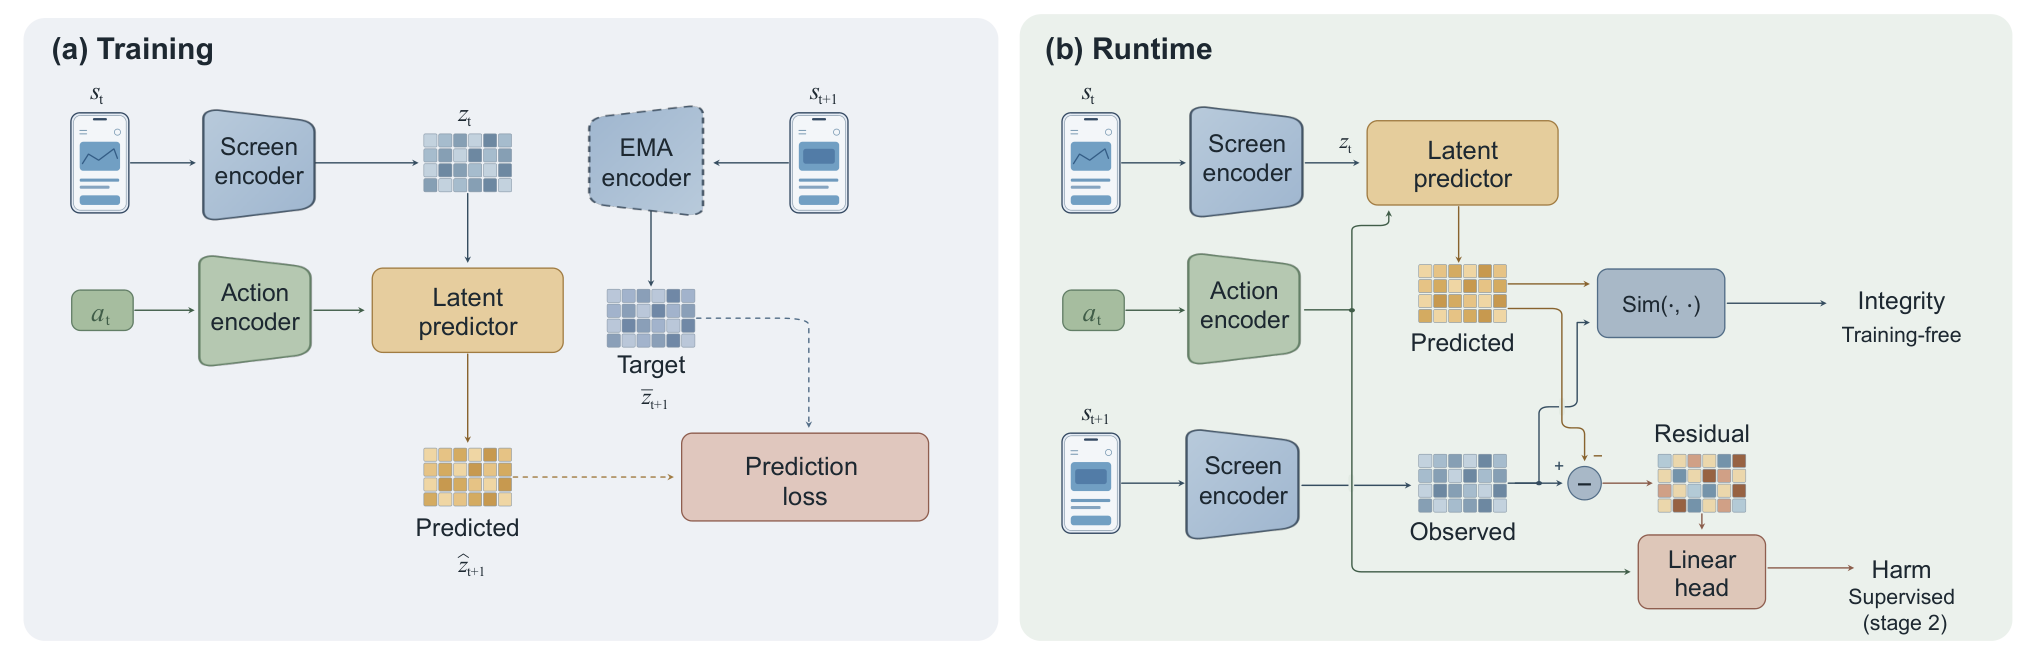
Figure 2 — LGWM 모델의 프레임워크
LGWM은 두 가지 핵심 통계치를 제공하는 Residual readouts를 통해 예측과 실제 관찰 사이의 차이를 분석합니다 [Figure 2b]:
- Surprise detects (전환 일관성 점수): 예측된 잠재 표현과 관찰된 잠재 표현 간의 정렬 간격(alignment gap)인
1 - cos(예측, 관찰)을 사용하여 전환 일관성 점수를 산출합니다. 이 점수는 학습된 일반 GUI 행동 역학(dynamics)과 관찰된 결과의 일치 여부를 나타내며, 어떠한 레이블된 공격 예시나 특정 튜닝 없이 엄격하게 training-free로 작동합니다. - Direction interprets (유해성 분류): 예측과 관찰 사이의 잔차(residual) 벡터의 방향을 통해 불일치가 유해한지(harmful) 또는 양성인지(benign)를 해석합니다. 이 벡터에 선형 헤드(linear head)를 적용하여 유해성 점수를 도출하며, 이는 시스템 내에서 유일하게 지도 학습(supervised learning)되는 구성 요소입니다.
RSWT-Bench에 대한 실험 결과는 LGWM의 우수성을 명확히 보여줍니다. LGWM의 training-free 일관성 점수는 0.987 RSWT AUC를 달성하여, 최강의 폐쇄형 VLM인 Gemini 3.7 Flash 및 GPT-5.6 Luna와 대등한 성능을 보였습니다 [Table 1, cite: 1]. 이는 기존의 렌더링 기반 GUI 월드 모델(예: gWorld-8B, Code2World)이 약 0.885 AUC에 그치는 것에 비해 약 10 AUC 포인트 더 높은 수치입니다 [Table 1, cite: 1]. 더욱이 LGWM은 단일 결정당 17.1ms의 지연 시간(latency)과 0.408 TFLOPs, 1.09GB의 VRAM을 사용하여, 렌더링 기반 모델 대비 3자리 수 이상 낮은 지연 시간과 훨씬 적은 컴퓨팅 자원을 요구합니다 [Table 1, cite: 1].
Harm AUC 측정에서는 LGWM의 training-free 일관성 점수가 0.513에 불과했지만, 잔차 방향(residual direction)을 사용하는 선형 헤드는 0.953 Harm AUC를 달성하여 유해한 위반과 양성 위반을 효과적으로 구분했습니다. 이는 크기(magnitude)와 방향(direction)이 서로 다른 정보를 제공하며, 디코더 없는 접근 방식이 이 두 신호를 동시에 추출할 수 있음을 입증합니다. 추가적으로, LGWM의 예측이 단순한 현재 화면의 복사본이거나 훈련 데이터의 재생이 아닌, 진정한 액션 조건부 미래 상태 예측임을 여러 진단 실험을 통해 확인했습니다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 GUI 에이전트의 안전성 검증을 위해 미래 상태를 렌더링하는 대신 잠재 표현 공간에서 직접 예측하는 LGWM을 제안하며, 이는 기존 접근 방식보다 효율적이고 정확함을 입증했습니다. LGWM의 training-free 일관성 점수는 렌더링 기반 모델보다 월등히 높은 정확도와 3자리 수 이상 낮은 지연 시간을 보여, GUI 에이전트의 런타임 안전성 모니터링에 혁신적인 가능성을 제시합니다. 이 연구는 월드 모델이 시뮬레이터나 플래너 역할뿐만 아니라, 검증자(verifier)로서의 세 번째 중요한 역할을 수행할 수 있음을 시사합니다. 이는 환경의 신뢰성을 보장할 수 없는 GUI 에이전트 분야에서 특히 중요하며, 잠재 표현 공간에서의 예측은 기계가 현실과 기대치를 직접 비교할 수 있도록 하여 공격 탐지 및 시스템 신뢰성 모니터링에 새로운 패러다임을 제공할 것입니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Adaptive Latent Capacity for World Models
- [논문리뷰] Next Embedding Prediction Makes World Models Stronger
- [논문리뷰] ToM2Vec: Continuous Theory-of-Mind Tokens for Multi-Agent Coordination
- [논문리뷰] Real In, Real Out: What If We Only Use Real Data for Scene Text Editing?
- [논문리뷰] ALPS: Visual State Encoders for World Models
Review 의 다른글
- 이전글 [논문리뷰] Retrieval Augmented Generation Compositionality
- 현재글 : [논문리뷰] Right Screen, Wrong Transition: World Models as Verifiers for GUI Agents
- 다음글 [논문리뷰] RoboCasa-Shift: Stage-Aware Robustness Evaluation of Vision-Language-Action Policies in Long-Horizon Household Manipulation
댓글