[논문리뷰] ALPS: Visual State Encoders for World Models
링크: 논문 PDF로 바로 열기
저자: Yanqing Liu, Letian Zhang, Chengzhi Liu, Zijun Wang, Jieru Mei, Hongliang Fei, Yuyin Zhou, Cihang Xie
1. Key Terms & Definitions (핵심 용어 및 정의)
- World Model: 환경의 변화를 예측하고 이를 기반으로 행동을 계획하는 데 사용되는 인공지능 모델입니다.
- Visual State Encoder: 시각적 입력(예: 이미지, 비디오)으로부터 환경의 물리적 상태에 대한 정보를 효율적으로 추출하는 신경망 구성 요소입니다.
- Language Alignment: 시각적 표현이 자연어 명령, 설명 또는 목표와 일관성 있게 정렬되어 의미론적 이해를 가능하게 하는 능력입니다.
- Pixel Reconstruction: 인코더가 압축된 잠재 표현(latent representation)에서 원본 입력 이미지의 픽셀 정보를 정확하게 재구성하는 능력입니다.
- Cross-View Self-Distillation: 동일한 객체의 다양한 시점(view)에서 얻은 데이터 간의 일관성을 통해 모델이 스스로 학습하고 표현을 개선하는 자기 지도 학습(self-supervised learning) 기법입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
World Model의 시각적 기초는 물리적 상태 정보, 원어민 언어 정렬(native language alignment), 그리고 픽셀 재구성(pixel reconstruction)을 단일 표현으로 통합해야만 예측, 지침, 및 검사(inspection)와 같은 다면적인 기능을 효과적으로 지원할 수 있다. 그러나 기존의 공개 인코더들은 일반적으로 이러한 세 가지 핵심 능력 중 한두 가지에만 전문화되어 있다는 근본적인 한계에 직면해 있다. 예를 들어, DINOv2나 C-RADIOv3와 같은 Self-supervised 모델은 전이 가능한 공간 피처를 제공하지만, 언어 정렬이나 픽셀 재구성 능력은 부족한 경우가 많다. 반대로 CLIP이나 SigLIP 2와 같은 Image-text 인코더는 강력한 Language Alignment를 보이지만, 물리적 상태 정보 인코딩이나 세밀한 픽셀 재구성에서 약점을 보인다. 특히, Image-text 인코더의 상태 정보를 개선하기 위한 정제(refinement) 과정은 종종 언어 정렬 성능을 크게 저하시킬 수 있어, 이러한 복합적인 요구사항을 단일 시각적 인코더로 충족시키기 위한 새로운 접근 방식의 필요성이 제기된다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 물리적 상태 정보, 언어 정렬 및 픽셀 재구성을 단일 패치 토큰 세트로 통합하는 사전 학습된 Visual State Encoder인 ALPS를 제안한다. ALPS는 이러한 다중 목표의 긴장을 해소하기 위해 두 단계의 체계적인 Pretraining 방식을 활용한다 [cite: 1, Figure 2].
첫 번째 단계(Stage 1)에서는 언어 정렬, 픽셀 재구성 및 공간 피처를 공유 표현으로 확립한다. 이는 ViT-B/16 모델을 Contrastive Alignment, Captioning, Reconstruction 및 Dense Correspondence Objective와 같은 네 가지 핵심 Objective를 사용하여 Image-text Pair 데이터에 대해 처음부터 학습함으로써 이루어진다 [cite: 1, Figure 2]. 두 번째 단계(Stage 2)에서는 Cross-view Self-distillation을 통해 상태 정보를 강화한다. 이 단계에서는 증강된 뷰(augmented view)에서 입력된 Student 인코더가 Frozen된 Stage 1 Teacher 인코더의 패치 토큰을 Clean View의 해당 위치에서 예측하도록 학습한다 [cite: 1, Figure 2]. 이 두 단계는 오직 정지 이미지와 텍스트만을 사용하여 비디오나 상호작용(interaction) Supervision 없이 진행된다.
제안하는 ALPS는 통합된 평가 프로토콜을 통해 탁월한 성능을 입증했다. ALPS는 ViT-B 모델 중 LIBERO State-Probe Error가 가장 낮으며 (0.829), 이는 3.5배 더 큰 V-JEPA 2-L과 동등한 수준이다 [cite: 1, Table 1]. 또한, ALPS는 강력한 Language Alignment를 유지하는데, Flickr30k Image-to-Text Recall@1에서 93.2, COCO Image-to-Text Recall@1에서 70.2를 달성했다 [cite: 1, Table 1]. Pixel Reconstruction 측면에서도 ALPS는 낮은 ℓ1 error (0.120)와 LPIPS (0.372)를 기록하여, 픽셀 재구성을 명시적으로 학습하지 않은 다른 모든 인코더보다 우수한 성능을 보였다 [cite: 1, Figure 4, Table 1]. Downstream Task에서, Frozen된 ALPS 토큰은 Native Text Tower와 결합 시 LIBERO에서 가장 높은 평균 Policy Success (85.5%)를 달성했으며 [cite: 1, Table 2], PushT, Wall, Granular 벤치마크 전반에 걸쳐 World-Model Planning에서 선도적인 인코더와 동등하거나 그 이상의 성능을 입증했다 [cite: 1, Table 3]. 더욱이, 예측된 미래 토큰은 Visual Inspection을 위해 직접 픽셀로 디코딩될 수 있어 [cite: 1, Figure 6], World Model의 상상된 미래를 시각적으로 확인하는 데 유용성을 제공한다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 ALPS를 통해 단일 Frozen Visual Representation이 경쟁력 있는 물리적 상태 정보, Native Language Alignment, 그리고 정확한 Pixel Reconstruction을 성공적으로 통합할 수 있음을 명확히 보여준다. 특히, Cross-view Refinement 전략은 인코더의 State Representation 능력을 효과적으로 강화하면서도 Language 및 Pixel 인터페이스의 성능을 성공적으로 보존했다. 동일한 ALPS 토큰이 Robot Control, World-Model Prediction 및 Planning, 그리고 예측된 장면의 Visual Inspection에 모두 활용될 수 있다는 점은 이 연구의 중요한 시사점이다. 이러한 결과는 Visual State Pretraining이 World Model 분야에서 이해(understanding), 예측(prediction), 행동(action)을 위한 강력하고 공유 가능한 Visual Foundation이 될 수 있음을 시사하며, 이는 로봇 정책(robot policies) 및 World Model 연구 발전에 큰 영향을 미칠 것으로 기대된다.
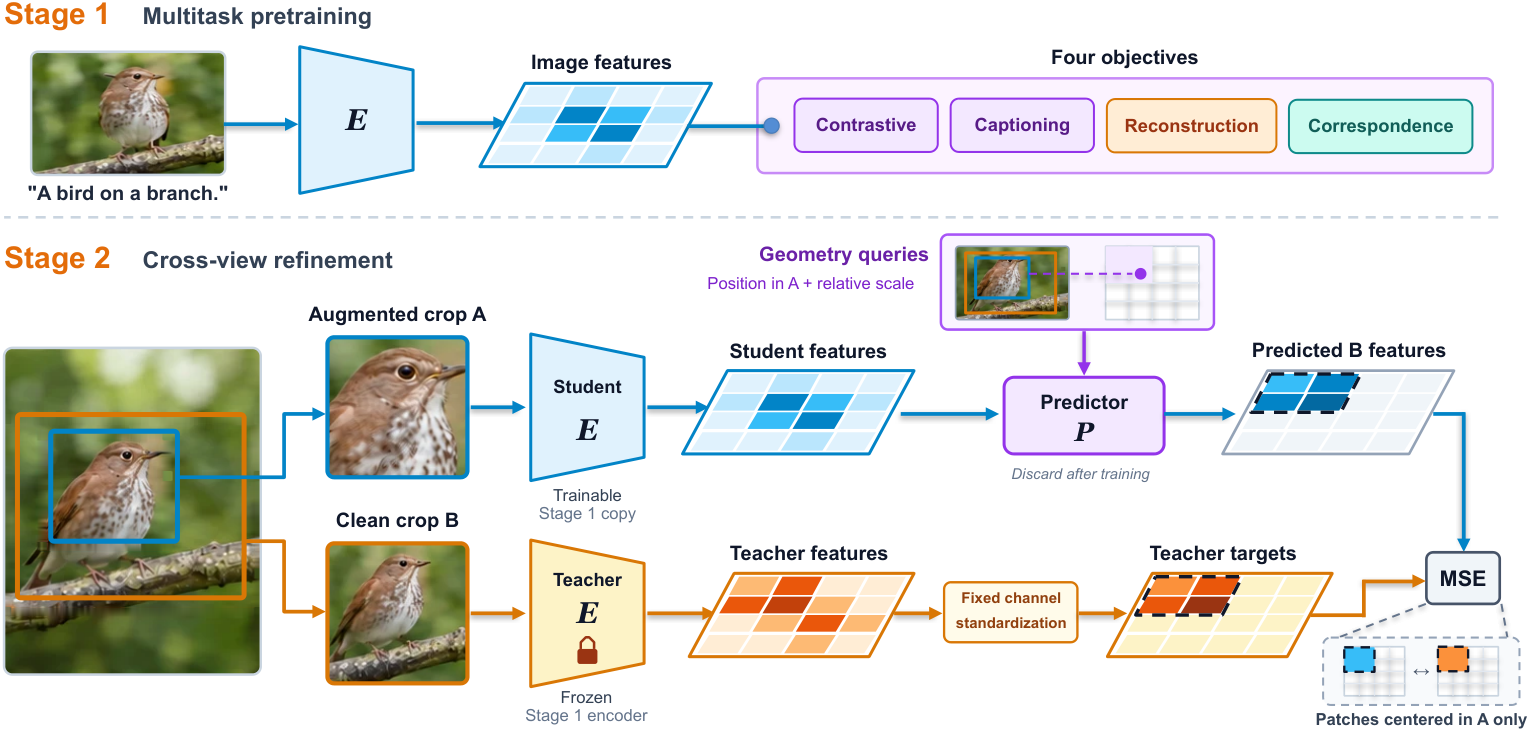
Figure 2 — 두 단계 시각 상태 사전 학습
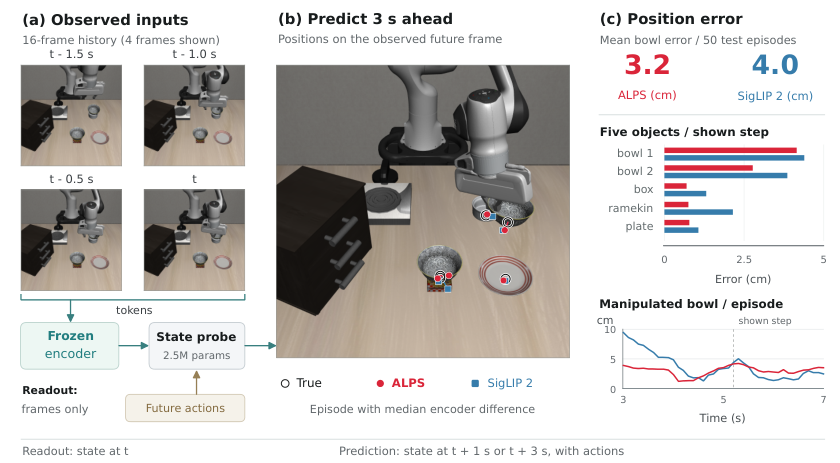
Figure 3 — LIBERO 상태 프로브
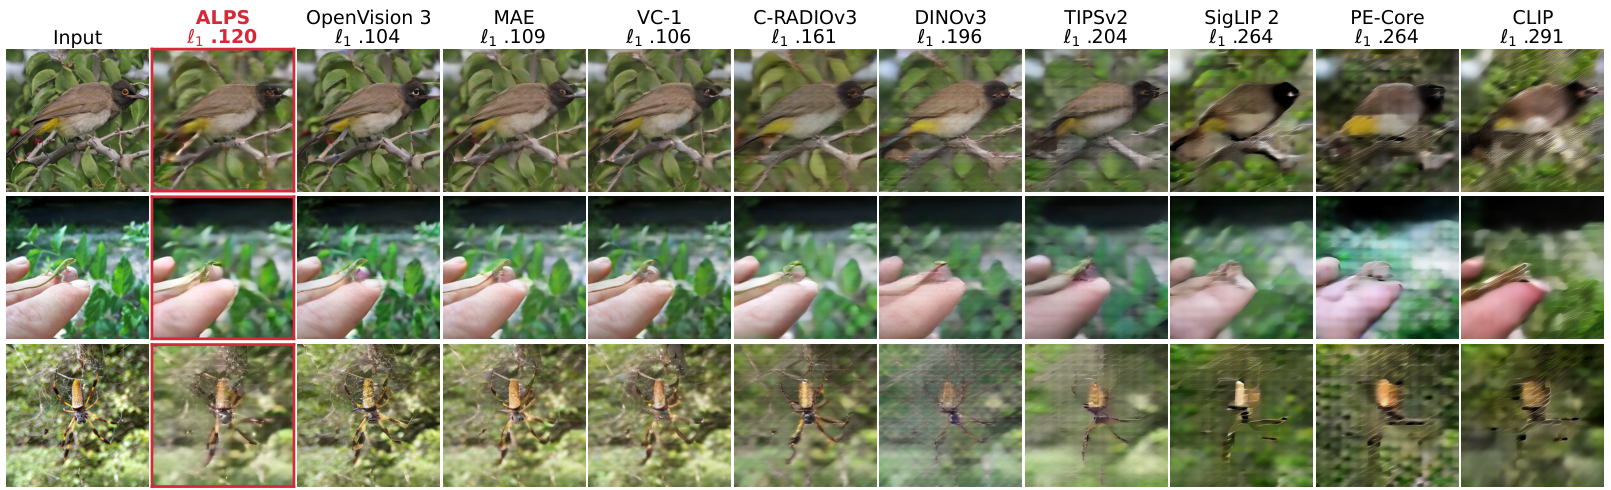
Figure 4 — Frozen 토큰 재구성 결과
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] RISE: Self-Improving Robot Policy with Compositional World Model
- [논문리뷰] DONIC: Generalist Dexterous Bimanual Tracking Control from Human Demonstrations
- [논문리뷰] Towards Agentic Robots: Model, Data, Environment, and Harness
- [논문리뷰] From Pretraining to Proficiency: Real-World Subtask RL for Long-Horizon Manipulation with Minimal Human Intervention
- [논문리뷰] WorldReward: Reward Modeling for Camera-Conditioned World Models
Review 의 다른글
- 이전글 [논문리뷰] ACE-Brain-0.6: Scaling Spatial Grounding for Physical Foundation Models
- 현재글 : [논문리뷰] ALPS: Visual State Encoders for World Models
- 다음글 [논문리뷰] Agent World Model in the Wild: Computer-Use Agent Environment Synthesis
댓글