[논문리뷰] RubatoCodec: Budgeted Adaptive Speech Tokenization with Streaming Decoding
링크: 논문 PDF로 바로 열기
저자: Chihiro Arata, Shohei Taniguchi, Gouki Minegishi, Kan Hatakeyama-Sato
1. Key Terms & Definitions (핵심 용어 및 정의)
- Adaptive Firing: 신호 변화량(Latent dissimilarity 및 Waveform spectral flux)을 기반으로 음성 신호를 가변 길이의 이벤트로 분할하는 RubatoCodec의 핵심 메커니즘입니다.
- Event-level Budget: 전체 발화의 총 이벤트 수를 고정하여 가변 프레임 레이트 환경에서도 시퀀스 길이를 예측 가능하게 제어하는 기법입니다.
- Hybrid Residual Quantization: 16개의 Residual VQ 레이어를 사용하여 음성 정보를 계층적으로 양자화하고, 12비트의 고정 폭 인덱스를 생성하는 양자화 구조입니다.
- Streaming Decoding: 이벤트별로 코드를 할당하고 명시적인 지속 시간(Duration)을 제공함으로써, 전체 발화를 기다릴 필요 없이 증분적(Incremental)으로 오디오를 합성하는 디코딩 방식입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존 가변 프레임 레이트(VFR) 코덱이 겪는 가변적인 시퀀스 길이 문제와 그로 인한 생성 모델의 최적화 어려움을 해결하고자 합니다. 기존의 Threshold-based 할당 기법은 음성 콘텐츠에 따라 프레임 수가 달라지므로, 생성 모델 입장에서는 발화 길이를 사전에 예측하기 어렵습니다. 또한, 기존 코덱들은 고정 그리드 기반으로 인해 급격한 음성 전환 구간과 정적인 휴지기를 효율적으로 분리하지 못하는 비효율성을 보입니다. RubatoCodec은 이러한 의존성을 제거하여 오디오 길이에 따라 시퀀스 길이를 명확히 결정할 수 있는 새로운 접근 방식을 제안합니다 [Figure 1].
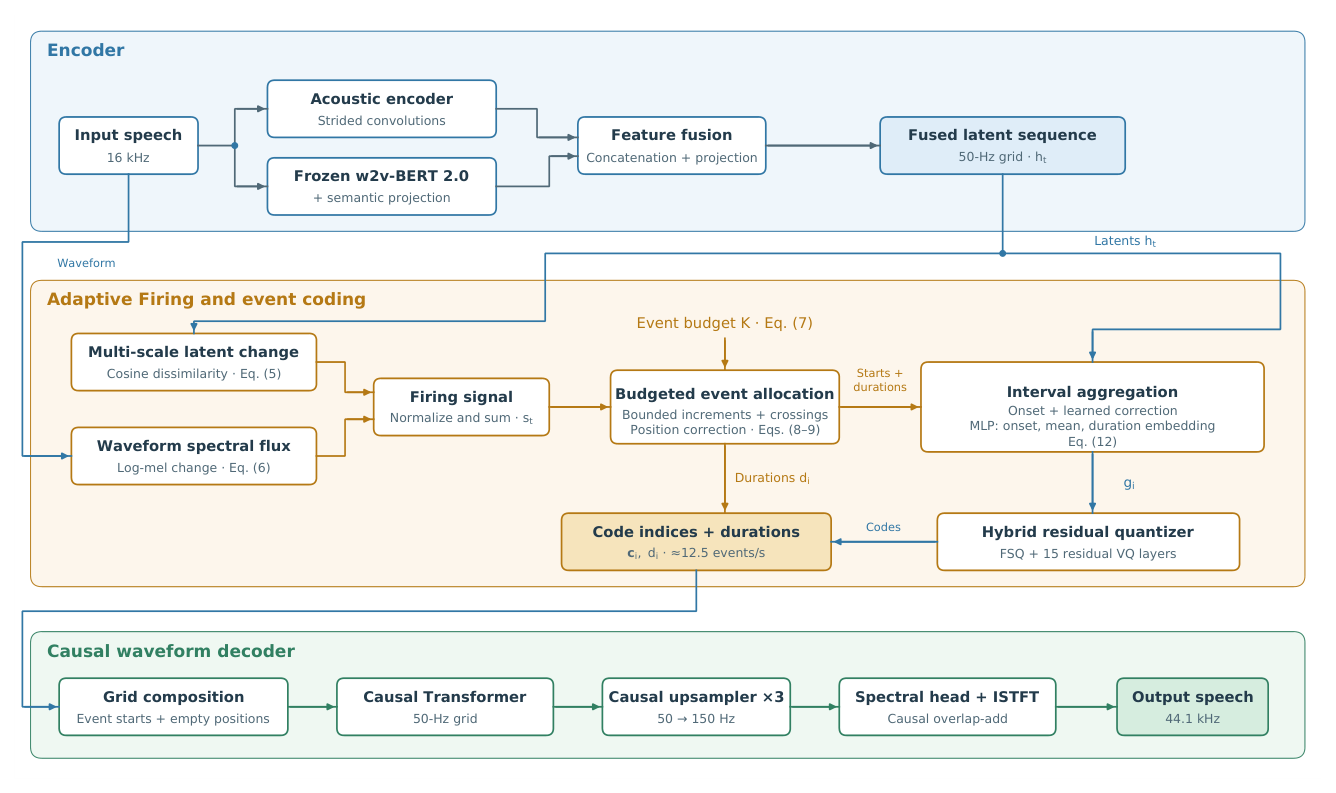
Figure 1 — 전체 모델 아키텍처 및 Adaptive Firing 메커니즘을 설명하는 핵심 다이어그램
3. Method & Key Results (제안 방법론 및 핵심 결과)
RubatoCodec은 Adaptive Firing을 통해 음성을 가변 지속 시간의 이벤트로 분할하고, 이벤트별로 명시적인 코드와 지속 시간을 생성하여 디코딩의 효율성을 극대화합니다. 제안 모델은 X-Codec-2의 인코더/디코더 백본을 유지하면서, latent 변화와 spectral flux를 결합한 firing signal을 사용하여 별도의 boundary predictor 없이도 정확한 이벤트 할당을 수행합니다. 실험 결과, RubatoCodec은 고정 레이트 코덱 대비 낮은 이벤트 레이트에서도 우수한 재구성 품질을 보였습니다 [Table 6]. 특히, LibriSpeech 및 VCTK 벤치마크에서 기존 코덱들보다 뛰어난 Intelligibility(dWER 지표 기준)를 기록하였으며, UTMOSv2 및 DNSMOS 지표에서도 높은 품질을 달성했습니다 [Table 10]. 정량적 비교에서 depth 16 모델 기준 0.50%의 dWER을 기록하며 매우 경쟁력 있는 성능을 입증하였습니다.
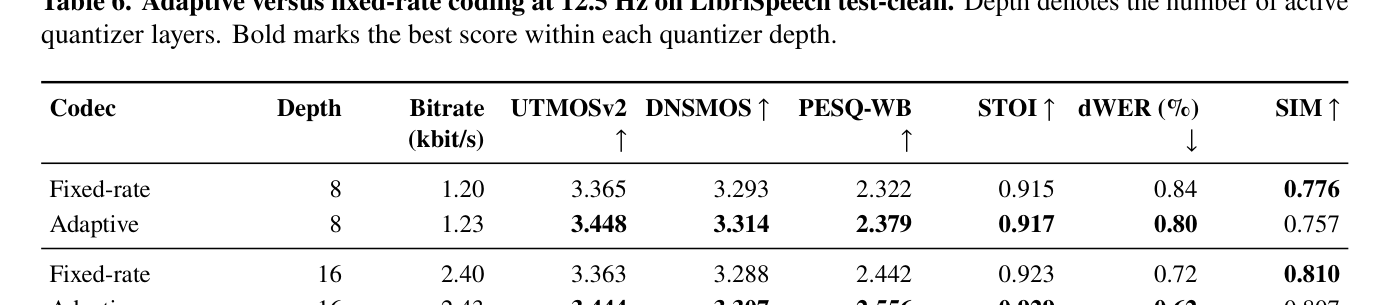
Table 6 — 제안 모델과 기존 방식 간의 정량적 품질 비교를 나타내는 주요 테이블
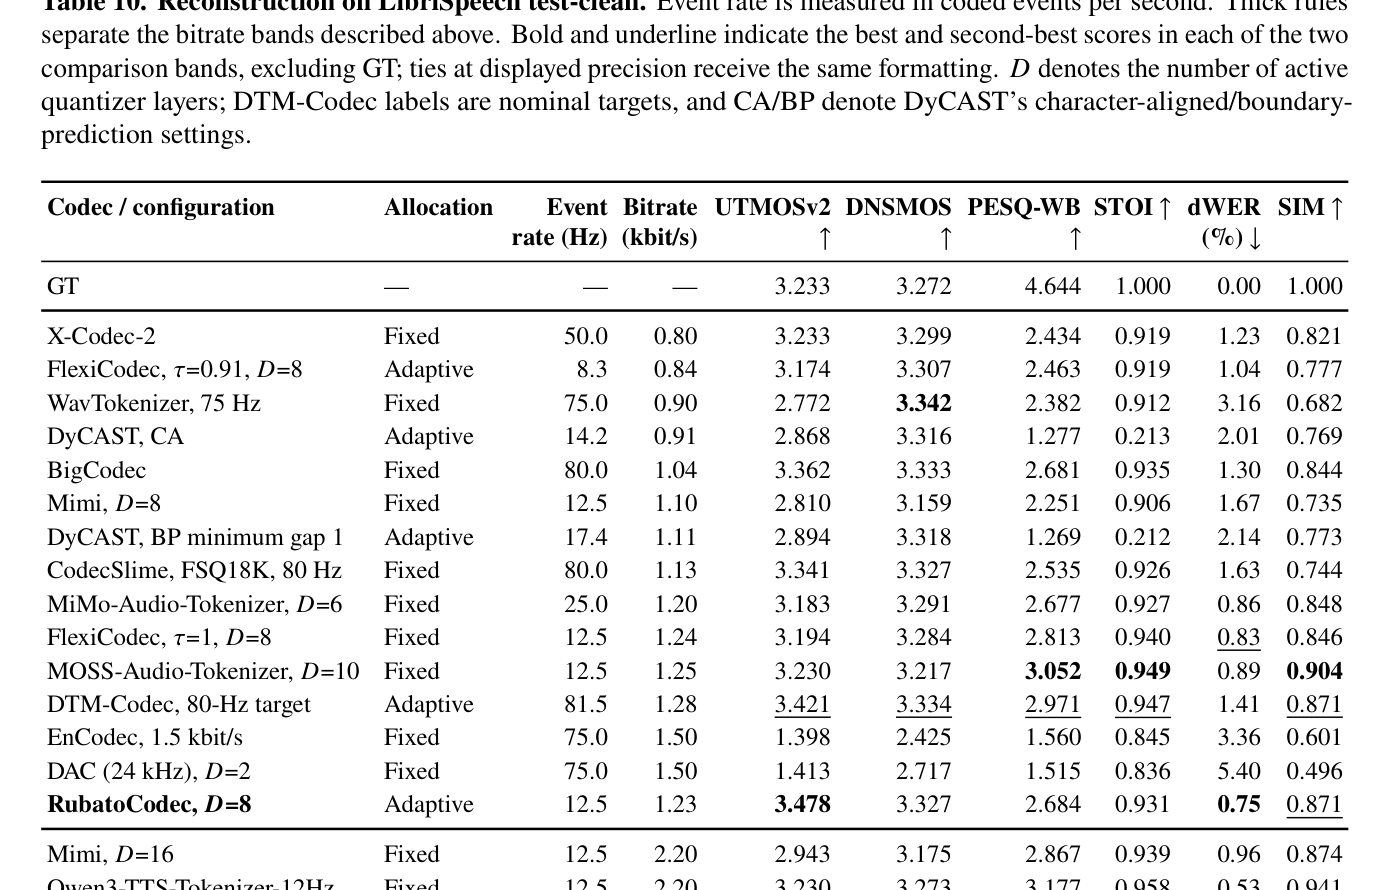
Table 10 — 다양한 외부 코덱 베이스라인과 제안 모델의 복원 품질 성능 비교 테이블
4. Conclusion & Impact (결론 및 시사점)
본 논문은 가변 프레임 레이트 음성 코딩 분야에서 이벤트 수준의 예산 제약을 도입하여, 높은 복원 품질과 예측 가능한 시퀀스 길이를 동시에 확보하는 RubatoCodec을 제안했습니다. 이 연구는 단순히 복원 품질만을 향상시키는 것에 그치지 않고, 제안된 코덱 인터페이스가 다운스트림 모델인 TTS 생성을 위한 최적의 토큰화를 지원함을 입증했습니다. 특히, 생성 모델이 별도의 속도 제한(rate constraint) 없이도 코드와 지속 시간을 학습할 수 있음을 보임으로써, 고품질 스트리밍 음성 생성 시스템 구축을 위한 새로운 표준을 제시했습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Realtime-Venus: A full-duplex interaction system with asynchronous delegation
- [논문리뷰] FlexiSLM: A Dynamic and Controllable Frame Rate Spoken Language Model
- [논문리뷰] Qwen3-TTS Technical Report
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] WorldStream: Streaming Interactive 3D Worlds with Hierarchical Planning and Persistent State
Review 의 다른글
- 이전글 [논문리뷰] RoboCasa-Shift: Stage-Aware Robustness Evaluation of Vision-Language-Action Policies in Long-Horizon Household Manipulation
- 현재글 : [논문리뷰] RubatoCodec: Budgeted Adaptive Speech Tokenization with Streaming Decoding
- 다음글 [논문리뷰] Scaling in Games: Continued Pre-Training For Embodied Agents In Diverse Virtual Worlds
댓글