[논문리뷰] Beyond Watching and Searching: Benchmarking Agents for Video-centered Deep Research Reports
링크: 논문 PDF로 바로 열기
저자: Jiahao Meng, Qize Yang, Yuxuan Wang, Yunfei Chu, Wensi Dai, Jin Xu, Yunhai Tong
1. Key Terms & Definitions (핵심 용어 및 정의)
- Video-Centered Deep Research: 주어진 source video를 중심으로 외부의 multimodal evidence(웹페이지, 문서, 이미지 등)를 검색하고, 이를 통합하여 사용자의 의도에 맞는 상호작용 가능한 보고서를 생성하는 태스크를 의미합니다.
- OmniDR-Bench: 비디오 중심의 딥 리서치 에이전트를 평가하기 위해 설계된 벤치마크로, 50개의 다양한 과제와 6,414개의 세부 기준(criteria)으로 구성되어 있습니다.
- Omni Atomic Rubric Trees (Omni-ARTs): 보고서의 품질을 평가하기 위한 계층적 평가 구조로, 3개의 주요 차원, 23개의 진단적 방향, 그리고 구체적인 atomic binary criteria로 세분화됩니다.
- Audited Rubric Construction (ARC): 독립적인 증거 수집과 인간의 검토를 통해 Omni-ART의 기준과 평가 fact library를 구축하는 신뢰성 있는 벤치마크 생성 프레임워크입니다.
- Agent Harness: 에이전트의 계획 수립, 컨텍스트 관리, 도구 사용 및 실패 복구 등을 제어하는 실행 프레임워크를 뜻합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존 딥 리서치 벤치마크가 비디오를 핵심 출처로 사용하는 리서치 요구를 제대로 반영하지 못하고 있다는 문제의식에서 출발합니다. 기존의 텍스트 중심 리서치 에이전트는 멀티모달 비디오의 시공간적 맥락을 통합하는 능력이 부족하며, 비디오 대상 QA 벤치마크는 단답형 위주여서 종합적이고 추적 가능한 보고서 생성 역량을 평가하기 어렵습니다. [Figure 1] 연구진은 사용자가 비디오의 특정 시점을 찾고, 주장을 검증하며, 실제 의사결정을 내릴 수 있도록 돕는 실질적인 해결책이 필요하다고 판단합니다. 이를 위해 단순한 요약을 넘어 비디오와 외부 증거를 연계하는 체계적인 평가 프레임워크와 에이전트 워크플로우를 제안합니다. [Figure 2]
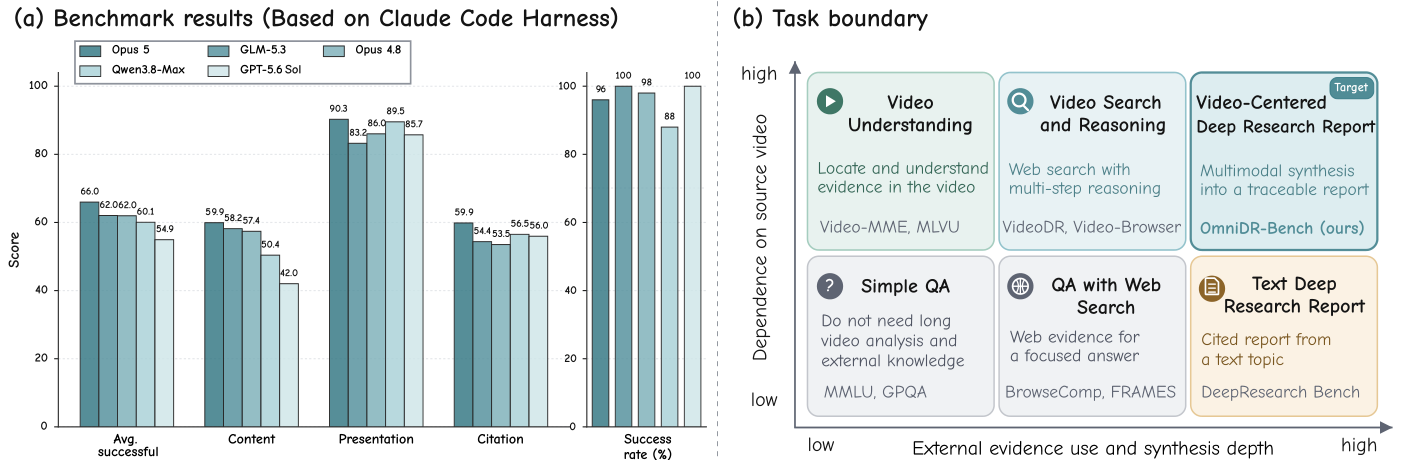
Figure 1 — 비디오 중심 딥 리서치 개념
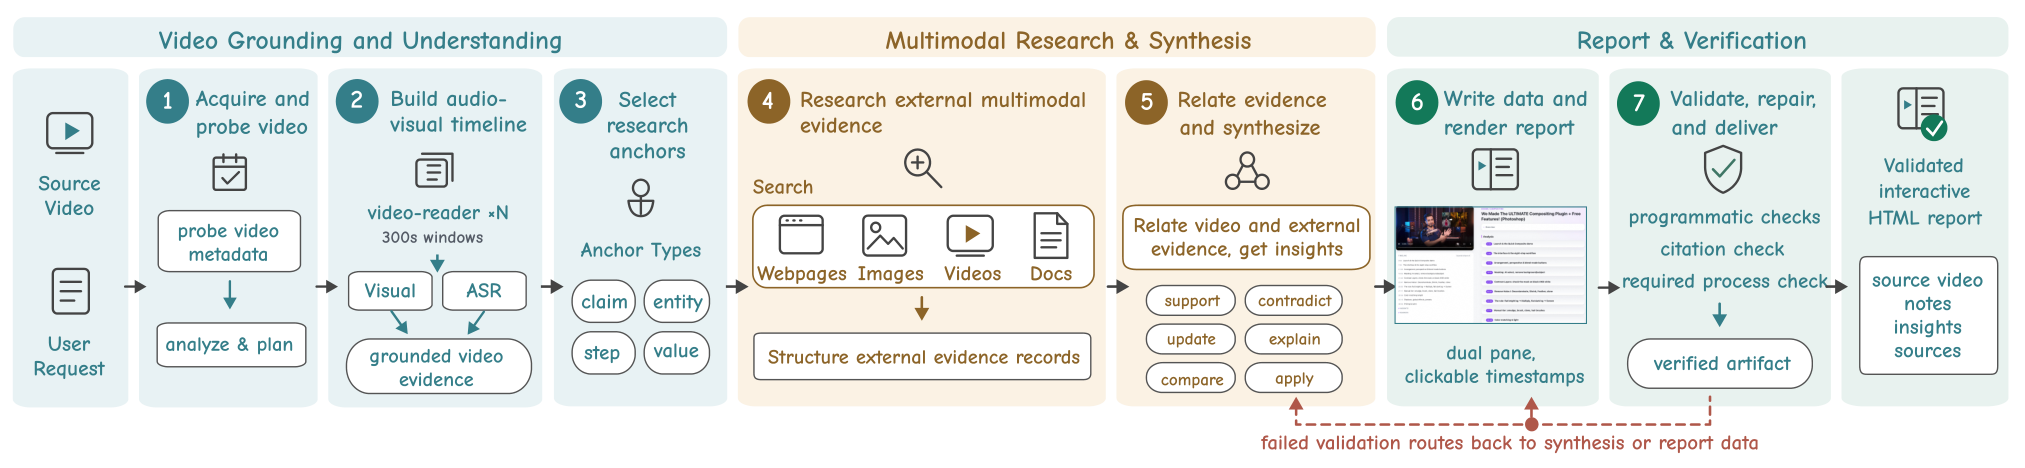
Figure 2 — 7단계 에이전트 워크플로우
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 비디오 기반의 리서치 과제를 7단계 워크플로우로 정의하고, 이를 평가하기 위한 OmniDR-Bench를 도입합니다. 제안된 방법론은 Audited Rubric Construction (ARC) 프로세스를 통해 구축된 Omni-ARTs를 활용하여, 보고서의 내용(Content), 인용(Citation), 그리고 프레젠테이션(Presentation)을 정밀하게 평가합니다. [Figure 3] [Figure 4] 주요 실험 결과에 따르면, 최신 에이전트 시스템(Claude Opus 5 기반)은 100점 만점에 63.3점을 기록하며 우수한 성능을 보였습니다. 실험 데이터는 프레젠테이션 점수(평균 81.8점)가 내용(45.4점)이나 인용(47.8점)보다 월등히 높음을 보여주며, 현재 에이전트들이 보고서 형식 유지에는 능숙하나 깊이 있는 추론 및 검증에는 한계가 있음을 시사합니다. [Table 3] 특히 인용(Citation)의 경우, 링크 수집 자체는 잘 수행하나 실제 주장과 증거를 연결하는 claim-support 능력이 매우 낮다는 정량적 사실을 확인했습니다.
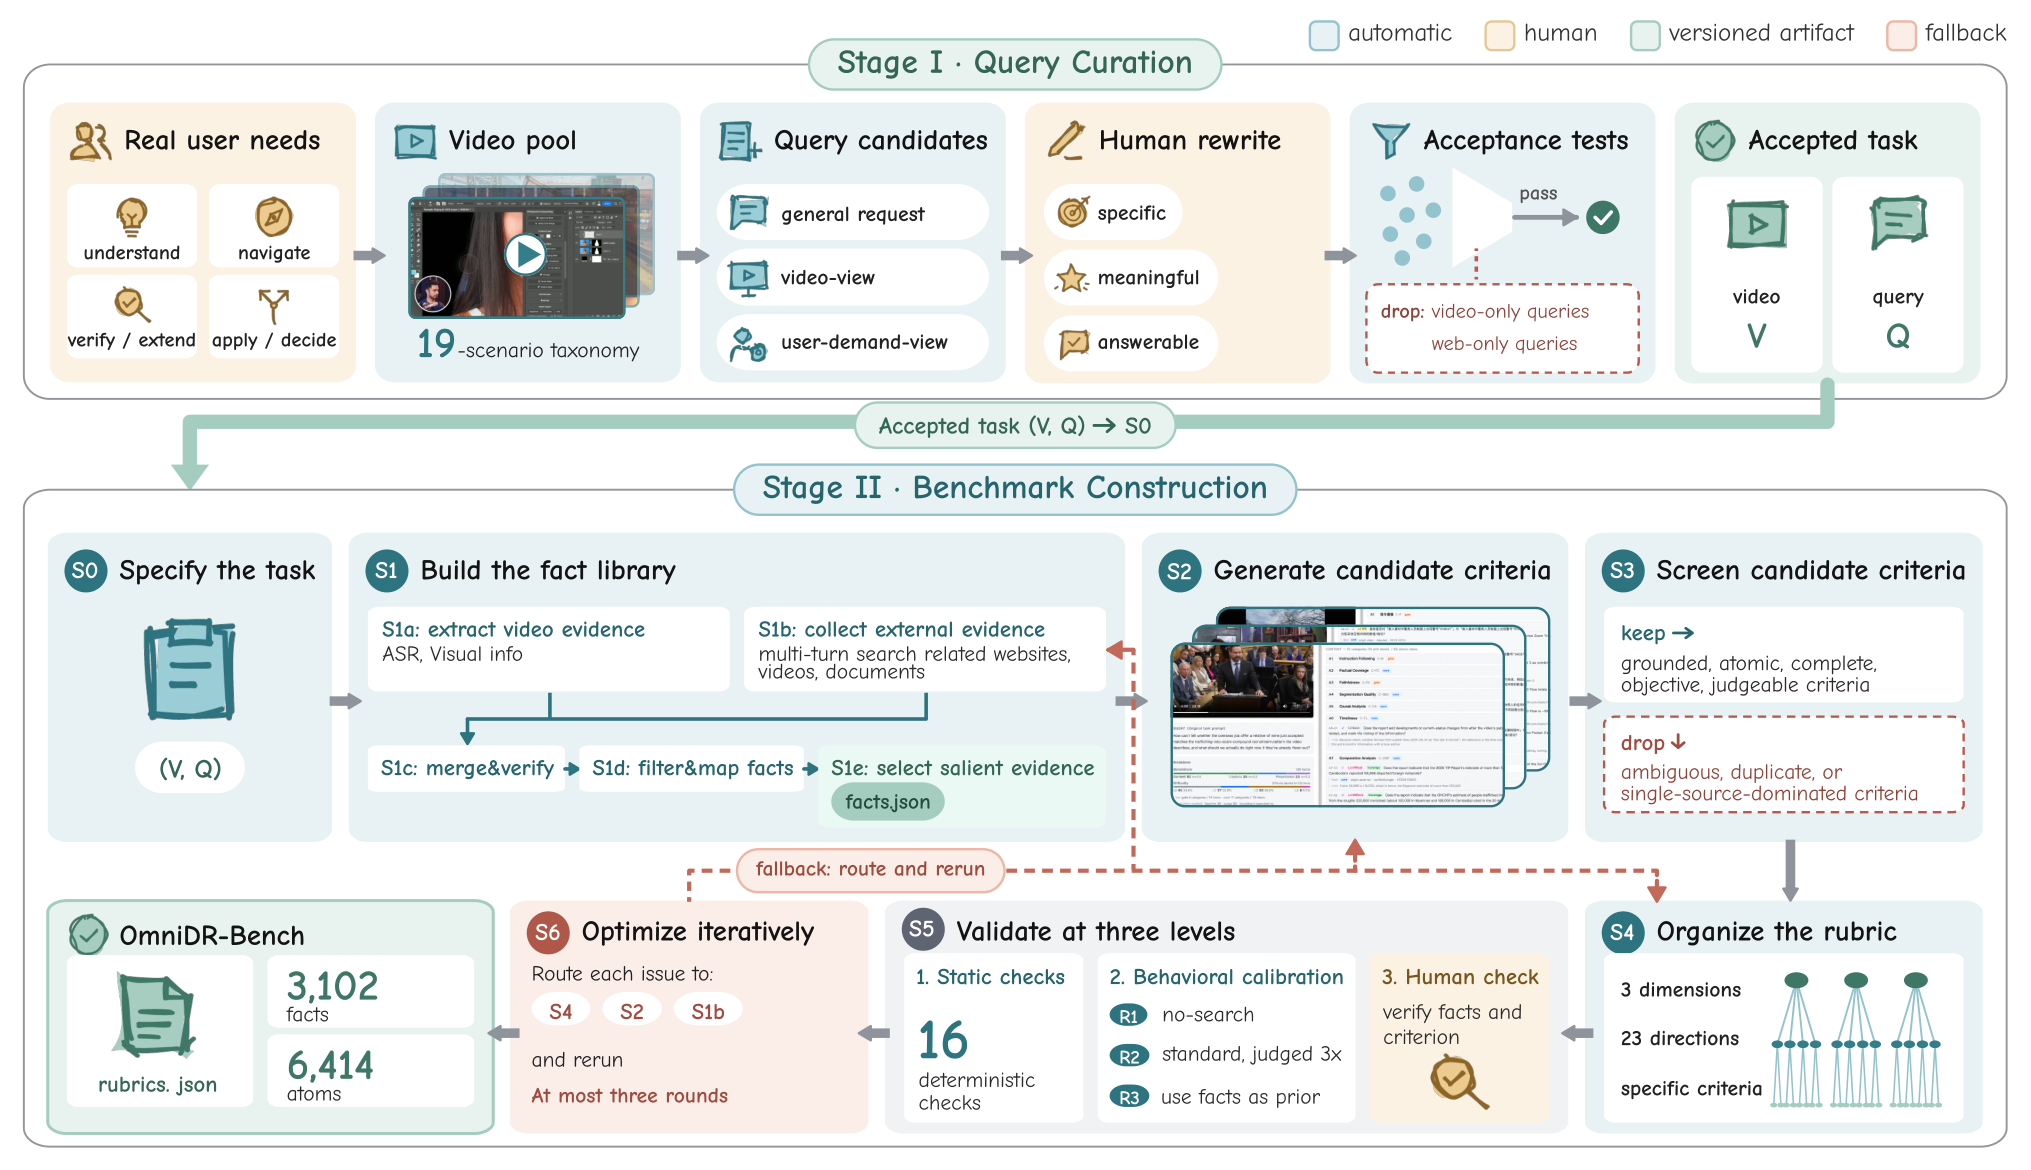
Figure 4 — ARC 구축 프로세스
4. Conclusion & Impact (결론 및 시사점)
본 연구는 비디오 중심의 딥 리서치라는 새로운 태스크를 정의하고 이를 평가하기 위한 표준 벤치마크와 평가 체계를 성공적으로 구축했습니다. 본 논문은 단순히 모델의 성능을 비교하는 것을 넘어, 에이전트가 비디오라는 복합적인 소스를 얼마나 정확하게 활용하고 외부 정보와 통합하는지에 대한 정밀한 가이드라인을 제공합니다. 이러한 연구는 향후 멀티모달 리서치 시스템이 보다 신뢰할 수 있고 상호작용 가능한 형태의 지식 전달 도구로 발전하는 데 기여할 것입니다. 저자들은 공개된 데이터와 코드를 통해 학계와 산업계가 비디오 기반 지능형 에이전트의 추론 능력을 고도화할 수 있는 토대를 마련했습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Beyond Monolingual Deep Research: Evaluating Agents and Retrievers with Cross-Lingual BrowseComp-Plus
- [논문리뷰] OpenVLHarness: Real World Visual Agentic Tool-Use with Multimodal Memory
- [논문리뷰] LIBERO-Industry: Benchmarking Robotic Manipulation under Industrial Process Constraints
- [논문리뷰] AnyGoal: On World Model Generalization Beyond Expert Rollouts
- [논문리뷰] AdaExploreBench: Benchmarking LLM Agents for Proactive Exploration and Test-time Adaptation in Evolving Environments
Review 의 다른글
- 이전글 [논문리뷰] AnyGameRenderer: Entity-Consistent Generative Rendering Across Games and an Entity-Level Benchmark
- 현재글 : [논문리뷰] Beyond Watching and Searching: Benchmarking Agents for Video-centered Deep Research Reports
- 다음글 [논문리뷰] BrickWright: Agentic Creation of Physically Feasible Brick Builds
댓글