[논문리뷰] RouteWeaver: Weaving Mode Selection and Execution into Unified LLM Routing
링크: 논문 PDF로 바로 열기
메타데이터
저자: Xiaohan Wang, Haozhen Zhang, Qingyuan Liu, Tao Feng, Wenya Wang
1. Key Terms & Definitions (핵심 용어 및 정의)
- Execution Paradigm: 단일 라운드, 다중 라운드, 에이전트 기반 라우팅과 같이 LLM 호출 및 정보 흐름을 구성하는 방식을 의미합니다.
- Unified Routing: 단일 LLM 정책 내에서 여러 Execution Paradigm을 선택하고 통합적으로 관리하는 체계입니다.
- COMET-GRPO: (COordinated Mode–Execution Training) 모드 선택과 모드 내부의 실행 결정 간에 각각 다른 상대적 우위(Advantage) 신호를 할당하여 학습 효율을 극대화하는 기법입니다.
- Progressive Exploration: 학습 초기 단계에서 외부적으로 강제된 모드를 사용하게 하여 충분한 실행 경험을 쌓게 한 뒤, 점진적으로 라우터가 자율적으로 모드를 선택하게 전환하는 학습 방식입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
기존의 LLM 라우팅 연구들은 주로 단일 라운드(single-round), 다중 라운드(multi-round), 혹은 에이전트(agentic)와 같이 고정된 Execution Paradigm 위주로 설계되어 있어, 쿼리의 특성에 따라 최적의 실행 구조를 스스로 적응시키지 못한다는 한계가 있습니다. 라우터가 어떤 모델을 사용할지는 결정할 수 있지만, 모델 호출이 어떻게 조직되어야 하는지에 대한 구조적 유연성이 결여되어 있는 상황입니다. 본 논문은 이러한 고정된 패러다임을 탈피하여, 단일 정책 내에서 쿼리마다 적절한 실행 모드와 모델 선택을 동시에 수행하는 통합 라우팅 프레임워크를 제안합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 RouteWeaver라는 통합 라우팅 정책을 제안하며, 이는 쿼리마다 실행 모드를 선택하고 해당 모드 내에서 최적의 액션을 수행하도록 설계되었습니다 [Figure 2]. 핵심 방법론인 COMET-GRPO는 전체 궤적(trajectory) 수준의 보상을 모드 선택용 Advantage($A_{i}^{\text{mode}}$)와 모드 내부 실행용 Advantage($A_{i}^{\text{inner}}$)로 분리하여 타겟팅된 학습을 가능하게 합니다 [Figure 2]. 또한, Progressive Exploration을 통해 학습을 세 단계로 나누어, 초기에는 각 모드의 실행법을 익히고 후기로 갈수록 자율적인 모드 선택 능력을 함양하도록 유도합니다. 실험 결과, RouteWeaver는 평균 정확도 61.4%를 기록하며 최강의 베이스라인인 Router-R1 대비 11.03%의 상대적 성능 향상을 달성했습니다 [Table 1]. 또한, 추론 비용을 조절하는 $\alpha$ 파라미터를 통해 성능과 효율성 간의 유연한 트레이드오프를 제공하며, $\alpha=0.1$ 조건에서 비용을 23% 절감하면서도 정확도 손실을 1.0%로 최소화했습니다 [Figure 3].
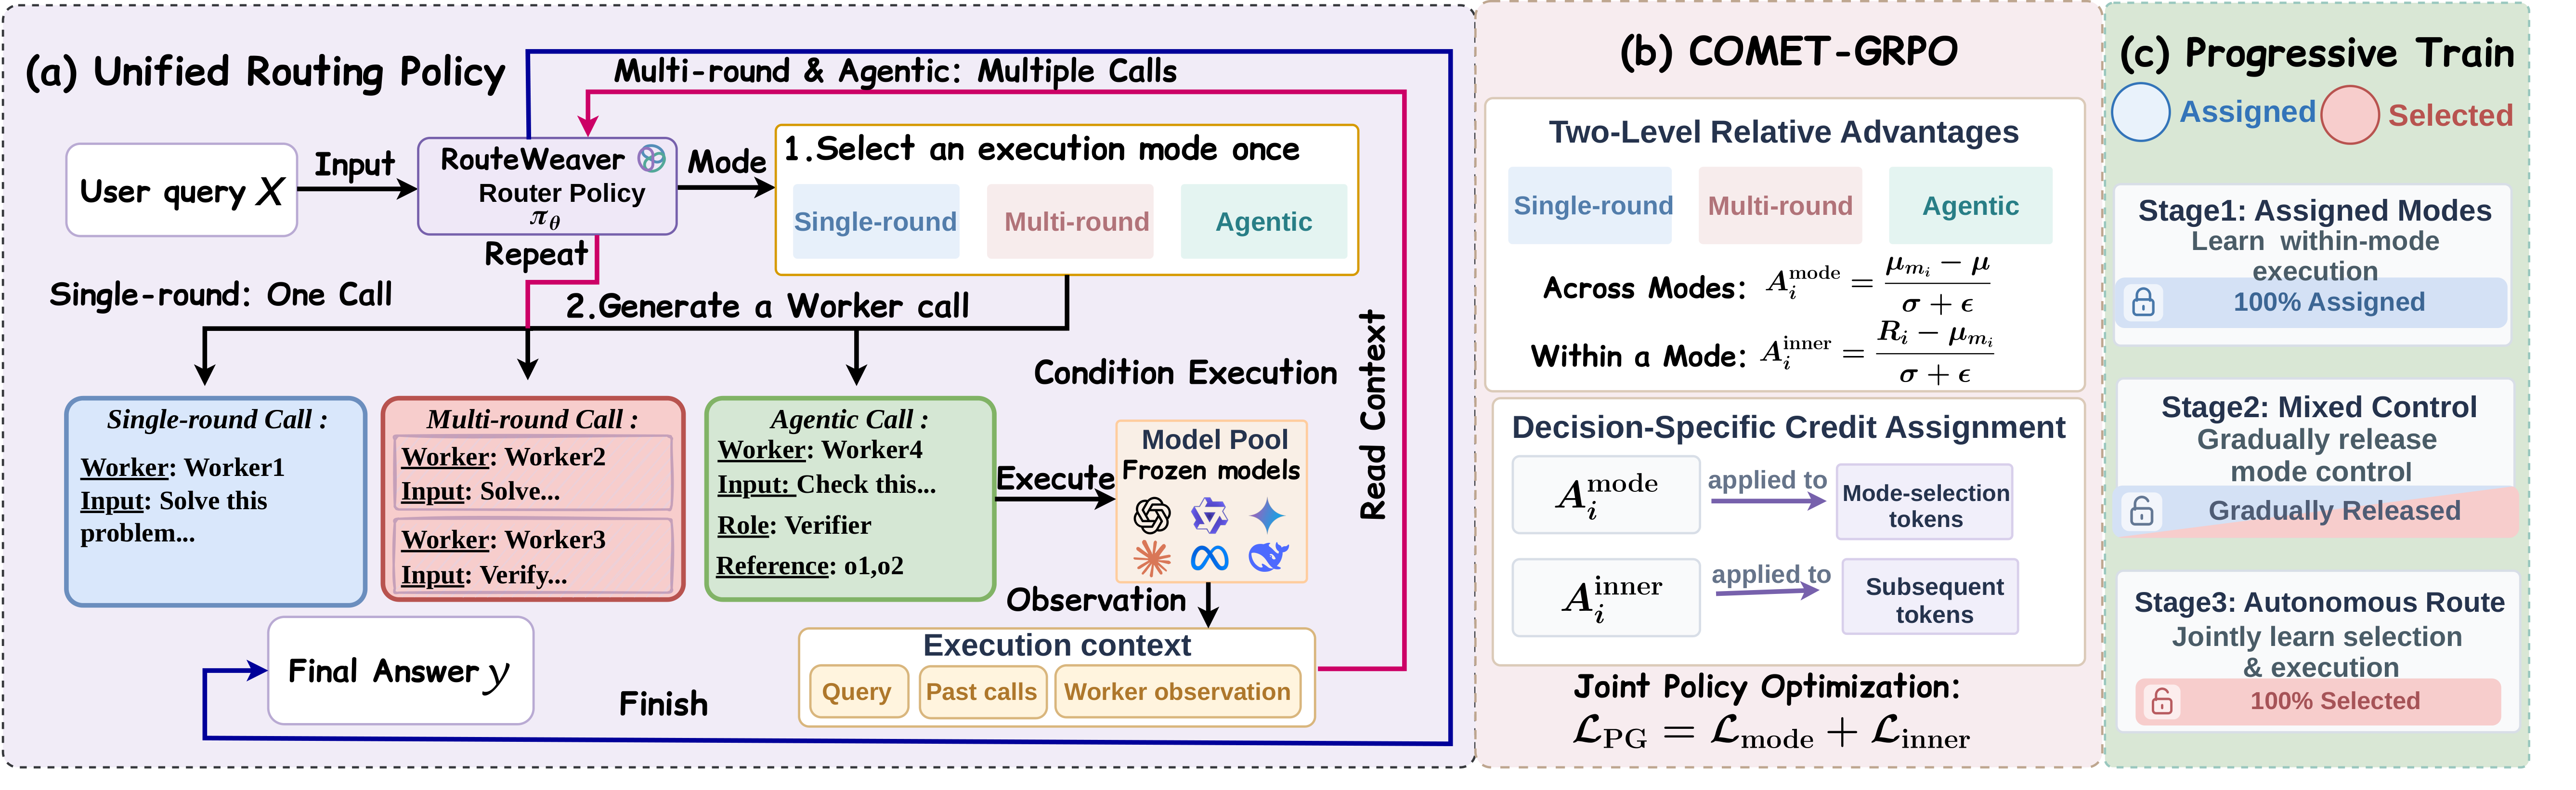
Figure 2 — RouteWeaver 전체 아키텍처
4. Conclusion & Impact (결론 및 시사점)
본 연구는 고정된 실행 구조를 가진 기존 라우팅 방식을 넘어, 쿼리 특성에 따라 실행 모드까지 동적으로 선택하는 Unified LLM Routing의 가능성을 입증했습니다. RouteWeaver는 COMET-GRPO와 Progressive Exploration을 통해 복잡한 다단계 결정 문제를 성공적으로 해결했습니다. 이 연구는 향후 LLM 기반 시스템이 정적인 파이프라인에서 벗어나 자율적으로 최적의 추론 워크플로우를 구성하도록 하는 데 중요한 이정표가 될 것입니다. 이러한 접근은 실무적인 AI 에이전트 설계 및 컴퓨팅 자원의 최적화 측면에서 실질적인 기술적 진보를 제공합니다.
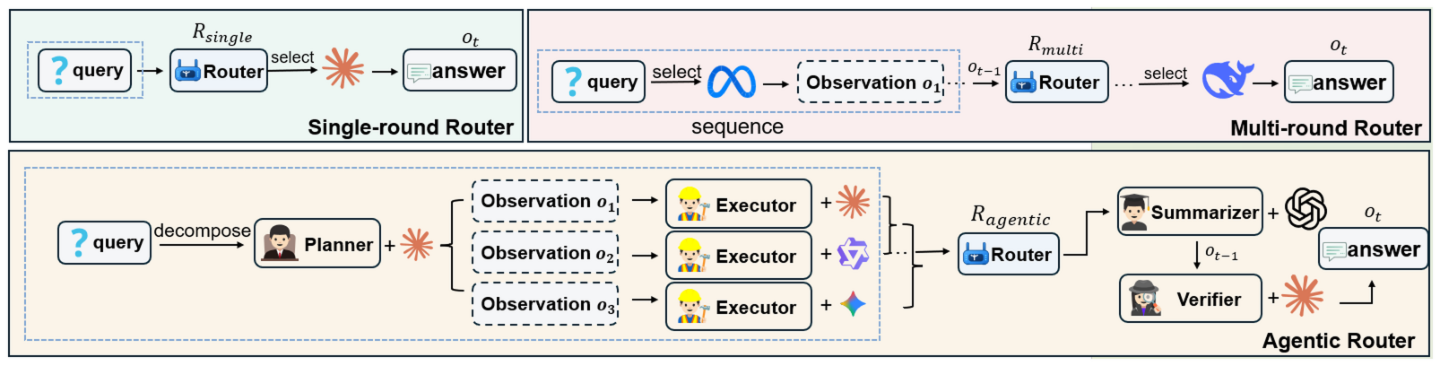
Figure 1 — 세 가지 실행 패러다임
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] SCOPE: Semantic Bounded Credit Optimization for Prompt Engineering in Text-to-image Generation
- [논문리뷰] Rubric-to-Code Credit Assignment for Reinforcement Learning
- [논문리뷰] V-Rubrics: Visual Faithfulness via Rubric-Based Reinforcement Learning
- [논문리뷰] Progressive Agent Skill Generation via Reinforcement Learning
- [논문리뷰] CoRT: Counterfactual Replay for Token-Level Rubric-Guided Policy Optimization
Review 의 다른글
- 이전글 [논문리뷰] Rethinking Sequence Compression with Test-time Regression
- 현재글 : [논문리뷰] RouteWeaver: Weaving Mode Selection and Execution into Unified LLM Routing
- 다음글 [논문리뷰] SCOPE: Compiling Natural-Language Policies into Neurosymbolic Predicate Programs
댓글