[논문리뷰] Generalized CycleGRPO for Fine-Grained Multimodal Understanding and Grounding
링크: 논문 PDF로 바로 열기
The paper "Generalized CycleGRPO for Fine-Grained Multimodal Understanding and Grounding" by Xin Zhang et al. introduces a unified reinforcement learning framework called Generalized CycleGRPO. This framework is designed to improve fine-grained multimodal understanding and grounding by coupling region understanding and localization across spatial, temporal, and spatio-temporal domains.
Here's the summary following the requested format:
Part 1: 요약 본문
저자: Xin Zhang, Haochen Wang, Beibei Lin, Zhaoxiang Zhang, Robby T. Tan, Jason Li, Dacheng Tao
1. Key Terms & Definitions (핵심 용어 및 정의)
- Generalized CycleGRPO: 공간(spatial), 시간(temporal), 시공간(spatio-temporal) 영역 전반에 걸쳐 영역 이해(region understanding)와 지역화(localization)를 통합하는 최초의 강화 학습(Reinforcement Learning) 프레임워크입니다.
- Region–Text Cycle Consistency: 주어진 시각적 영역(visual region)을 모델이 텍스트 설명(caption)으로 생성하고, 다시 그 설명을 통해 원래 영역을 재구성(reconstruct)하는 폐쇄 루프(closed loop) 메커니즘을 의미합니다. 재구성 IoU(Intersection over Union)를 통해 설명의 품질을 검증합니다.
- DOVE (Distinctive Occurrence-level Video-caption Evaluation): 비디오 내에서 동일한 쿼리(query)에 해당하는 여러 이벤트 발생(occurrence) 중 특정 대상을 구별하는 캡션의 능력을 평가하기 위해 도입된 새로운 벤치마크입니다.
- gIoU (generalized IoU): 객체 감지(object detection) 및 분할(segmentation)에서 예측된 바운딩 박스(bounding box) 또는 마스크(mask)와 Ground Truth 사이의 중첩(overlap) 정도를 측정하는 지표입니다.
- TEC (Temporal Evidence Coverage): DOVE 벤치마크에서 캡션이 Order, State, Outcome 세 가지 유형의 프루브(probe)에 대해 얼마나 많은 정확한 증거를 제공하는지를 나타내는 매크로 평균(macro-average) 지표입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
기존 Multimodal Large Language Models (MLLMs)은 전체 이미지나 비디오에 대한 이해를 넘어 특정 객체, 공간 영역, 시간 이벤트 등 fine-grained한 정보에 대한 질문에 답변할 수 있어야 합니다. 이를 위해서는 지정된 영역의 콘텐츠를 설명하는 능력(region understanding)과 언어를 공간적 또는 시간적 범위로 매핑하여 콘텐츠를 지역화하는 능력(localization)이라는 두 가지 상호 보완적인 역량이 요구됩니다. 기존 강화 학습 방식은 이러한 두 방향을 분리된 목표(separate objectives)와 task-specific한 주석(annotations)으로 최적화하며, 이는 데이터 수집에 비용이 많이 드는(supervision bottleneck) 한계를 가집니다. 또한, 유창한 캡션이 반드시 원본 영역을 고유하게 식별하지 못하고, 강력한 localizer가 캡션 개선에 직접적인 신호를 제공하지 못하는 문제가 있습니다. 특히 비디오에서 이벤트가 여러 번 반복될 수 있으므로, 일반적인 캡션은 여러 간격에 접지될 수 있어 일대일 대응을 정의하지 못할 수 있습니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 영역 이해와 지역화를 단일 강화 학습 프레임워크인 Generalized CycleGRPO로 통합합니다. 이 방법론은 region–text cycle consistency를 핵심 원칙으로 삼아, 초기 영역(ℛ)이 주어지면 모델이 후보 설명(C)을 생성하고, 다시 이 설명을 사용하여 원본 영역을 재구성(ℛ̂)하는 루프를 형성합니다 [Figure 3]. 재구성된 영역과 원본 영역 간의 Overlap Measure는 설명 품질에 대한 기하학적으로 검증 가능한 보상(geometrically verifiable reward)을 제공하며, 개별 지역화 궤적(localization trajectories)에 대한 보상은 지역화 성능을 향상시킵니다. 이러한 접근 방식은 이미지 마스크, 박스, 비디오 간격 및 타임스탬프가 있는 공간 증거(timestamped spatial evidence)에 동일하게 적용되며, 강화 학습 중 캡션 주석이나 외부 언어 모델 심판(external language-model judge)이 필요 없습니다. 비디오의 경우, 이 사이클은 타겟 이벤트를 의미적으로 유사한 반복(semantically similar recurrences)과 구별하는 설명을 선호하도록 추가적인 보상을 제공합니다.
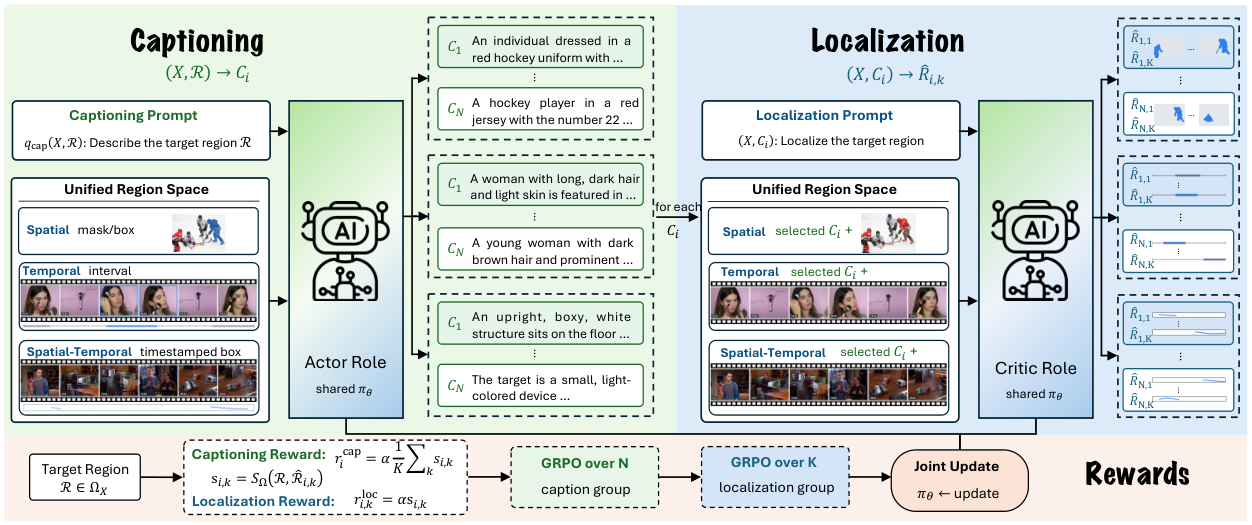
Figure 3 — Generalized CycleGRPO 개요
실험 결과, Generalized CycleGRPO는 다양한 벤치마크에서 SOTA 성능을 달성했습니다.
- Spatial Setting: GroundingSuite에서 SAMTok의 전체 gIoU를 57.5%에서 68.2%로, GRES에서 평균 gIoU를 71.2%에서 78.7%로 향상시켰습니다 [Figure 2, Table 1, Table 3]. DLC-Bench 정확도 또한 61.9%에서 67.8%로 개선되었습니다 [Table 1].
- Temporal Setting: Charades에서 tIoU를 45.6%에서 51.9%로, 새로운 DOVE 벤치마크에서 Temporal Evidence Coverage (TEC)를 14.8%에서 33.3%로 크게 향상시켰습니다 [Figure 2, Table 4, Table 5].
- Spatio-Temporal Setting: V-STaR의 mAM을 34.6%에서 36.2%로, mLGM을 47.2%에서 49.8%로 끌어올렸습니다 [Figure 2, Table 7]. 또한 TVGBench의 mIoU는 21.1%에서 28.5%로 증가했습니다 [Table 8]. 이러한 결과는 region–text cycle consistency가 multimodal understanding 및 localization을 공동으로 발전시키는 일반적인 자가 평가 원칙임을 입증합니다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 기존 ECCV CycleGRPO를 이미지 마스크에서 비디오 간격 및 시공간 궤적(spatio-temporal trajectories)으로 확장한 Generalized CycleGRPO를 제안합니다. 이 프레임워크는 단일 정책(single policy)이 상호적인 롤아웃(reciprocal rollouts)을 통해 캡셔닝과 지역화를 학습하며, 참조 캡션이나 별도의 평가 모델 없이 재구성 품질(reconstruction quality)을 감독 신호로 사용합니다. 세 가지 영역 설정 모두에서 제안된 방법은 기존 베이스라인 모델의 성능을 향상시켰습니다. 특히, 본 연구는 비디오 내에서 반복되는 동일 쿼리 발생(same-query occurrences) 중 특정 이벤트를 캡션이 구별할 수 있는지 평가하는 새로운 벤치마크인 DOVE를 소개합니다 [Figure 4]. 이 연구는 모델이 시각적 콘텐츠를 설명하고 지역화해야 할 때, Cycle Reconstruction이 실용적이고 검증 가능한(verifiable) 훈련 신호가 됨을 보여주며, fine-grained multimodal AI 발전에 중요한 기여를 합니다.
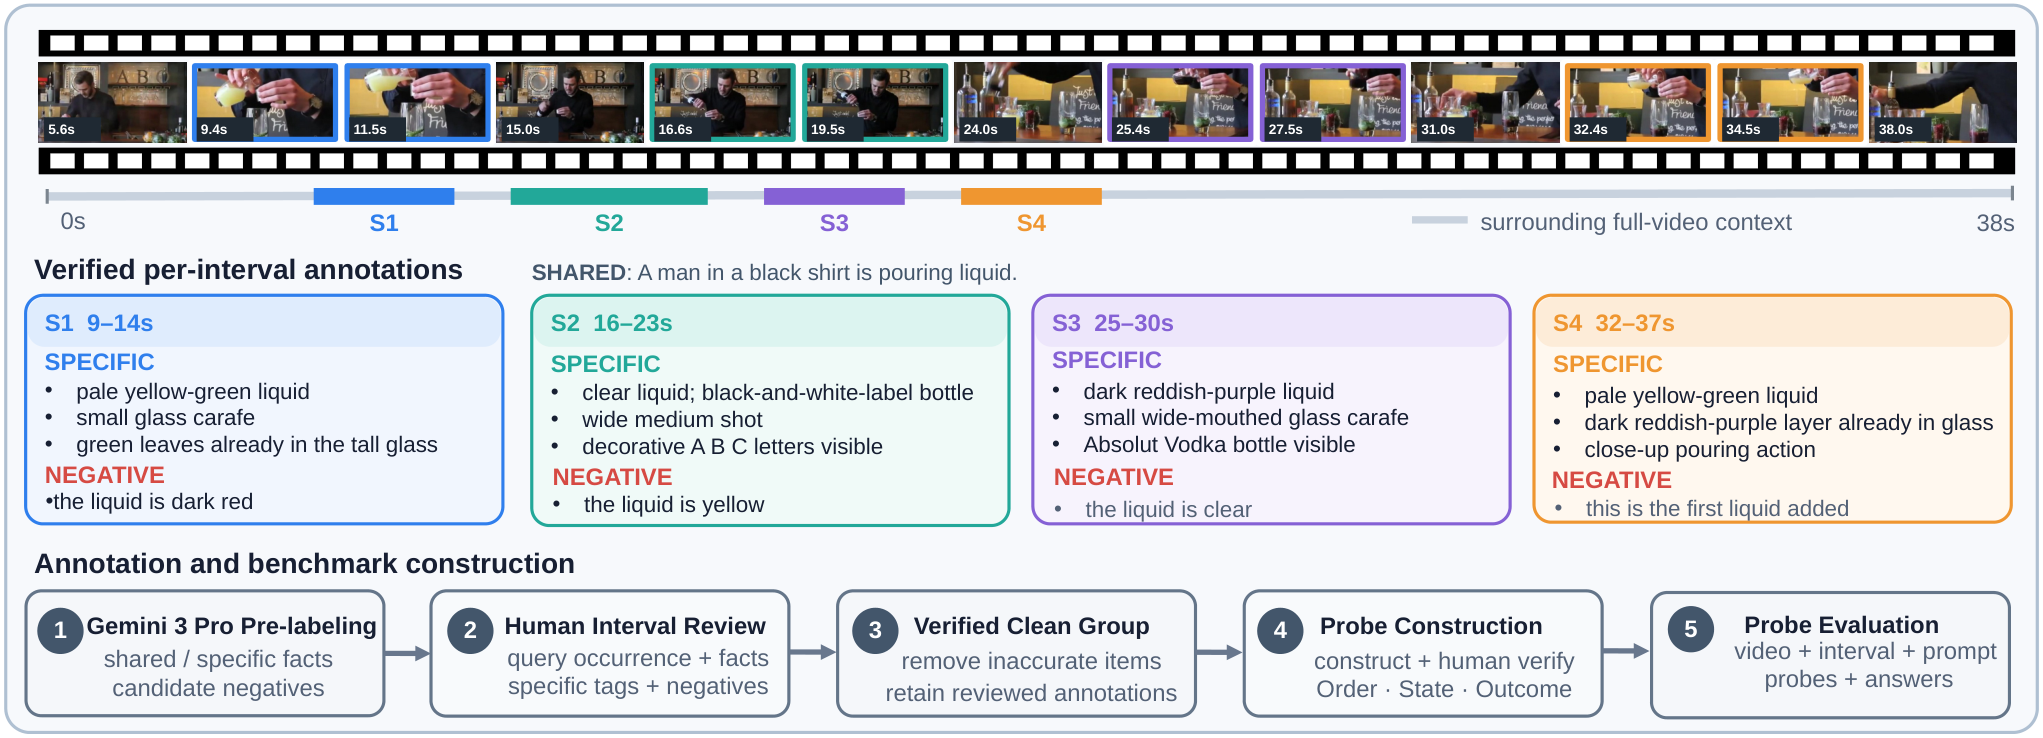
Figure 4 — DOVE 벤치마크 구성 및 평가
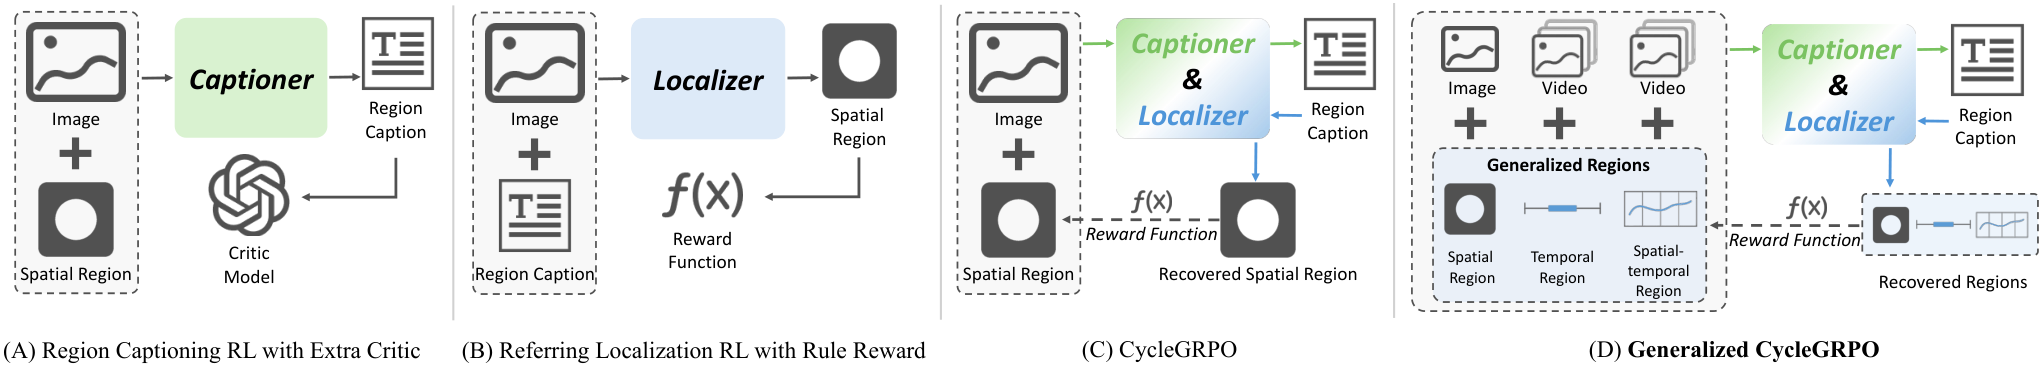
Figure 1 — CycleGRPO의 일반화
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] VepAgent: Bridging Causal-Transition via Tool-Augmented Reinforcement Learning for Video Event Prediction
- [논문리뷰] Not All Prompts Are Equal: Exploration-Guided Prompt Scaffolding for Multimodal Reinforcement Post-Training
- [논문리뷰] Annotations as Rollouts: Efficient and Scalable Reinforcement Learning for Video MLLMs
- [논문리뷰] InSight-doc: Agentic Visual Perception for Long-Document Understanding
- [논문리뷰] OneEmo: A Unified Multimodal Reasoning Model for Emotion Perception, Understanding, and Interaction
Review 의 다른글
- 이전글 [논문리뷰] FLORA: An Open Model Suite for Scaling Robotics Data Engines
- 현재글 : [논문리뷰] Generalized CycleGRPO for Fine-Grained Multimodal Understanding and Grounding
- 다음글 [논문리뷰] HiSTEVE 1.0: Harnessing Human-Interface VLA Agents for Open-World Games
댓글