[논문리뷰] FLORA: An Open Model Suite for Scaling Robotics Data Engines
링크: 논문 PDF로 바로 열기
저자: Sicong Leng, Yunze Man, Zhiqi Li, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- Flora: 로봇 데이터 세트의 레이블링 및 처리를 위해 설계된 산업용 품질의 오픈 데이터 엔진입니다.
- Outcome reward: 에피소드 전체의 성공 여부를 판단하여 배치 모니터링, 데이터 필터링, 정책 평가에 사용되는 지표입니다.
- Process reward: 에피소드 진행 단계별로 성취도를 측정하여 RL post-training의 세부적인 credit assignment를 지원합니다.
- Timestamped captions: 영상 내 특정 시간 구간(interval)과 그에 대응하는 의도된 동작(intended action)을 매칭하여 필터링 및 데이터 밸런싱을 가능하게 합니다.
- Rubric-derived reward: 테스트 타임에 사용자가 정의한 루브릭(rubric)에 따라 유연하게 보상 값을 계산하는 평가 방식입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 논문은 로봇 기반 모델의 성능 향상을 위해 필수적인 고품질 데이터 레이블링이 기존 시스템에서는 매우 비용이 높고 제한적인 유형의 주석만 제공한다는 문제를 해결하고자 합니다. 대규모 로봇 데이터 세트를 구축하기 위해서는 다양한 형태의 레이블(caption, process/outcome reward 등)이 통합적으로 필요하지만, 현재의 frontier 모델들은 이러한 대규모 데이터 처리에 엄청난 API 비용을 소모합니다. 기존 연구들은 대개 단일 주석 유형에만 집중하거나 특정 환경에 국한되어 있어, 범용적인 로봇 학습 데이터를 대규모로 생성하고 관리하는 효율적인 대안이 요구됩니다.
## 3. Method & Key Results (제안 방법론 및 핵심 결과)
Flora는 세 가지 핵심 모델(captioning, segmentation, reward model)을 결합하여 로봇 작업의 timestamped captions, process rewards, outcome rewards를 일관되게 생성하는 통합 파이프라인을 제안합니다. [Figure 1]에서 볼 수 있듯이 이 시스템은 영상을 의미 있는 구간으로 분할(segmentation)하고, 각 구간에 문맥을 반영한 동작 캡션을 생성하며, 단계별 성취도를 정밀하게 평가합니다. 특히, [Table 1]에 따르면 Flora는 주요 벤치마크인 WGO-Bench, RoboReward, Robometer에서 GPT-6 Astra와 대등한 성능을 보이거나 이를 상회하며 다른 frontier 모델들을 압도합니다. 비용 측면에서는 GPT-6 Astra 대비 125배 낮은 비용으로 초당 약 0.72달러의 효율적인 레이블링을 수행하며, 하루에 20만 시간 분량의 데이터를 처리할 수 있는 산업적 규모의 확장성을 입증했습니다.
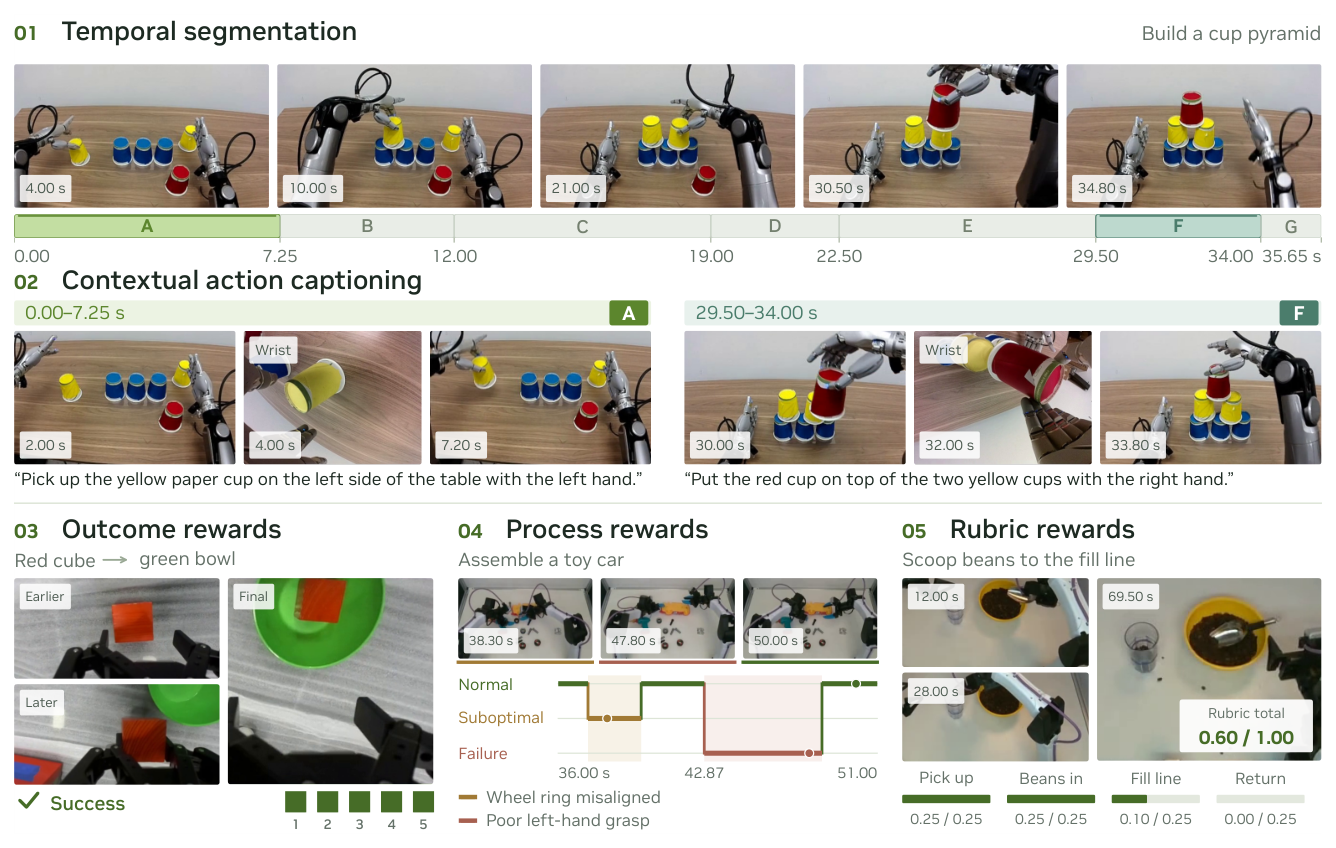
Figure 1 — Flora 데이터 엔진의 핵심 기능(segmentation, captioning, reward labeling)을 시각적으로 잘 요약하고 있음
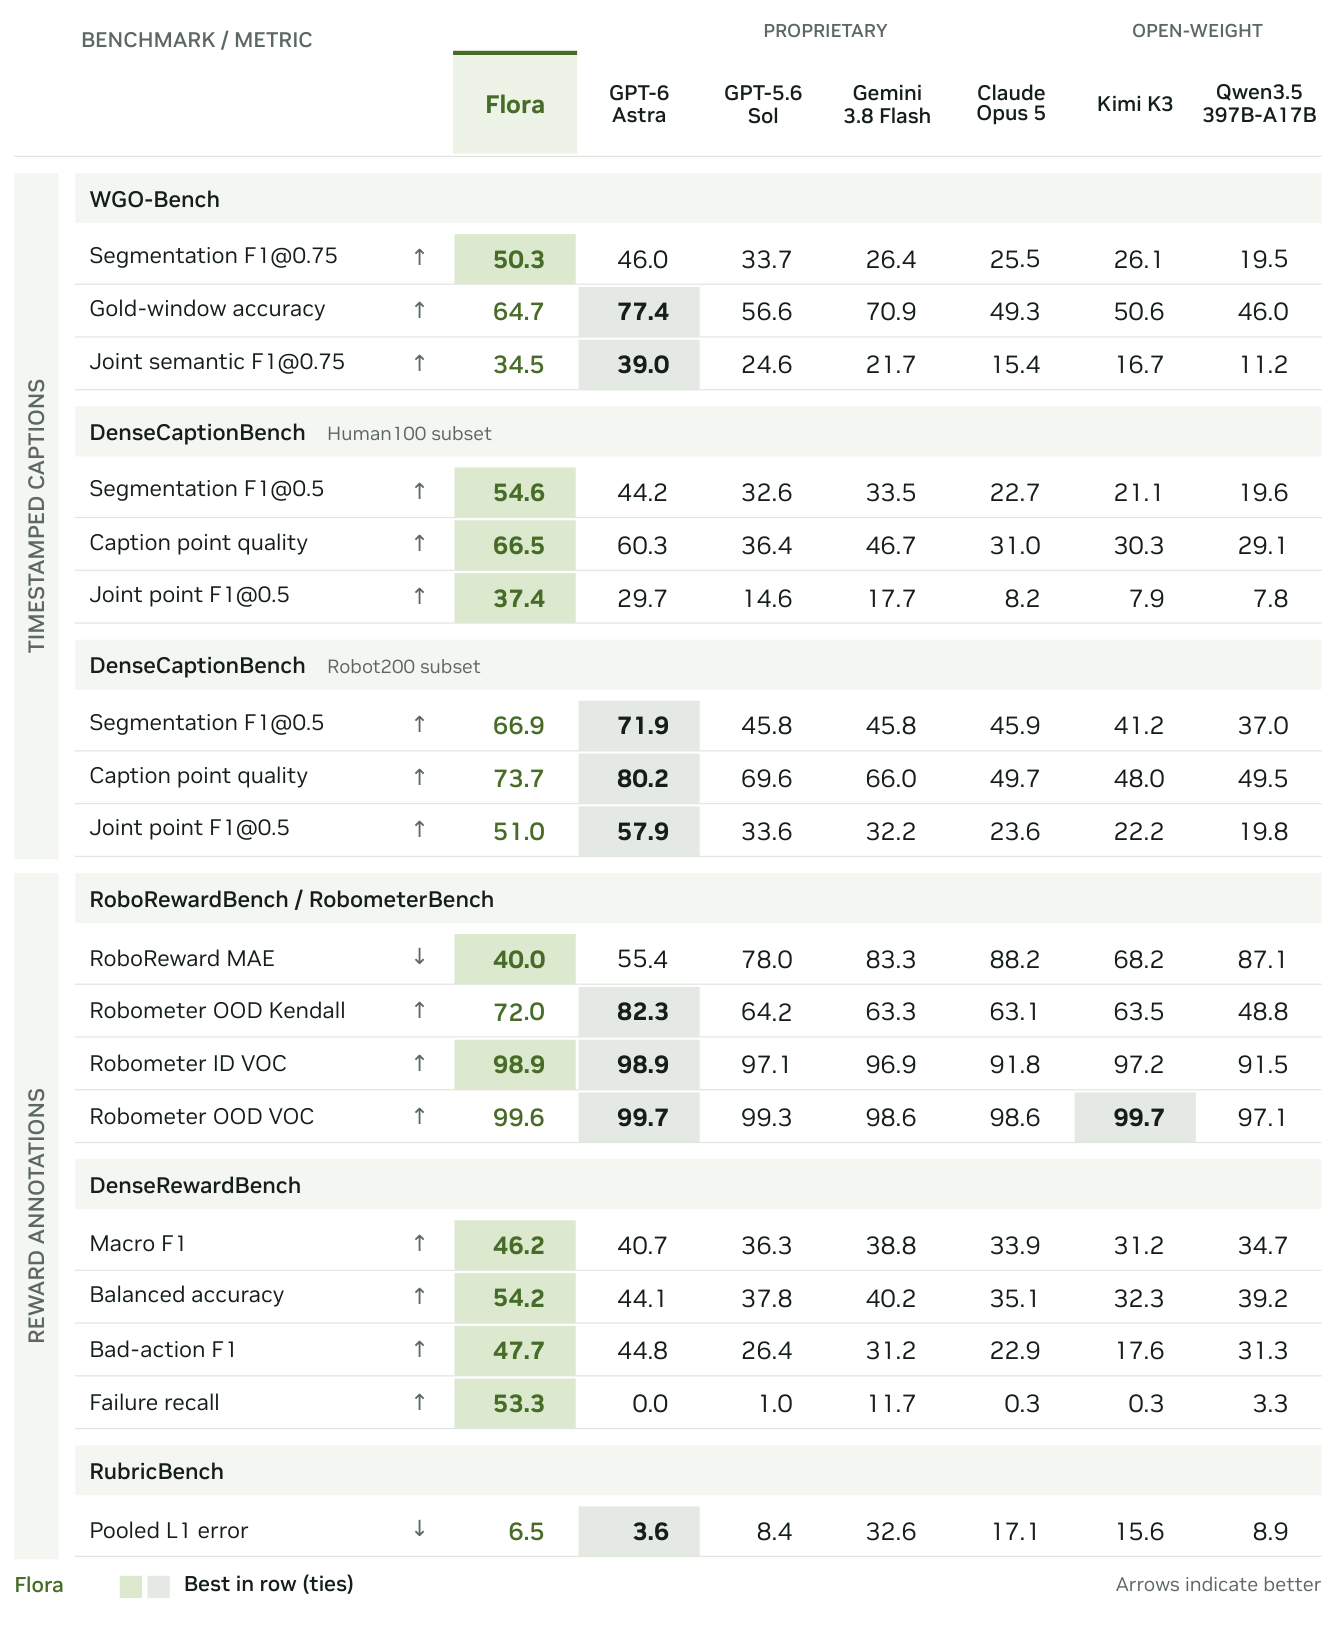
Table 1 — 다양한 벤치마크 지표에서 타 모델 대비 Flora의 우수성과 경쟁력을 정량적으로 보여주는 핵심 결과 테이블
## 4. Conclusion & Impact (결론 및 시사점) Flora는 로봇 파운데이션 모델 학습을 위한 고성능·저비용 데이터 엔진으로서, 로봇 공학 연구 및 산업계의 데이터 스케일링 병목을 해결할 실질적인 경로를 제시합니다. 본 연구는 오픈 소스화를 통해 연구자들이 물리적 자동 연구(physical auto-research) 및 인간-로봇 간 지식 전이(human-to-robot transfer)와 같은 새로운 응용 분야를 개척할 수 있는 토대를 마련했습니다. 향후 로봇 데이터 생성의 표준화와 더불어, 고가의 상용 API 모델 의존도를 낮추고 데이터 효율성을 최적화하는 데 중요한 역할을 할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Many Right Answers, One Training Example: Removing Responder Noise from GRPO for LLM Recommenders
- [논문리뷰] LexReward: A Taxonomy-Driven Reward Framework for Legal Language Models
- [논문리뷰] Diffusion Reward Models
- [논문리뷰] ImpossibleRubrics: Stress-Testing Generated Rubrics as Reward Signals
- [논문리뷰] Beyond Solver Verdicts: Generative Reward Models for Autoformalization
Review 의 다른글
- 이전글 [논문리뷰] FLOMSS: Generative Music Source Separation by Flow Matching
- 현재글 : [논문리뷰] FLORA: An Open Model Suite for Scaling Robotics Data Engines
- 다음글 [논문리뷰] Generalized CycleGRPO for Fine-Grained Multimodal Understanding and Grounding
댓글