[논문리뷰] Δτ-Bench: Pushing Agents Toward a Moving Capability
링크: 논문 PDF로 바로 열기
저자: Shuofei Qiao, Xuanguang Pan, Yijun Chen, Wendi Feng, Bin Wu, Runnan Fang, Yuqi Zhu, Shumin Deng, Emine Yilmaz
키워: Agent Benchmarking, Tool Ecosystem Evolution, Skill Maintenance, Capability Provisioning, LLM Agents, Dynamic Tool Use, Adaptation
1. Key Terms & Definitions (핵심 용어 및 정의)
- ∆т-Bench: 대규모의 진화하는 Tool Ecosystem에서 Agent의 지속적인 역량을 평가하기 위해 제안된 실행 가능한 벤치마크입니다.
- Capability Frontier: 변화하는 Tool Ecosystem 내에서 Task를 완료할 수 있는 가장 효율적인 경로를 나타내는, 시간이 지남에 따라 움직이는 최적의 Task 수행 능력 경계입니다.
- STEWARD: 변화하는 Tool Ecosystem에서 Agent의 Tool 및 Skill 사용을 최적화하기 위해 점진적인 Skill Maintenance와 동적 Provisioning을 통해 Tool과 절차적 Knowledge를 공동으로 관리하는 Ecosystem Manager입니다.
- Skill Maintenance: Tool Ecosystem의 변화에 따라 Agent가 축적한 절차적 Knowledge (Skill)를 효과적으로 업데이트하고 재활용하는 프로세스입니다.
- Dynamic Provisioning: Task Execution 중 Agent가 현재 상황에 맞춰 관련 Tools 및 절차적 Guidance를 동적으로 제공받는 메커니즘입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Large Language Model (LLM) Agent가 Tool Ecosystem의 지속적인 변화에 적응하여 효율적으로 Task를 수행할 수 있는지 평가하는 데 초점을 맞추고 있습니다. 기존 벤치마크들은 Agent의 Tool Retrieval, Stateful Execution, Re-planning, Robustness와 같은 개별 능력들을 분리하여 평가하며, 서비스 구조가 고정되어 있거나 Tool Discovery가 제한적인 환경에 머물러 있었습니다. 이로 인해 Agent가 변화하는 Ecosystem에서 효율적인 Tool-use Path를 선제적으로 발견하고 축적된 절차적 Knowledge를 신속하게 수정하는 능력을 종합적으로 평가하지 못하는 한계가 있었습니다. [Figure 1]이 보여주듯이, Tool Ecosystem은 개별 부서의 독립적인 Tool 업데이트, Overlapping Functionality, 노이즈가 많거나 부정확한 Documentation 등으로 인해 끊임없이 변화하며, 이는 Agent의 기존 Workflow를 무효화하고 새로운 효율적인 대안을 찾아내기 어렵게 만듭니다. 이러한 문제들을 해결하기 위해서는 Agent가 변화하는 Capability Frontier에 지속적으로 적응하는 능력을 종합적으로 측정할 수 있는 새로운 벤치마크가 필요합니다.
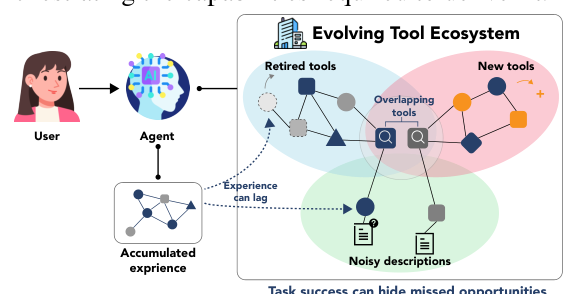
Figure 1 — 변화하는 Tool Ecosystem에서 Agent가 직면하는 문제점을 시각적으로 설명하며, 본 연구의 동기를 제공하는 핵심 다이어그램
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 대규모의 진화하는 Tool Ecosystem에서 Agent의 능력을 체계적으로 평가하기 위해 실행 가능한 벤치마크인 ∆т-Bench를 제안합니다. [Figure 2]에 제시된 ∆т-Bench는 Capability-preserving Transformations을 통해 6개의 연속적인 Ecosystem States를 생성하며, 42개 Domain에 걸쳐 1,588개의 Validated Multi-turn Task를 포함합니다. 각 Ecosystem State마다 가장 효율적인 Task Path를 Reference로 설정하여 Agent의 Performance를 평가합니다.
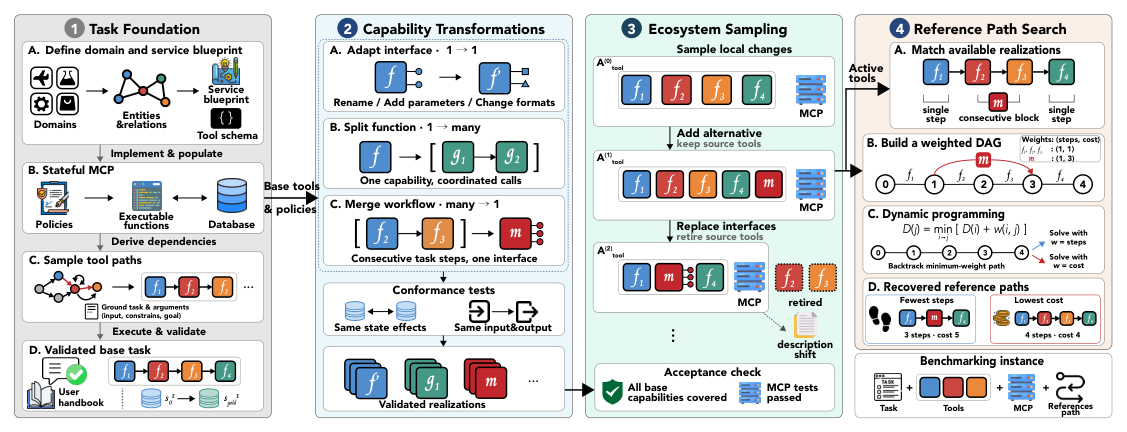
Figure 2 — ∆T-Bench 벤치마크의 전체적인 구성 과정과 주요 구성 요소를 설명하는 방법론 핵심 다이어그램
평가 결과, 현재까지 가장 강력하다고 알려진 모델인 Gemini-3.6-Flash 및 Codex-GPT-5.5조차 41.65% 및 42.27%의 낮은 Task Success Rate (SR)를 보였으며, Step- or Cost-SPE는 30%를 넘지 못했습니다. Tool Retrieval 측면에서 Codex-GPT-5.5는 관련 Tool의 90.36%를 Retrieve 했지만, Precision은 19.90%, F1 Score는 32.04%에 불과하여 불필요한 후보를 제외하는 데 어려움을 겪는 것으로 나타났습니다. 기존 Skill-learning Methods인 EvoSkill, AutoSkill, Trace2Skill, SkillOpt는 초기 성능 향상을 보였으나, Ecosystem이 진화함에 따라 그 이점이 지속되지 못했으며, 특히 AutoSkill은 일부 버전에서 No Skill Baseline보다 낮은 SR을 기록했습니다.
이러한 한계를 극복하기 위해 저자들은 STEWARD라는 Ecosystem Manager를 제안합니다. STEWARD는 점진적인 Skill Maintenance와 동적 Capability Provisioning을 결합하여 Tool과 절차적 Knowledge를 공동으로 관리합니다. [Figure 6(a)]와 [Figure 6(b)]에서 볼 수 있듯이, STEWARD는 모든 Ecosystem Version에서 가장 높은 SR(평균 39.04% vs. SkillOpt의 36.36%)을 달성했으며, v2부터 가장 낮은 Skill Maintenance Overhead(다른 Baseline 대비 1.2~5.5배 적은 토큰 소모)를 기록했습니다. [Figure 6(c)]는 STEWARD가 Step-/Cost-IDR에서 4.04%/3.69%, Step-/Cost-DAR에서 5.28%/4.76%의 평균 향상을 보였음을 보여주며, 이는 Disrupt된 Workflow로부터의 Recovery와 더 효율적인 대안의 채택 모두에서 우수한 적응 능력을 의미합니다. [Table 2]의 Ablation Study 결과, Incremental Maintenance는 Full Reconstruction 대비 Skill Maintenance 토큰을 30.4%~39.5% 절감하면서도 더 높은 SR을 달성하여, Knowledge 재사용과 Ecosystem 변화에 대한 적응의 균형을 맞추는 데 효과적임을 입증했습니다. [Figure 7]에 따르면, Full Provisioning은 Skill Search와 Tool Search를 모두 결합했을 때 모든 Metrics에서 가장 큰 향상을 보여, 이 두 요소가 Capability Provisioning에서 상호 보완적인 역할을 함을 강조합니다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 ∆т-Bench라는 새로운 벤치마크를 통해 Agent가 끊임없이 변화하는 Tool Ecosystem에서 지속적으로 효율성과 신뢰성을 유지하는 능력을 평가했습니다. 실험 결과는 기존 Agent와 Skill-learning Method들이 이러한 동적인 환경에서 Task Success와 Adaptation에 어려움을 겪는다는 것을 명확히 보여주었습니다. 이에 대응하여 제안된 STEWARD는 Tool과 절차적 Knowledge를 Incremental Skill Maintenance 및 Dynamic Provisioning 메커니즘을 통해 공동으로 관리함으로써, Agent의 Task Performance와 Ecosystem 변화에 대한 적응 능력을 크게 향상시키면서도 Maintenance Overhead를 절감했습니다. 이 연구는 Tool과 Procedural Knowledge가 상호 의존적인 자원임을 인식하고, 축적된 경험을 Ecosystem이 진화함에 따라 유용하게 유지하는 것이 필수적이라는 중요한 시사점을 제공합니다. 이러한 접근 방식은 LLM Agent가 복잡하고 실제와 같은 환경에서 더욱 견고하고 효율적인 자동화를 달성하는 데 기여할 것입니다.
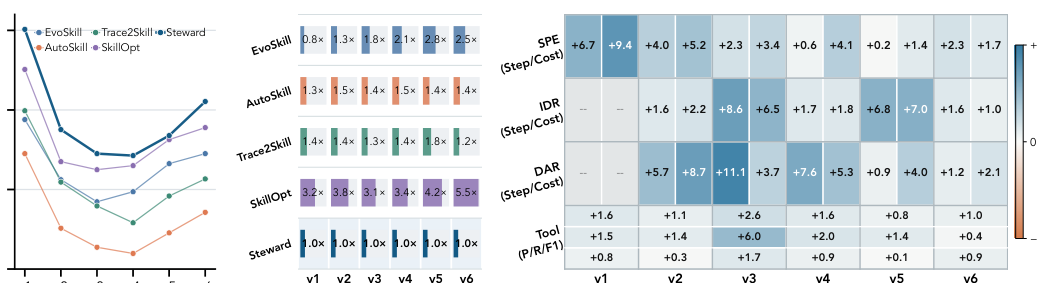
Figure 6 — STEWARD가 변화하는 Tool Ecosystem에서 Baseline 대비 Task Success, Maintenance Cost, Execution Efficiency, Frontier Tracking 등 주요 지표에서 성능 우위를 보여주는 핵심 결과 그래프
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] miniTE: Diagnosing and Bridging the Execution Gap in Native NVFP4 Reinforcement Learning
- [논문리뷰] iPrefBench: A User-Centric Benchmark for Personalized Mobile Use Agents
- [논문리뷰] WorldCast: World-Consistent Character Video Generation with Large-Angle Camera Control
- [논문리뷰] World-in-Context: Interactive Video World Modeling with In-Context Conditioning
Review 의 다른글
- 이전글 [논문리뷰] miniTE: Diagnosing and Bridging the Execution Gap in Native NVFP4 Reinforcement Learning
- 현재글 : [논문리뷰] Δτ-Bench: Pushing Agents Toward a Moving Capability
- 다음글 없음
댓글