[논문리뷰] CRM-Agent-Bench: Benchmarking Tool-Using Agents in Stateful Enterprise Environments
링크: 논문 PDF로 바로 열기
저자: Monojit Banerjee, Zhujun Lan, Defu Cao, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- CRM-Agent-Bench: 555개의 상태 기반(stateful) 다중 턴(multi-turn) 작업을 포함하며, 비즈니스 규칙과 정책 준수를 평가하는 실행 중심 벤치마크입니다.
- Executable Contract: 각 작업에 대해 동작, 인수, 순서, 응답, 대상 상태 및 보호된 상태에 대한 요구사항을 프로그램적으로 정의한 검증 규격입니다.
- Strict Success: 작업에 명시된 모든 contract 검사 항목을 동시에 만족해야 성공으로 간주하는 평가 지표입니다.
- On-Policy User Simulator: 고정된 대화 스크립트 대신, 에이전트의 응답에 따라 매번 새로운 상호작용을 생성하는 동적 환경 시뮬레이터입니다.
- Capability Exposure: 에이전트가 특정 도구(tool)에 접근 가능한지 여부를 그래프 구조를 통해 관리하고 검증하는 감사 메커니즘입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 실제 기업 환경에서 언어 모델 에이전트가 수행하는 작업이 단순한 응답 정확도를 넘어 비즈니스 시스템의 무결성을 유지해야 한다는 점을 강조합니다. 기존 벤치마크들은 주로 질문-응답 정확도나 독립적인 도구 사용 능력만을 평가하여, 복잡한 상태 변화나 정책 위반 상황을 포착하지 못한다는 한계가 있습니다. 특히 기업용 CRM 환경에서는 잘못된 도구 실행이 실제 비즈니스 손실로 이어질 수 있으므로, 에이전트의 결과(Outcome), 궤적(Trajectory), 운영 가능성(Operational Viability), 정책 준수(Policy Compliance)를 종합적으로 평가하는 프레임워크가 필요합니다. 본 연구는 이러한 다각적인 평가 요구를 충족하기 위해 CRM-Agent-Bench를 제안합니다.
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 본 연구는 9개의 비즈니스 도메인과 36개의 기능 태그를 아우르는 555개의 태스크를 구축하고, 프로그램 기반의 conjunctive contract를 통해 에이전트의 전체 과정을 엄격히 평가합니다. 제안된 방법론은 에이전트의 도구 호출, 상태 변경, 최종 대화 응답 등을 실시간으로 시뮬레이션하여 검증합니다. 실험 결과, 평가된 16개 시스템의 Strict Success 비율은 64.32%에서 83.60%로 나타났습니다. 특히 기존의 단순 응답 기반 평가는 실제 수행 결과를 간과하여 Strict Success보다 약 10.5~11.0%p 가량 성능을 과대평가하는 경향이 있음이 확인되었습니다. 정책 제약이 있는 작업(policy-constrained tasks)의 경우, 시스템들은 부정적 검사 항목을 91.2%의 확률로 통과했지만, 모든 요구사항을 포함한 전체 contract를 만족한 비율은 66.8%에 그쳤습니다. 이는 에이전트가 정책을 준수하며 올바른 워크플로우를 완수하는 것이 독립적인 평가지표임을 시사합니다. [Figure 4]는 시스템별 성능 차이를, [Table 6]은 각 모델의 정확도와 비용을 요약하여 보여줍니다.
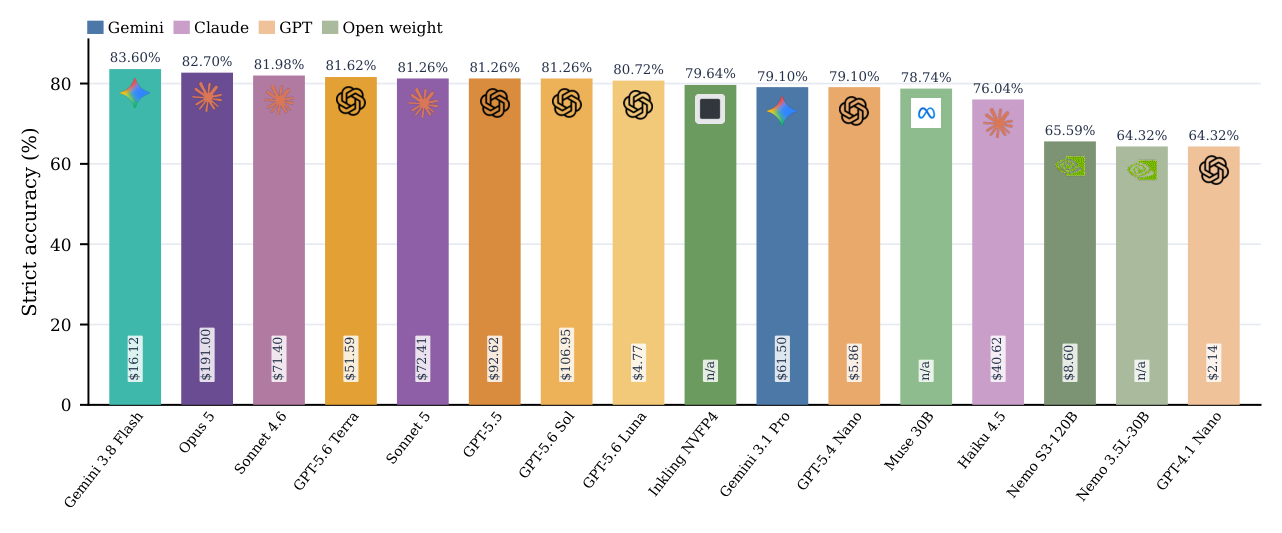
Figure 4 — 각 시스템별 Strict Success 정확도와 비용을 시각화한 핵심 결과 그래프
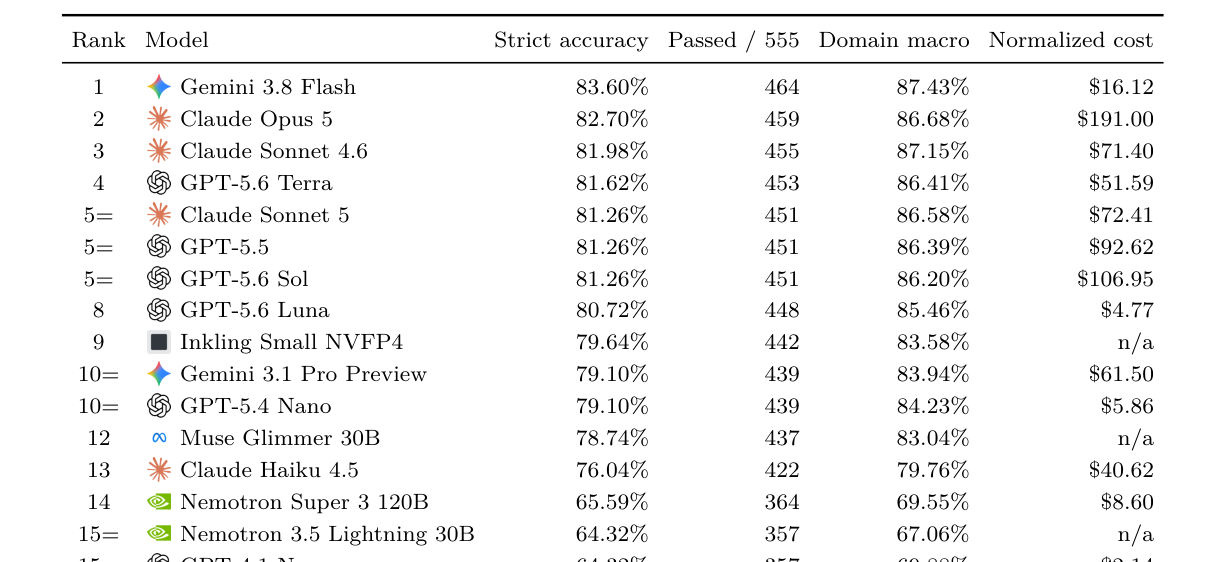
Table 6 — 16개 시스템의 성능 및 비용 데이터를 정리한 상세 비교 테이블
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 엔터프라이즈 환경에서 언어 모델 에이전트의 deployability를 판단하기 위해서는 strict accuracy 외에도 비용, 도메인별 안정성, 정책 준수 능력을 종합적으로 고려하는 다축 접근법이 필수적임을 입증했습니다. 이 연구는 기업 내 복잡한 비즈니스 로직을 수행하는 에이전트의 신뢰성을 측정하는 표준화된 도구를 제공하며, 향후 더 복잡한 시스템으로 에이전트가 확장됨에 따라 구조화된 계약 중심의 평가 모델이 핵심적인 역할을 할 것으로 기대됩니다. 또한 본 벤치마크는 특정 시스템에 의존하지 않는 이식 가능한 구조를 지향하여, 향후 모델 고도화에 맞춘 지속적인 평가 환경 확장이 가능하도록 설계되었습니다.
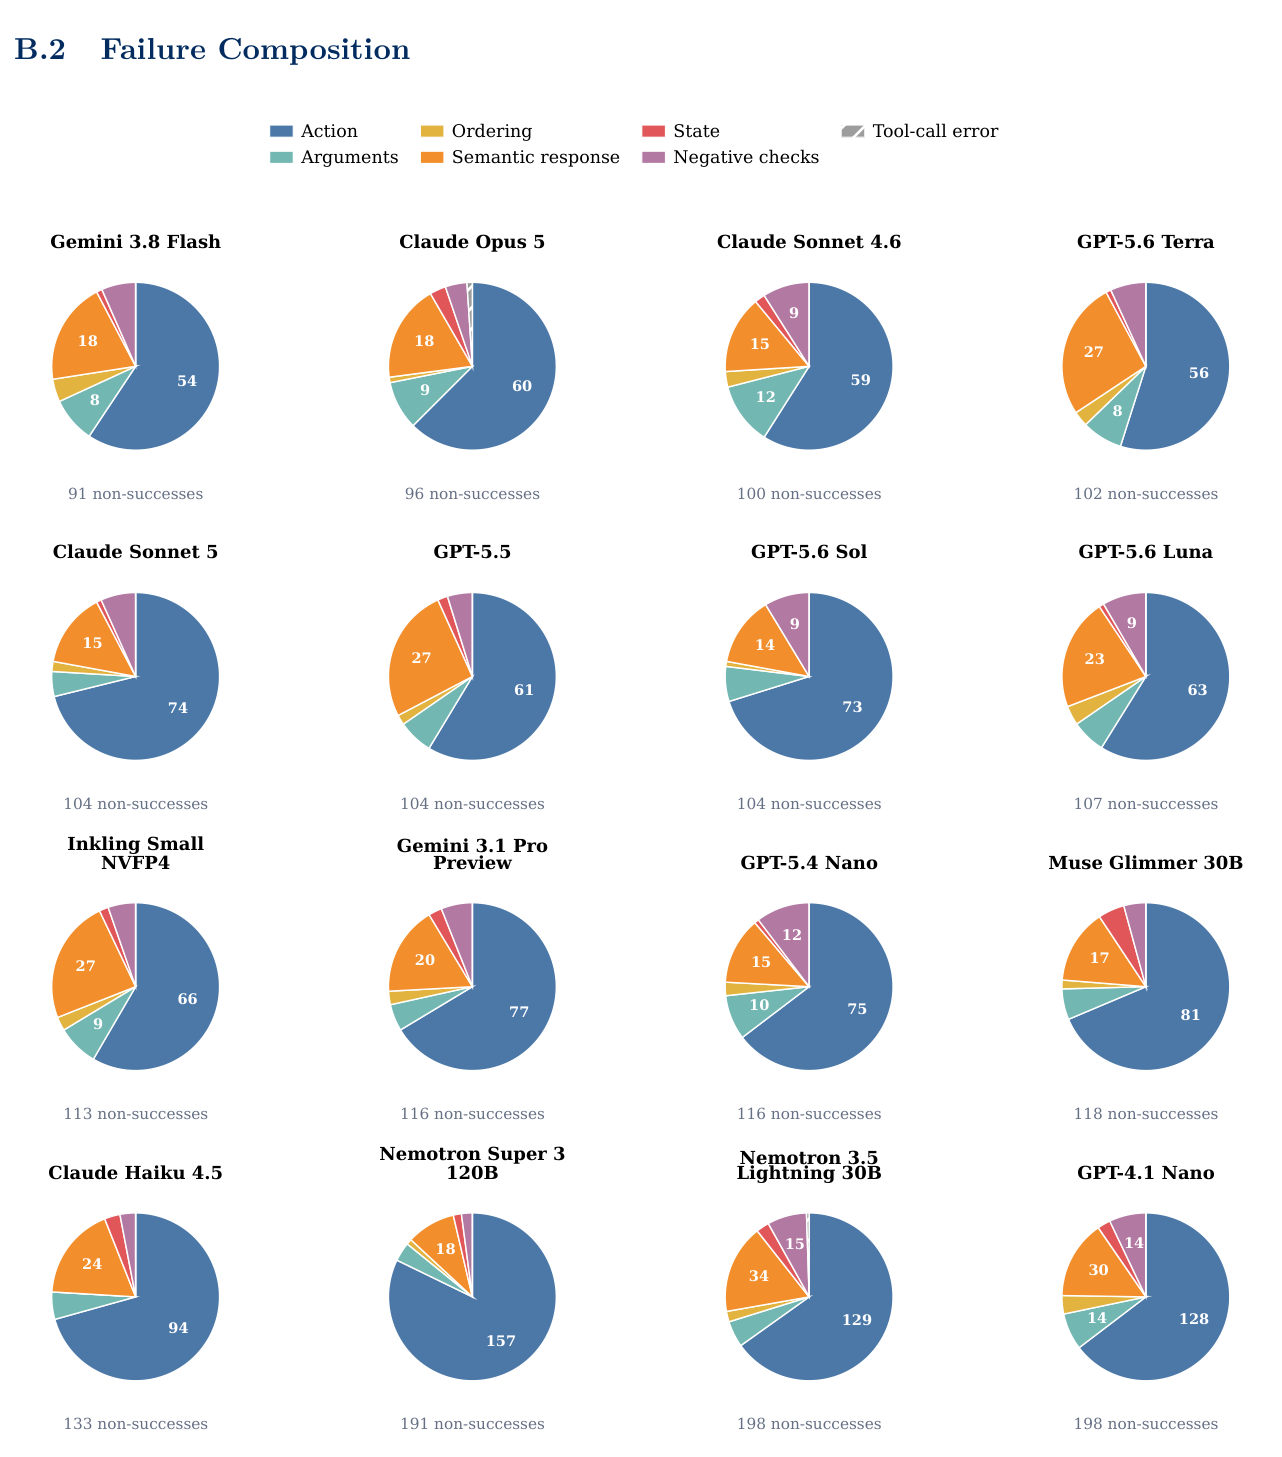
Figure 13 — 각 시스템의 실패 유형을 분석한 Failure Composition 원형 차트
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Novel or Not? PatEx-Gym: Agentic Prior-Art Search for Novelty Assessment in Patent Examination
- [논문리뷰] EmbodiedLab: Benchmarking Embodied Agents That Act to Know
- [논문리뷰] Continual Learning Exam: Benchmarking Long-Horizon RSI and Experiential Learning in LLM Agents
- [논문리뷰] UserArena: Benchmarking Interactive User Simulation for Long-Horizon Shopping Agents
- [논문리뷰] Dual Exam: Controlled Evaluation of Multimodal Agents and World Models
Review 의 다른글
- 이전글 [논문리뷰] Build, Don't Play: Self-Improving LLM Research Agents Develop a Hearthstone Battlegrounds AI That Rivals Top Players
- 현재글 : [논문리뷰] CRM-Agent-Bench: Benchmarking Tool-Using Agents in Stateful Enterprise Environments
- 다음글 [논문리뷰] CausalAlign: Causal Alignment of Video Generation Models for Consistent Ego-Motion
댓글