[논문리뷰] CausalAlign: Causal Alignment of Video Generation Models for Consistent Ego-Motion
링크: 논문 PDF로 바로 열기
메타데이터
저자: Kai Zhu, Yintianrun Zhang, Shuwei Jiang, Ruolin Zuo, Yixin Chen, Duomin Wang, Miao Liu, Yin Li, Daquan Zhou, Yiwu Zhong
1. Key Terms & Definitions (핵심 용어 및 정의)
- Ego-Motion: 비디오 내 연속된 프레임 간의 시점 변화를 지칭하며, 카메라의 움직임과 3D 기하학적 일관성을 결정하는 핵심 요소입니다.
- Geometric State Forgetting: 비디오 생성 과정(Denoising)의 후반부로 갈수록 모델 내부에서 ego-motion 정보가 점차 소실되는 현상을 의미합니다.
- Delta-Token Alignment: 연속된 프레임 간의 기하학적 차이(delta)를 3D Foundation Model로부터 학습하여, VGM(Video Generation Model)의 내부 상태에 주입함으로써 ego-motion 일관성을 강화하는 기법입니다.
- Causal Diagnosis: Linear Probing과 Causal Intervention을 통해 VGM 내부의 어느 계층(Layer)과 시점(Timestep)에서 ego-motion 정보가 표현되고 소실되는지 식별하는 분석 프레임워크입니다.
- World Action Models (WAMs): 로봇의 모바일 조작 작업 등에서 외부 환경 변화를 예측하고 그에 따른 행동을 계획하는 모델입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 최신 Diffusion-based Video Generation Models (VGMs)가 시각적으로는 우수하나 장기적인 카메라 Ego-Motion을 일관성 있게 유지하지 못하는 문제를 해결하고자 합니다. 기존 연구들은 외부 3D 캐시를 사용하거나 복잡한 정렬 방식을 도입했으나, 이는 계산 복잡도를 높이거나 VGM 자체의 기하학적 상태를 직접적으로 강화하지 못하는 한계가 있습니다 [Figure 1]. 특히 VGM이 로봇 공학의 World Action Models (WAMs)에 통합될 때, 기하학적 불일치는 다운스트림 작업에서 시스템적인 오류를 유발할 수 있습니다. 따라서 저자들은 VGM 내부의 ego-motion 정보 처리 메커니즘을 규명하고 이를 효과적으로 보존하는 새로운 방법을 탐색합니다.
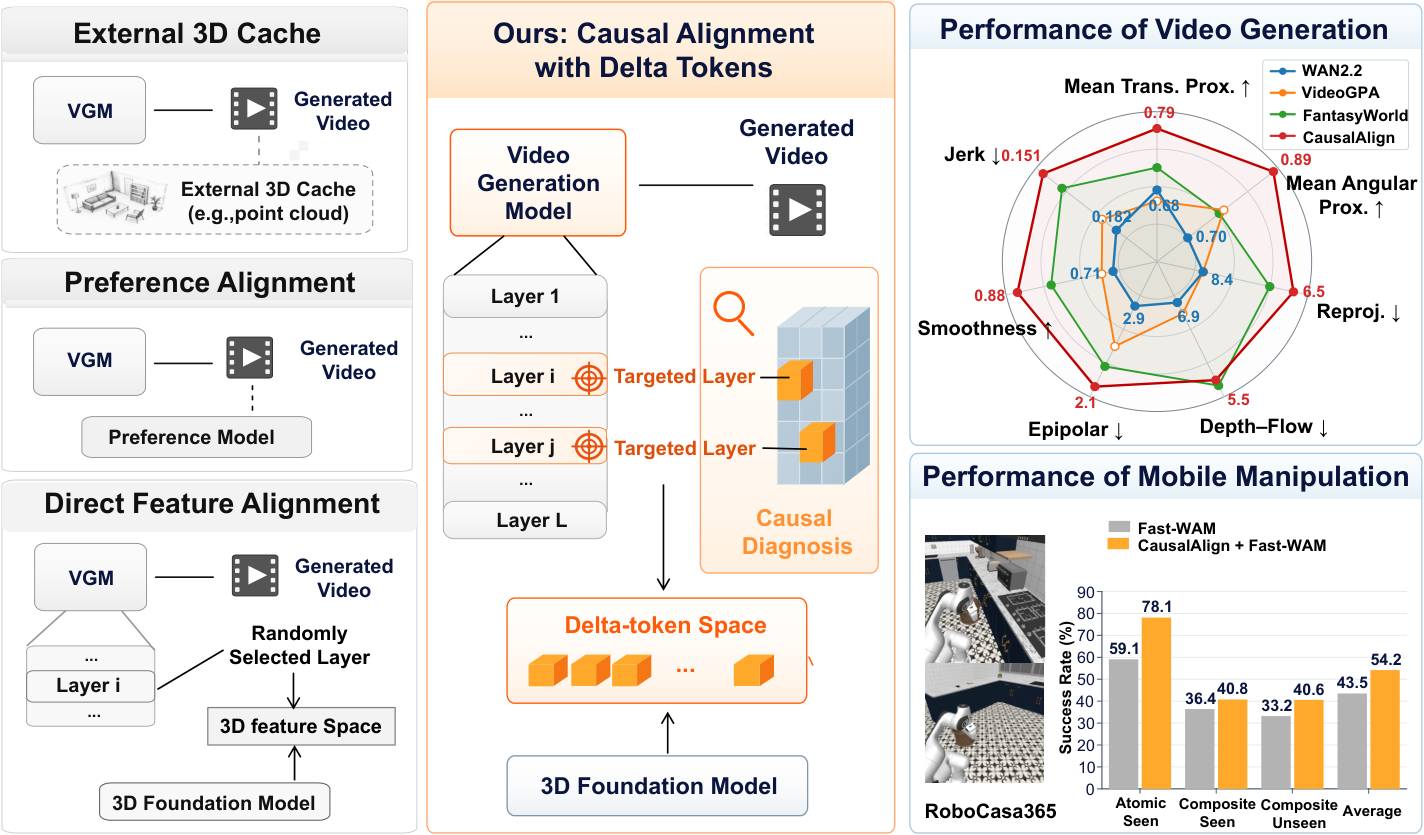
Figure 1 — CausalAlign의 전체 개념도
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 CausalAlign이라는 프레임워크를 제안하여 VGM의 ego-motion 일관성을 강화합니다. 먼저 Causal Diagnosis를 통해 모델 내에서 ego-motion 정보가 '상승 후 하락(rise-and-fall)'하는 패턴을 발견하고, 정보가 소실되는 특정 레이어와 타임스텝을 식별합니다 [Figure 3]. 이후 Delta-Token Alignment를 통해 3D Foundation Model로부터 추출한 기하학적 차이(delta tokens)를 식별된 레이어의 LoRA 어댑터에 주입하여 학습시킵니다 [Figure 2]. 실험 결과, CausalAlign은 Wan2.2 대비 Reprojection Error를 22.6% 감소시키고, Trajectory Smoothness를 23.9% 향상시키는 등 우수한 기하학적 일관성을 달성했습니다 [Table 1]. 또한, 로봇 모바일 조작 작업(RoboCasa365)에서 WAM의 성공률을 기존 43.5%에서 54.2%로 대폭 개선하며 시각적 품질은 그대로 유지하는 정량적 성과를 보였습니다 [Table 2].
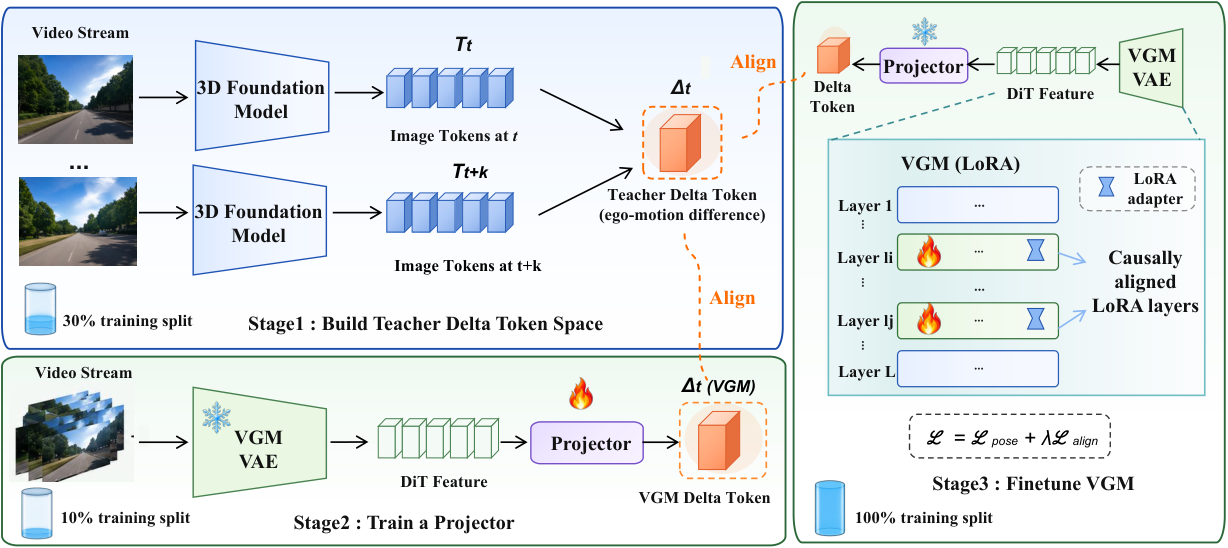
Figure 2 — CausalAlign의 3단계 학습 과정
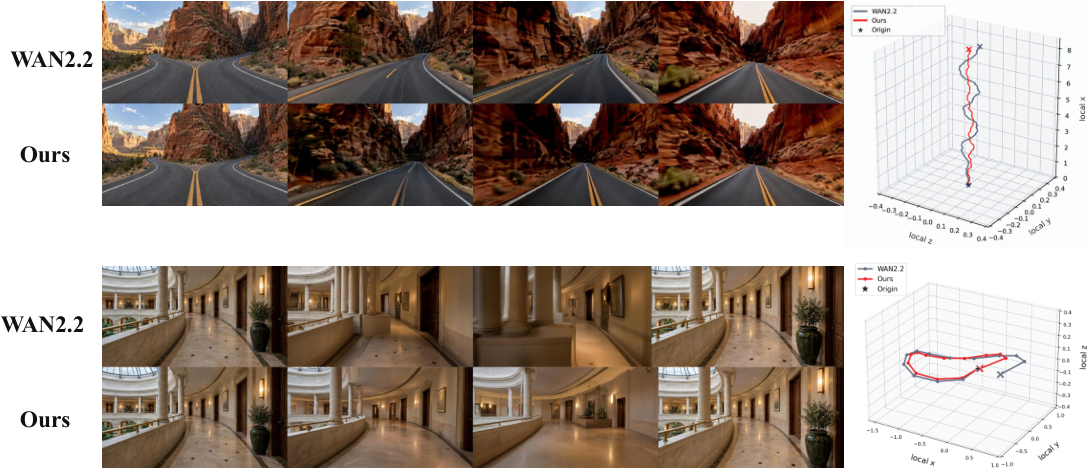
Figure 3 — Ego-motion 진단 및 정보 유지 분석
4. Conclusion & Impact (결론 및 시사점)
본 연구는 diffusion 모델 내의 기하학적 정보 소실 문제인 'Geometric State Forgetting'을 밝혀내고, 이를 causal 분석과 delta-token 정렬을 통해 효과적으로 해결했습니다. CausalAlign은 추론 단계에서 추가적인 계산 자원 없이도 ego-motion 일관성을 크게 향상시킬 수 있는 효율적인 접근법을 제시합니다. 본 방법론은 비디오 생성 분야뿐만 아니라, 로봇의 실세계 행동 예측과 같은 임베디드 AI 분야 전반에 걸쳐 기하학적으로 일관된 시뮬레이션 모델을 구현하는 데 중요한 기술적 토대를 제공합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] RoboHarness: A Simple Harness Outperforms VLA and World Action Models
- [논문리뷰] Self-Distilling Future Video Representations for World Action Models
- [논문리뷰] Agentic World Action Models
- [논문리뷰] BridgeWAM: Bridging Video and Action Experts via Latent Bridge Queries
- [논문리뷰] RealtimeWAM: One-Step Asynchronous World Action Models
Review 의 다른글
- 이전글 [논문리뷰] CRM-Agent-Bench: Benchmarking Tool-Using Agents in Stateful Enterprise Environments
- 현재글 : [논문리뷰] CausalAlign: Causal Alignment of Video Generation Models for Consistent Ego-Motion
- 다음글 [논문리뷰] Constrained Decoding: Harmful or Beneficial? Revisiting Its Impact on LLM Performance
댓글