[논문리뷰] Self-Distilling Future Video Representations for World Action Models
링크: 논문 PDF로 바로 열기
메타데이터
저자: Huiwon Jang, Suhyeok Jang, Hyeonmo Kang, Seungku Kim, Jinwoo Shin, Sihyun Yu, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- World Action Models (WAMs): Pre-trained Video Diffusion Models (VDMs)의 spatiotemporal priors를 활용하여 미래 비디오를 예측함과 동시에 로봇 제어 정책을 학습하는 프레임워크입니다.
- Future Representation Generator: VDM의 초기 레이어들이 Gaussian noise를 입력으로 받아, 로봇의 미래 움직임에 관한 예측 정보를 담고 있는 중간 hidden state를 생성하는 기능을 지칭합니다.
- Self-Distillation: 학생(Student) 네트워크가 교사(Teacher) 네트워크의 출력 분포를 모방하도록 학습하여, 노이즈로부터 더 품질 높은 미래 표현을 생성하도록 유도하는 학습 기법입니다.
- CKNNA (Cross-Key Nearest Neighbor Alignment): 두 모델의 표현 간 구조적 유사성을 정량적으로 평가하기 위해 사용되는 지표입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
최신 WAM들은 계산 효율성을 위해 VDM의 단일 전방향 통과(single forward pass)에서 추출한 중간 hidden state를 활용하여 로봇 행동을 추론합니다. 그러나 이러한 hidden state는 노이즈에서 생성되기 때문에, 실제 미래 관측 데이터에서 추출한 표현보다 정보 전달력이 부족하다는 한계가 있습니다. 기존 연구들은 비디오 생성 품질을 높이거나 외부 인코더를 정렬하는 데 집중했으나, 정작 행동 제어에 직접 사용되는 '노이즈 기반 미래 표현'의 품질을 직접 개선하는 접근은 부족했습니다 [Figure 1]. 따라서 본 논문은 행동 제어 성능을 극대화하기 위해 이러한 미래 표현의 품질을 개선하는 새로운 학습 프레임워크를 제안합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 FRED (Future REpresentation learning via self-Distillation with temporal context) 프레임워크를 제안하여 VDM의 중간 표현 생성 능력을 최적화합니다. FRED는 momentum teacher를 사용하여 실제 미래 관측값에서 추출한 목표 표현을 생성하고, 학생 모델이 노이즈로부터 이를 모방하도록 Self-Distillation을 수행합니다 [Figure 2]. 또한, 과거 관측값(historical observations)을 입력으로 함께 제공함으로써 더 풍부한 시간적 문맥(temporal context)을 활용합니다. 실험 결과, FRED는 제로샷 환경 일반화(Zero-shot Environment Generalization)에서 DreamZero 대비 긴 지평(long-horizon) 과제 성공률을 61.7%에서 81.7%로, 도메인 외(out-of-domain) 과제 성공률을 10.4%에서 52.1%로 대폭 향상시켰습니다 [Table 1]. 인간-로봇 기술 전이(Human-to-robot skill transfer) 과제에서도 FRED는 50.0%의 높은 과제 성공률을 기록하여, 19.4%에 그친 최상위 경쟁 모델을 크게 앞섰습니다 [Table 2]. 특히, 제어 성능은 비디오 생성 품질보다 '노이즈로부터 생성된 미래 표현의 품질'과 강력한 상관관계(r=0.89)를 보임을 입증했습니다 [Figure 4].
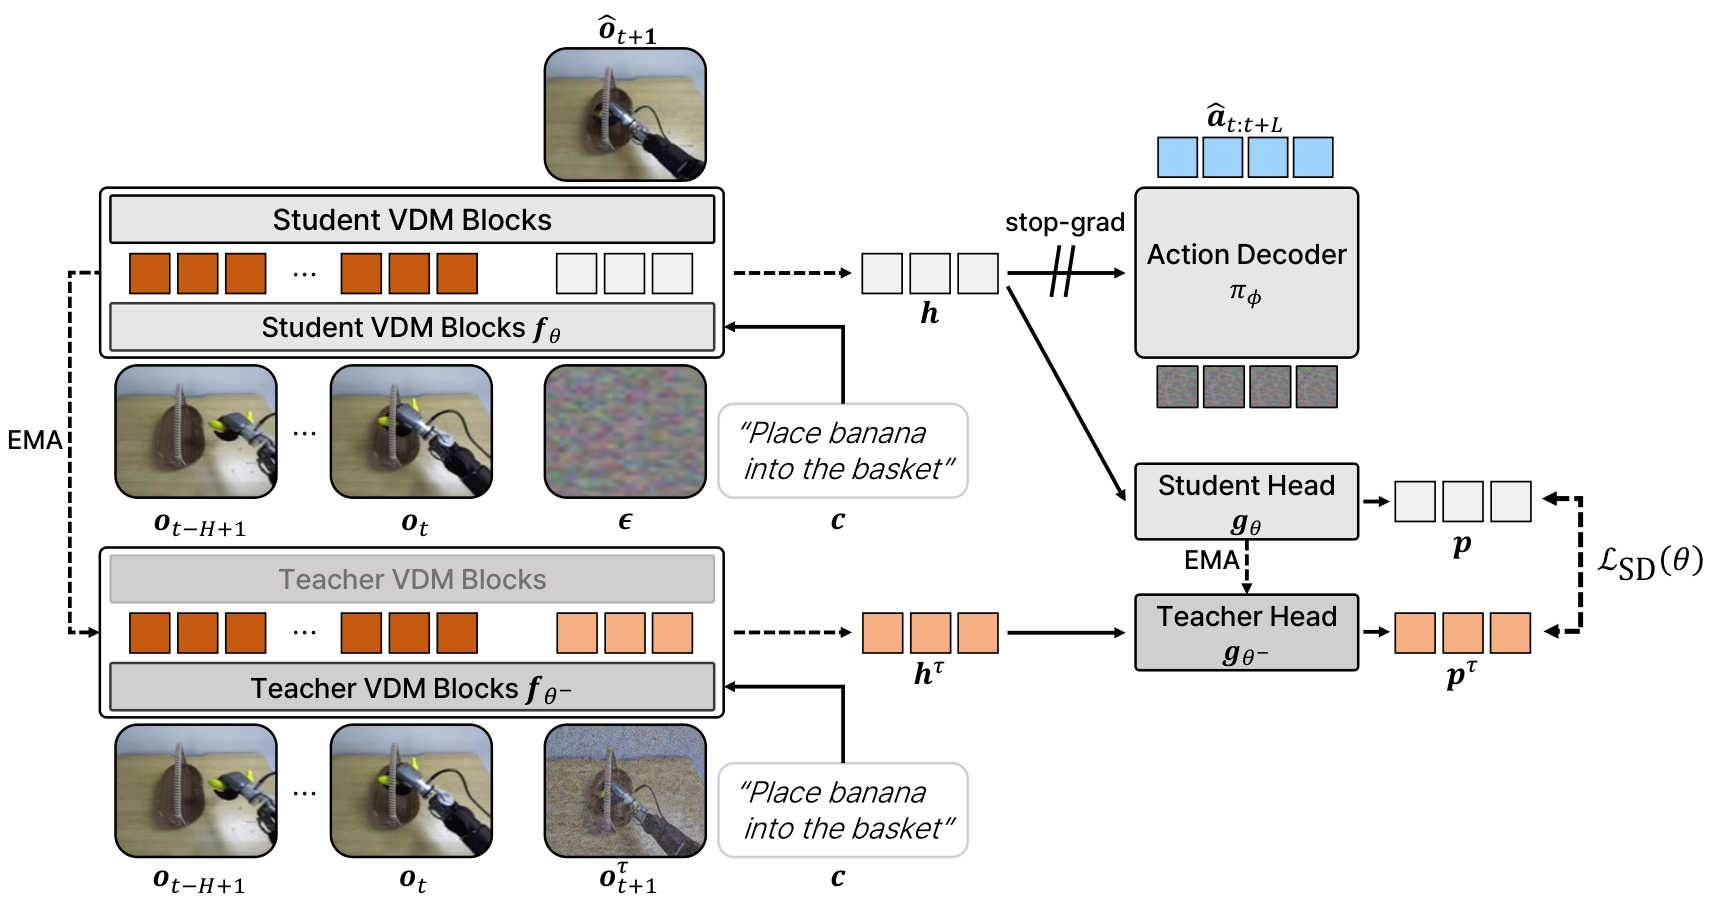
Figure 2 — FRED 프레임워크 개요
4. Conclusion & Impact (결론 및 시사점)
본 연구는 VDM을 미래 표현 생성기로 재해석하고, Self-Distillation을 통해 노이즈 환경에서도 고품질의 표현을 추출할 수 있는 FRED를 제안했습니다. 이 연구는 로봇 제어를 위한 비디오 기반 모델 학습에 있어 제어 성능과 직접적으로 직결되는 표현 학습의 중요성을 강조합니다. FRED는 다양한 실제 로봇 환경에서 범용적인 일반화 성능을 입증했으며, 향후 로봇 데이터가 부족한 환경에서 인간 비디오 데이터를 효과적으로 활용하는 강력한 방법론으로서 산업계 및 학계에 중요한 기여를 할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Looking Ahead: Modeling Future Evolution in Autoregressive Video Generation
- [논문리뷰] RealtimeWAM: One-Step Asynchronous World Action Models
- [논문리뷰] InternW0-Δ: A World Action Model Bridging Predictive Dynamics and Actions with 20K+ Hours of Open Data
- [논문리뷰] ImageWAM: Do World Action Models Really Need Video Generation, or Just Image Editing?
- [논문리뷰] LaWAM: Latent World Action Models for Efficient Dynamics-Aware Robot Policies
Review 의 다른글
- 이전글 [논문리뷰] SEAM: Spectral Embedding Alignment and Merging for Low-Resource TTS
- 현재글 : [논문리뷰] Self-Distilling Future Video Representations for World Action Models
- 다음글 [논문리뷰] Skeleton-Grounded Latent Action Model for Robot World Models
댓글