[논문리뷰] Skeleton-Grounded Latent Action Model for Robot World Models
링크: 논문 PDF로 바로 열기
메타데이터
저자: Qi Lv, Jiayi Lin, Yuxin Jiang, Jianzong Wang, Xiang Deng, Mike Shou Zheng
1. Key Terms & Definitions (핵심 용어 및 정의)
- Latent Action Model: 비디오 데이터로부터 시각적 전이를 프록시 액션(proxy actions)으로 인코딩하여 환경의 역학을 학습하는 모델입니다.
- SkeLAM (Skeleton-Grounded Latent Action Model): 로봇의 skeleton 정보를 활용하여 latent action을 kinematic 컴포넌트와 residual 컴포넌트로 분리하고, 이를 통해 제어 가능한 로봇 월드 모델링을 수행하는 제안 모델입니다.
- Cross-modal Swap Reconstruction: RGB와 skeleton 정보를 상호 교환적으로 학습하여 두 모달리티 간의 모션 표현 호환성을 극대화하는 학습 기법입니다.
- Branch Dropout: world model 학습 과정에서 kinematic 또는 residual 브랜치를 임의로 드롭하여, 추론 시점의 액션 기반 제어 상황에 모델이 적응하도록 돕는 정규화 기법입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존 reconstruction 기반의 latent action 모델들이 로봇의 모션과 환경의 변화(object responses 등)를 구분하지 못하고 혼합하여 학습함으로써 제어의 정확도가 떨어지는 문제를 해결하고자 합니다. 기존 연구(Baseline)들은 visual transitions를 단순히 latent space에 매핑하기 때문에, 로봇의 제어 입력과 latent action 간의 대응 관계가 모호해지는 한계를 가집니다 [Figure 1]. 이러한 불분명한 대응 관계는 로봇이 복잡한 환경에서 상호작용할 때 정확한 미래 상태를 예측하는 데 방해가 되며, 결과적으로 액션 기반의 월드 모델링 성능을 저하시킵니다. 따라서 저자들은 로봇의 골격(skeleton) 정보를 명시적으로 활용하여 모션(kinematic)과 시각적 역학(residual)을 분리함으로써, 제어 가능한 로봇 월드 모델을 설계할 필요성을 제기합니다.
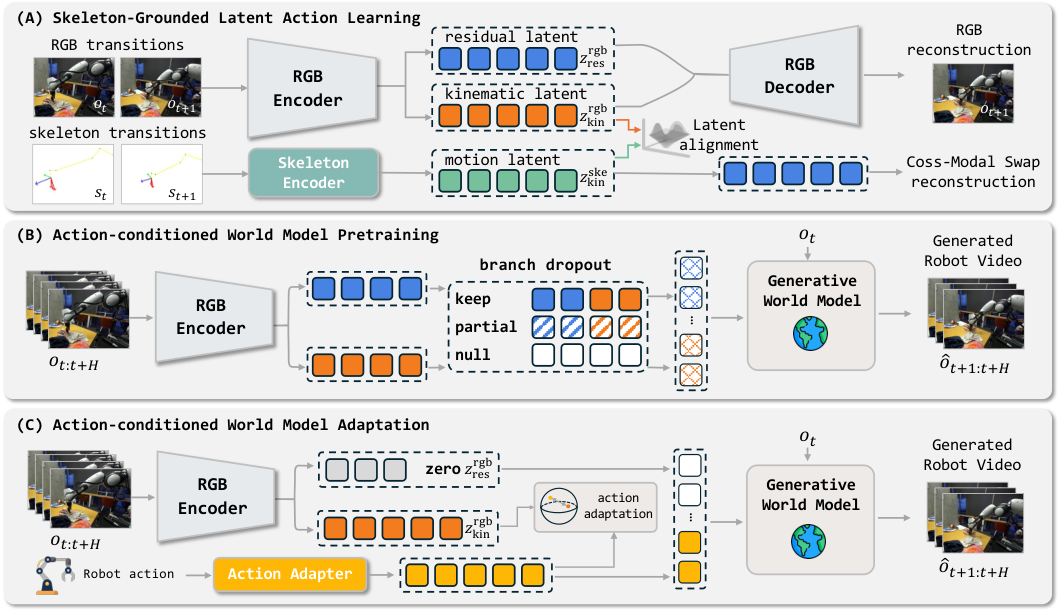
Figure 1 — SkeLAM 전체 아키텍처
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 SkeLAM을 제안하여 latent action을 로봇 모션에 대응되는 kinematic 컴포넌트와 나머지 residual 컴포넌트로 구조화합니다 [Figure 1]. 저자들은 skeleton supervision을 도입하여 kinematic latent가 로봇의 움직임에 grounded 되도록 설계하였으며, cross-modal swap reconstruction을 통해 RGB와 skeleton latent가 상호 교환 가능하게 학습되도록 하였습니다 [Figure 2]. 또한, branch dropout과 lightweight adapter를 활용하여 로봇의 액션을 예측된 kinematic latent에 매핑하고 월드 모델을 미세 조정(fine-tuning)합니다 [Figure 1]. DROID 데이터셋을 이용한 실험 결과, SkeLAM은 기존 DreamDojo 대비 end-effector ADE를 19.5%, LPIPS를 11.1% 감소시키며 모션 정확도와 시각적 충실도 모두에서 우수한 성능을 보였습니다 [Table 1]. 특히, 모션 프로빙(motion probing) 분석을 통해 제안하는 kinematic 컴포넌트가 더 적은 차원수로도 더 높은 성능을 보임을 확인하였으며, 제로샷(zero-shot) 환경에서의 human-to-robot 모션 전이 성능을 입증하였습니다 [Figure 5].
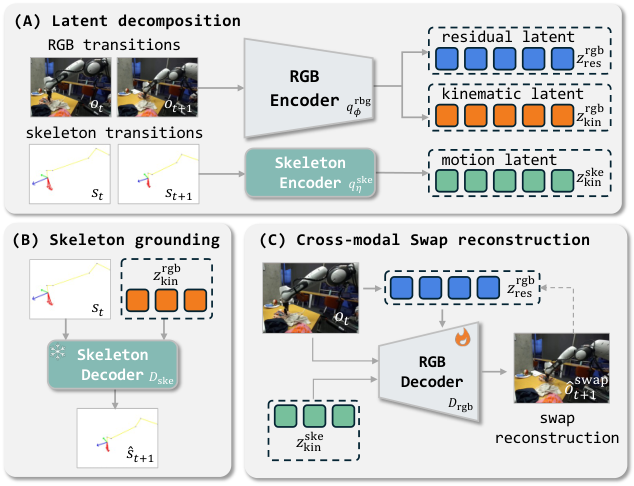
Figure 2 — Skeleton-grounded 학습 방식
4. Conclusion & Impact (결론 및 시사점)
본 논문은 skeleton 정보를 활용한 latent action의 구조적 분리가 로봇의 월드 모델링 및 제어 성능 향상에 핵심적임을 입증했습니다. SkeLAM은 모션 표현의 전문성을 높이고 시각적 노이즈를 효과적으로 분리함으로써, 보다 정확한 미래 상태 예측과 로봇 정책 평가를 가능하게 합니다. 이 연구는 향후 로봇 공학에서 비디오 기반의 학습 시스템이 어떻게 도메인 지식(skeleton 등)을 결합하여 실질적인 로봇 제어 성능으로 이어질 수 있는지에 대한 중요한 가이드라인을 제시합니다. 또한, 인간의 모션을 로봇에게 전이하는 가능성을 보여줌으로써, 로봇 학습 데이터 부족 문제를 해결하는 데 큰 잠재력을 시사합니다.
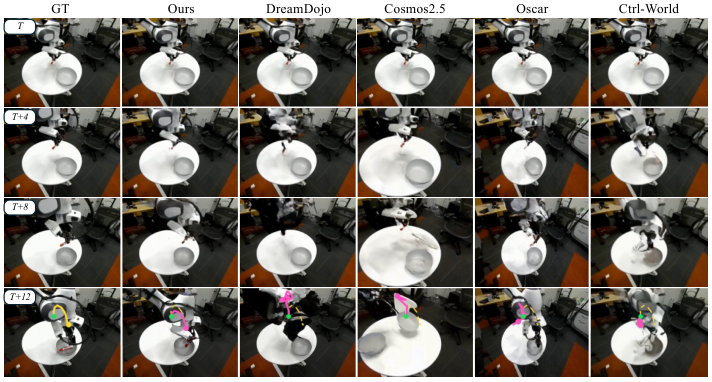
Figure 3 — 월드 모델링 정성적 비교
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] WorldLine: Action-Driven Visual Simulation for Robotic Manipulation
- [논문리뷰] ActionSplice: In-Flight Action Editing for Interactive World Models
- [논문리뷰] SyncWorld: Visual Calibration Enables World Models as Zero-Shot Simulators
- [논문리뷰] ShadowDancer: Teaching Video World Models Any Action by Learning Unified Dynamics Representations from a Video and Its Shadow
- [논문리뷰] RynnWorld-Teleop: An Action-Conditioned World Model for Digital Teleoperation
Review 의 다른글
- 이전글 [논문리뷰] Self-Distilling Future Video Representations for World Action Models
- 현재글 : [논문리뷰] Skeleton-Grounded Latent Action Model for Robot World Models
- 다음글 [논문리뷰] SplatLab: Autonomous Scientific Discovery for 3DGS Research
댓글