[논문리뷰] ActionSplice: In-Flight Action Editing for Interactive World Models
링크: 논문 PDF로 바로 열기
메타데이터
저자: Pardis Taghavi, Tingyu Guo, Jonas Lossner, Gaurav Pandey, Reza Langari
1. Key Terms & Definitions (핵심 용어 및 정의)
- CST (Counterfactual State Transport): 중간 solver step에서 이전의 액션으로 인해 생성된 상태를, 수정된 액션이 가해졌을 때 도달했어야 할 이상적인 상태로 직접 변환(Transport)하는 핵심 프레임워크입니다.
- Chunk-autoregressive: 비디오를 여러 프레임 단위의 청크로 나누어 순차적으로 생성하는 방식으로, 기존에는 한 번 시작된 청크 내에서 액션 수정이 불가능했습니다.
- CST_R (Retargeting): 액션 변경 시 전체 액티브 청크(active chunk)에 수정된 액션을 일괄 적용하는 모드입니다.
- CST_T (Temporal-splicing): 청크 내 특정 시점(boundary)을 기준으로 이전은 원래 액션을, 이후는 수정된 액션을 적용하는 세밀한 제어 모드입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 interactive video world model에서 생성 과정 중 발생하는 액션 수정 요구사항에 대해 즉각적인 응답성을 제공하기 위해 ActionSplice를 제안합니다. 기존의 chunk-autoregressive 모델은 한 번 생성되기 시작한 청크의 상태가 이전 액션에 종속되어 있어, 새로운 액션이 입력될 경우 다음 청크를 기다리거나(Latency 증가), 전체 생성 과정을 되돌리는(Rollback) 비효율적인 방식을 사용했습니다 [Figure 2]. 이러한 기존 방식들은 제어 지연(control latency)을 유발하거나, 이미 완료된 컴퓨팅 자원을 낭비하는 한계가 있습니다. 따라서 본 연구는 생성 과정을 멈추지 않으면서도 액션 변경을 반영할 수 있는 효율적인 상태 수정 방안을 해결하고자 합니다 [Figure 1].
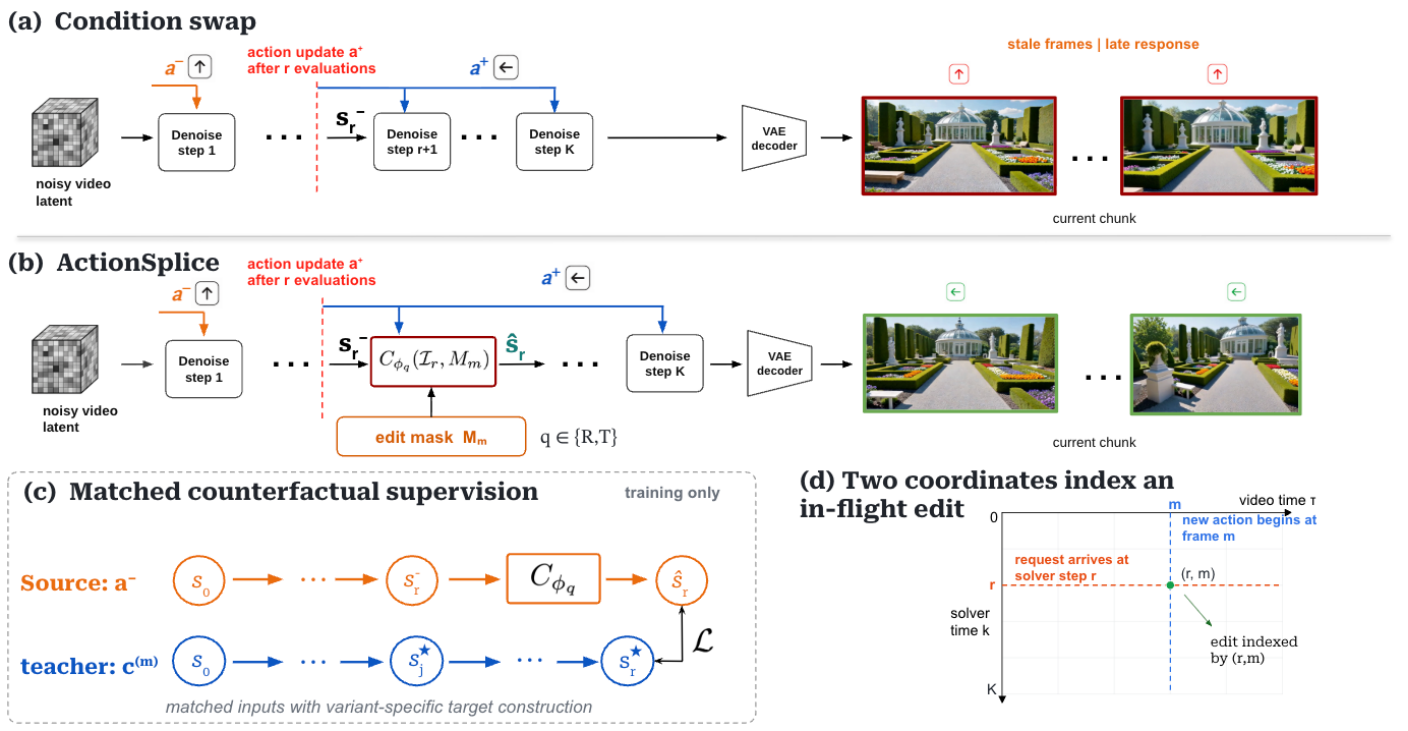
Figure 1 — ActionSplice 프레임워크 개요
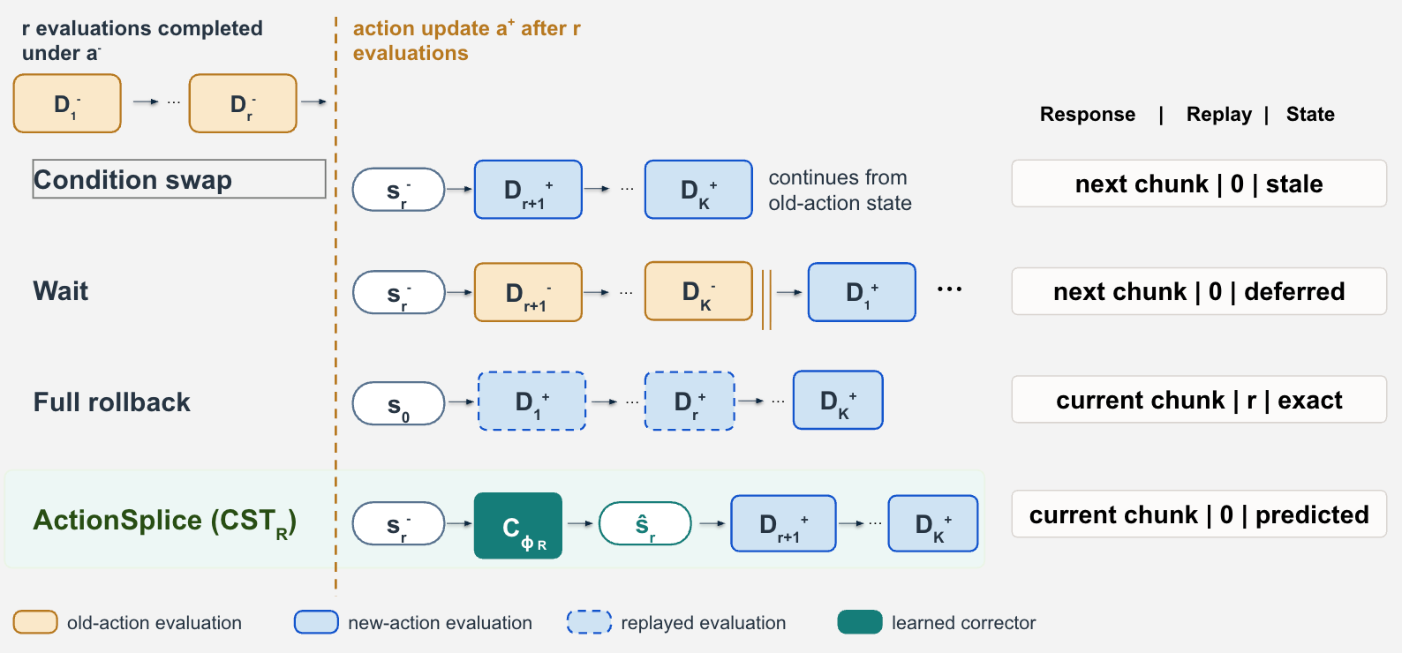
Figure 2 — 액션 업데이트 방식별 비교
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 Frozen된 world model의 샘플러를 수정하지 않고, lightweight corrector를 통해 interrupted 상태를 counterfactual target 상태로 이동시키는 CST를 도입하였습니다 [Figure 1]. CST_R은 전체 청크를 재설정하여 비동기적 액션 변경에 대응하며, CST_T는 temporal boundary를 설정하여 청크 내부에서의 세밀한 액션 전환을 가능하게 합니다 [Figure 1]. 실험 결과, CST_R은 minWM backbone에서 기존 condition swapping 대비 LPIPS를 61.5% 감소시켰으며, HY-WM1.5에서는 75.9% 개선하였습니다 [Table 1]. CST_T 역시 수동 방식인 'waiting' 대비 각각 2.73배, 1.69배의 속도 향상을 기록하면서도, 접미사(suffix) 부분의 LPIPS를 획기적으로 개선하며 우수한 정량적 지표를 달성하였습니다 [Table 2]. 결과적으로, 본 방법론은 픽셀 레벨에서 고품질의 제어 반응성을 보장하며, 복잡한 롤백 과정 없이도 거의 오라클(oracle)에 준하는 성능을 유지합니다 [Table 4].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 실시간 interactive video generation에서 필수적인 'in-flight action editing' 문제를 Counterfactual State Transport라는 새로운 관점으로 정립하고 해결하였습니다. ActionSplice는 frozen 된 모델 환경에서도 낮은 제어 지연과 높은 영상 충실도를 동시에 달성함으로써, 차세대 대화형 AI 시스템 및 게임 엔진 개발에 중요한 기술적 토대를 제공합니다. 이 연구는 모델의 재학습이나 복잡한 롤백 없이도 즉각적인 인터랙티브 제어가 가능함을 입증하여, 향후 보다 몰입감 높은 생성형 인터페이스 설계에 널리 활용될 것으로 기대됩니다.
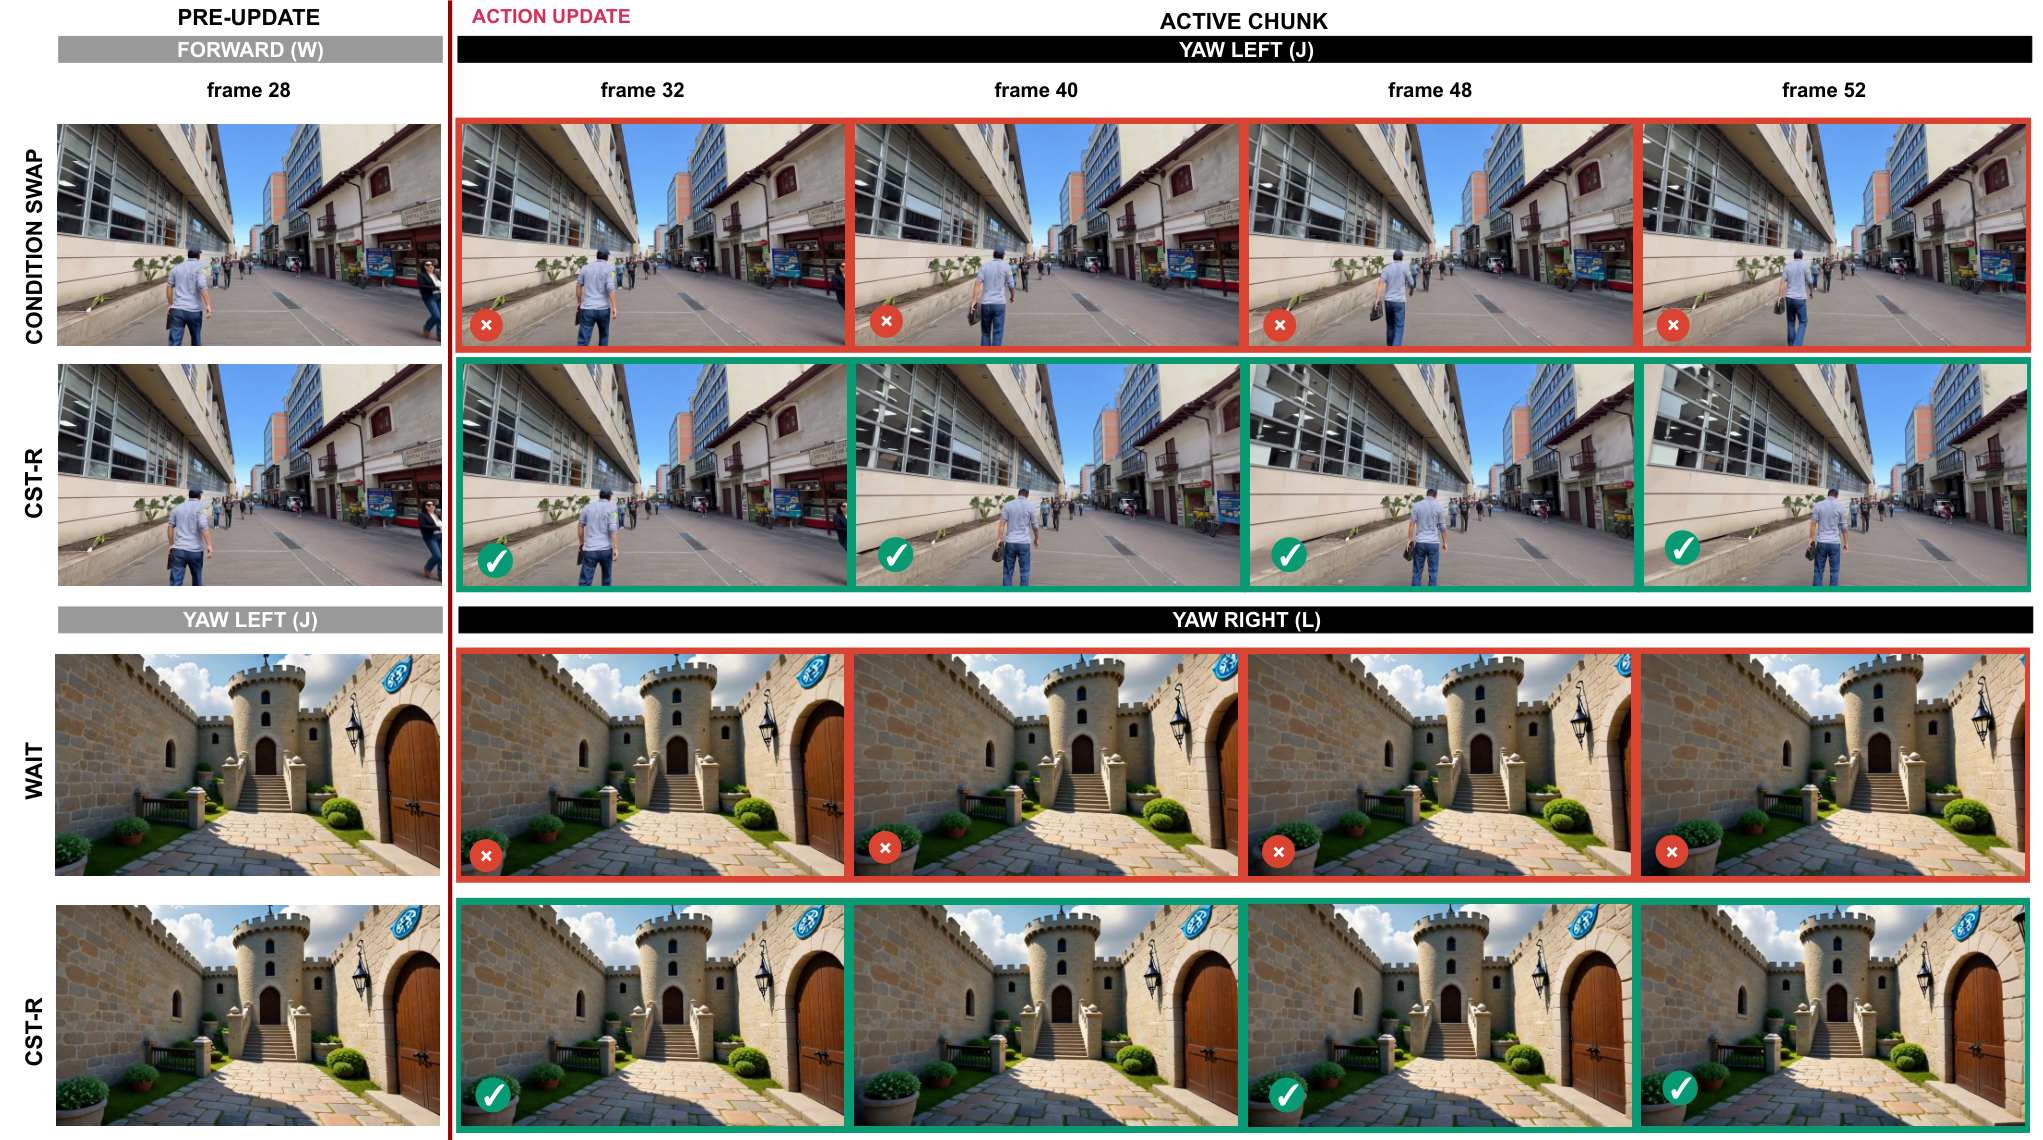
Figure 4 — 정성적 결과 비교
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] AV-GRPO: Modality-Anchored Decoupling Diffusion Reinforcement Learning for Joint Audio-Video Generation
- [논문리뷰] VideoGen-Agent: Reinforcing Video Generation Agents
- [논문리뷰] Streaming Video Editing with Easy Adaptation
- [논문리뷰] Vidu S2: Real-Time Interactive, Editable, and Spatial Video Generation
- [논문리뷰] AlayaVista: Streaming World Modeling from Panoramic States to Perspective Video
Review 의 다른글
- 이전글 [논문리뷰] X-AuT: Progressive Audio-Encoder Compression for Speech LLMs with Cross-Scale Distillation
- 현재글 : [논문리뷰] ActionSplice: In-Flight Action Editing for Interactive World Models
- 다음글 [논문리뷰] Ambient @ EgoLongQA 2026: Distilling Long-Video perception into a Sub-2B Model
댓글