[논문리뷰] Nested Sparsity for Scalable Pretraining and Continual Learning
링크: 논문 PDF로 바로 열기
저자: Tianzhe Chu, Druv Pai, Yi Ma, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- NESTOR: 본 논문에서 제안하는 계층적 희소성(nested sparsity) 기반의 Transformer 아키텍처로, 기존의 MoE가 MLP에만 국한된 희소성을 적용한 것과 달리 Attention 연산까지 희소화한 모델입니다.
- Nested Sparsity: Attention 연산에 대한 희소성(column-routed attention)과 전문가(experts) 단위의 희소성(expert sparsity)을 계층적으로 결합하여, 토큰별로 활성화되는 파라미터 경로를 최적화하는 기법입니다.
- Column-routed attention: 전체 Attention 연산을 여러 개의 독립적인 column으로 분할하고, 라우터를 통해 토큰을 특정 column으로 라우팅하여 전체 파라미터가 아닌 일부 파라미터와 부분적인 context만 활용하는 Attention 구현 방식입니다.
- Attention Residual: 층간 잔차 연결(residual connections)을 단순 합산이 아닌, 학습 가능한 소프트맥스 가중치 혼합(softmax-weighted mixture)을 통해 처리하는 구조로, 각 column의 독립적인 연산을 효과적으로 결합합니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 연구는 대규모 언어 모델(LLM)의 효율적인 pretraining과 도메인 확장(continual learning)을 위해 기존 MoE 모델이 가진 Attention 연산의 고정된 연산 비용 문제를 해결하는 것을 목적으로 합니다. 기존의 MoE 모델은 MLP 계층에만 conditional computation을 적용하여 파라미터 효율성을 달성했지만, Attention 연산은 모든 토큰에 대해 고정된 파라미터를 사용하여 긴 문맥(long context)에서 병목 현상을 야기합니다. 또한, 새로운 도메인으로의 적응 과정에서 발생하는 파라미터의 간섭(catastrophic forgetting) 문제로 인해 기존 지식의 보존과 새로운 학습 사이의 균형이 어렵다는 한계가 있습니다. 이러한 문제를 극복하기 위해 제안된 NESTOR는 Attention과 MLP에 모두 희소성을 적용하여 모델 규모 확장에 따른 연산 효율성을 극대화하고자 합니다.
## 3. Method & Key Results (제안 방법론 및 핵심 결과)
NESTOR는 데이터를 처리하는 과정에서 column router를 통해 토큰을 특정 column으로 배정하고, 각 column 내부에서 다시 expert router를 통해 전문가 MLPs를 활성화하는 계층적 경로 선택 메커니즘을 사용합니다 [Figure 1]. 이러한 설계는 Attention 맵과 전문가 파라미터를 동시에 sparsify하며, 모델 깊이에 따라 활성화되는 column의 수를 조정하여 early layer에서는 국소적인 처리를, 최종 단계에서는 전체 context를 다루는 유연성을 제공합니다. 실험 결과, NESTOR는 동일한 수의 파라미터를 갖는 기존 MoE baseline 대비 1.131.29배, dense 모델 대비 3.14.1배 높은 연산 효율성을 보였습니다 [Table 3]. 또한, continual pretraining 상황에서 NESTOR는 기존 지식을 망각하는 정도가 MoE보다 평균 3% 낮았으며, 문맥 길이 확장에 따른 연산 효율 이득이 context length 증가와 함께 지속적으로 커지는 성능 향상을 확인하였습니다.
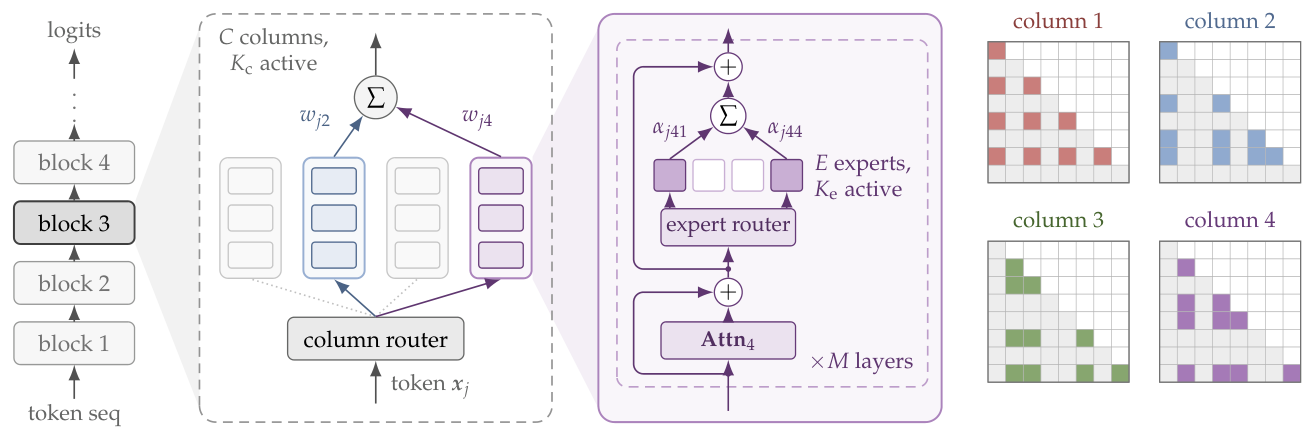
Figure 1 — NESTOR의 계층적 라우팅 구조와 column 기반의 Attention 연산을 명확히 보여주는 핵심 다이어그램
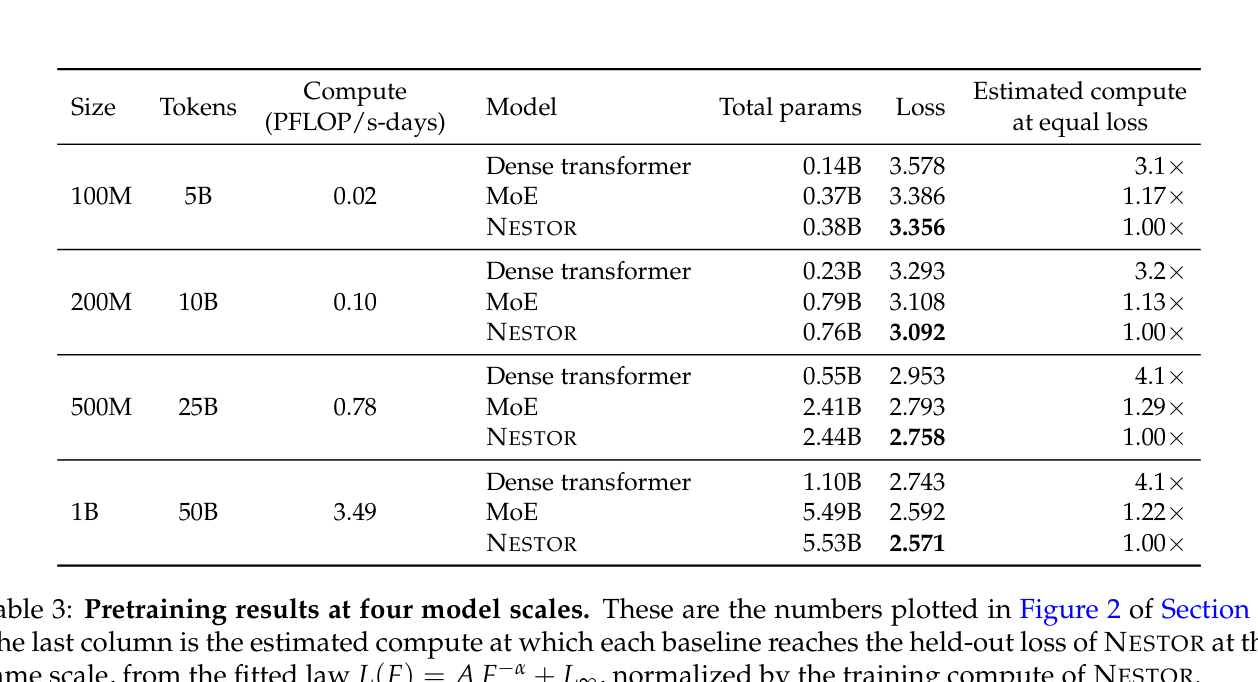
Table 3 — NESTOR와 MoE, Dense 모델의 성능 및 연산 효율성을 정량적으로 비교한 핵심 데이터
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 conditional computation을 MLP를 넘어 Attention 연산으로 확장한 NESTOR를 통해 Transformer 아키텍처의 새로운 설계 방향을 제시합니다. 이 계층적 희소성 구조는 pretraining의 연산 효율을 개선할 뿐만 아니라, 모델의 확장성과 도메인 적응 능력을 크게 향상시켰습니다. 이러한 연구는 모델 규모가 커짐에 따라 더욱 심화되는 연산 자원 확보 문제를 해결하고, 지식 보존이 중요한Continual Learning 환경에서 더욱 견고한 모델을 구축할 수 있는 이론적, 실무적 기반을 마련했습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Multi-Stream Attention Residuals
- [논문리뷰] On the Scaling of PEFT: Towards Million Personal Models of Trillion Parameters
- [논문리뷰] Arcee Trinity Large Technical Report
- [논문리뷰] Hybrid Architectures for Language Models: Systematic Analysis and Design Insights
- [논문리뷰] Semantic Concept Steering Breaks the Explanation Drift Loop in Continual Learning
Review 의 다른글
- 이전글 [논문리뷰] Mycelium: A Meta-Study of Hallucination Detection Across Provenance, Typology, and Granularities
- 현재글 : [논문리뷰] Nested Sparsity for Scalable Pretraining and Continual Learning
- 다음글 [논문리뷰] Novel or Not? PatEx-Gym: Agentic Prior-Art Search for Novelty Assessment in Patent Examination
댓글