[논문리뷰] Semantic Concept Steering Breaks the Explanation Drift Loop in Continual Learning
링크: 논문 PDF로 바로 열기
저자: Yehonatan Elisha, Oren Barkan, Noam Koenigstein et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Explanation Drift: 모델이 예측 정확도는 유지하지만, 진단적 특징(diagnostic features)에서
spurious correlations(허위 상관관계)로 주의(attention)를 조용히 이동시키는 현상입니다. - Self-Referential Drift Loop: 기존
pixel-level saliency regularization방식에서 모델의 고정된saliency map으로부터supervision target을 도출하여, 모델이spurious attention을cross-task로 적극적으로 강화하는 구조적 결함을 지칭합니다. - C^3^L (Concept-Consistent Continual Learning):
self-referential drift loop를 해결하기 위해 모델 상태와 독립적으로offline에서 발견된class-consistent semantic concepts에regularization을anchoring하는 프레임워크입니다. - Crowding-Out Effect:
approximate LRP relevance conservation하에서semantic적으로grounding된concept regions내에 높은relevance를 부여함으로써,explicit penalization없이도spurious background attributions을 암묵적으로 억제하는 효과입니다. - Semantic Concepts: 논문 내에서 "curved beak" 또는 "striped pattern"과 같이
human-interpretable하며class-consistent하고model-state-independent한 시각적 속성(visual attributes)을 의미합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 continual learning (CL) 시스템에서 발생하는 catastrophic forgetting이 단순한 accuracy degradation을 넘어 explanation drift로 나타나는 근본적인 문제를 해결하고자 합니다. 기존 CL 연구들은 주로 predictive accuracy 유지에 초점을 맞추었으나, 모델이 diagnostic features에서 spurious correlations로 주의를 전환하면서도 accuracy를 유지하는 explanation drift 현상은 standard metrics로 포착되지 않습니다. 이러한 drift는 distribution shift 환경에서 performance collapse를 야기할 수 있는 critical한 문제입니다.
기존 explanation-aware CL 방법들은 pixel-level saliency map을 regularization하여 explanation drift를 완화하려 시도했지만, model's own frozen saliency maps에서 supervision targets를 도출하는 structural flaw인 self-referential drift loop를 가지고 있습니다. 이 loop는 모델이 이미 spurious features에 drift된 경우, 이러한 패턴이 regularization target이 되어 cross-task로 spurious attention을 강화하는 결과를 초래합니다. 따라서 target independence와 cross-instance semantic consistency를 보장하는 새로운 approach가 절실히 요구됩니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 self-referential drift loop를 파괴하기 위한 새로운 Concept-Consistent Continual Learning (C^3^L) 프레임워크를 제안합니다 [Figure 2]. C^3^L은 offline에서 model state와 독립적으로 class-consistent semantic concepts를 발견하고 grounding함으로써 regularization의 target을 anchor합니다. 이를 위해 automated concept discovery에는 Large Language Models (LLMs)을, spatial grounding에는 SAM 3를 활용하여 manual annotation의 부담을 제거합니다.
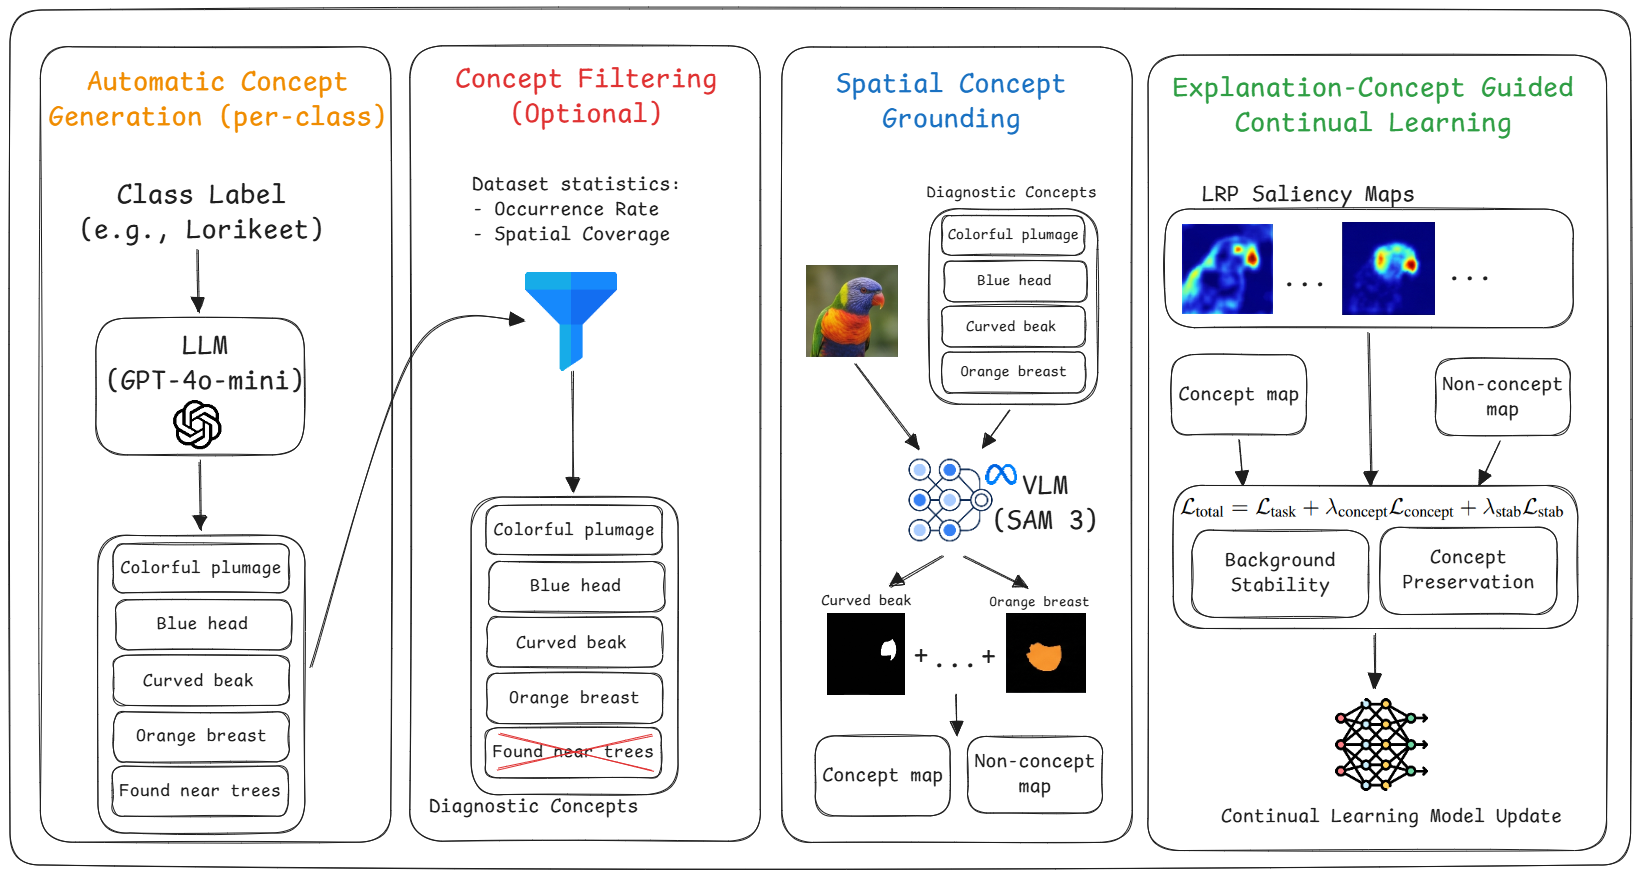
Figure 2 — C^3^L 전체 프레임워크
C^3^L의 training objective는 cross-entropy loss Ltask와 두 가지 regularization terms Lconcept 및 Lstab으로 구성됩니다. Lconcept (Concept Overlap Preservation)는 concept regions 내에 높은 relevance를 강제하여 semantic features에 대한 attention을 anchor합니다. 이 과정에서 approximate LRP relevance conservation에 의해 crowding-out effect가 유발되어, explicit penalization 없이도 spurious background attributions이 암묵적으로 억제됩니다. Lstab (Background Stability)는 background regions의 spatial structure를 보존하여, crowding-out effect로 freed relevance mass가 새로운 task-specific artifacts로 drift하는 것을 방지합니다.
C^3^L은 다섯 가지 benchmarks와 20개 이상의 baselines에 대한 extensive evaluation을 통해 state-of-the-art performance를 달성했습니다. ResNet-18 아키텍처에서 CUB 데이터셋에 대해 C^3^L은 79.73%의 Average Accuracy (ACC)와 5.32%의 Average Forgetting (F)를 기록하여, 최상위 explanation-aware baseline인 RRR-LRP의 73.25% ACC 및 8.42% F 대비 우수한 성능을 보였습니다. ViT-B 아키텍처에서는 C^3^L이 ImageNet-R에서 82.74% ACC 및 1.89% F를 달성하며, 최상위 replay-based baseline인 MOS-R의 80.92% ACC 및 2.43% F를 능가했습니다. 또한, C^3^L은 spurious correlation mitigation에서 FITZ 데이터셋 60.47% ACC 및 I-100C 데이터셋 64.19% ACC로 specialized debiasing methods보다 높은 accuracy를 보였으며, semantic localization에서도 mIoU, pixAcc, mAP 등 모든 지표에서 가장 높은 점수를 기록했습니다. 특히, Out-of-Distribution (OOD) robustness 평가에서 C^3^L은 ImageNet-A 및 ObjectNet 데이터셋에서 fine-tuning 후 RRR 대비 accuracy가 ImageNet-A에서는 20.15% (RRR 7.92%), ObjectNet에서는 36.93% (RRR 21.56%)로 significant하게 향상되었습니다. Ablation studies 결과, Lconcept와 Lstab 두 regularization terms 모두 performance에 critical한 기여를 하며, 특히 C^3^L은 replay buffer size 감소(예: 200 samples)에도 robust한 성능을 유지하여 data efficiency를 입증했습니다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 continual learning에서 catastrophic forgetting과 explanation drift 문제를 해결하기 위해 semantic concept steering 기반의 C^3^L 프레임워크를 제안합니다. C^3^L은 model state와 독립적인 semantic concepts에 model representations를 anchor함으로써, 기존 pixel-level explanation-aware CL 방법의 self-referential drift loop를 성공적으로 break합니다. 이 framework는 transferable features 학습을 촉진하고 spurious correlations 및 explanation drifts에 대한 resistance를 강화하며 Out-of-Distribution robustness를 향상시킵니다.
automated framework는 manual annotation 없이 concept-based supervision을 가능하게 하여 continual learning의 확장성을 높입니다. 이 연구는 medical diagnosis systems나 autonomous vehicles와 같은 dynamic하고 safety-critical domains에 adaptive AI systems를 deploy할 때 모델이 reliable하고 interpretable한 reasoning patterns을 유지하도록 돕는 중요한 implications를 가집니다. 이는 explainable AI에 대한 domain expertise가 없는 practitioners에게도 interpretable continual learning을 더 accessible하게 만듭니다.
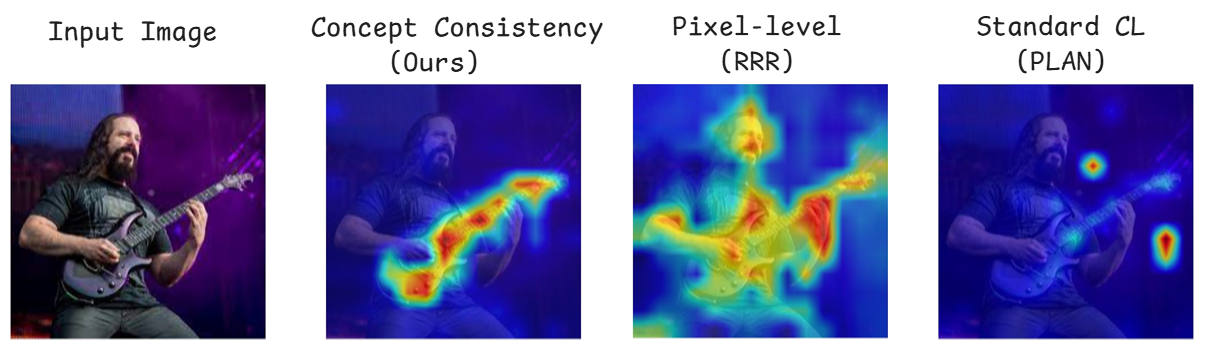
Figure 1 — Explanation Drift 완화 개념
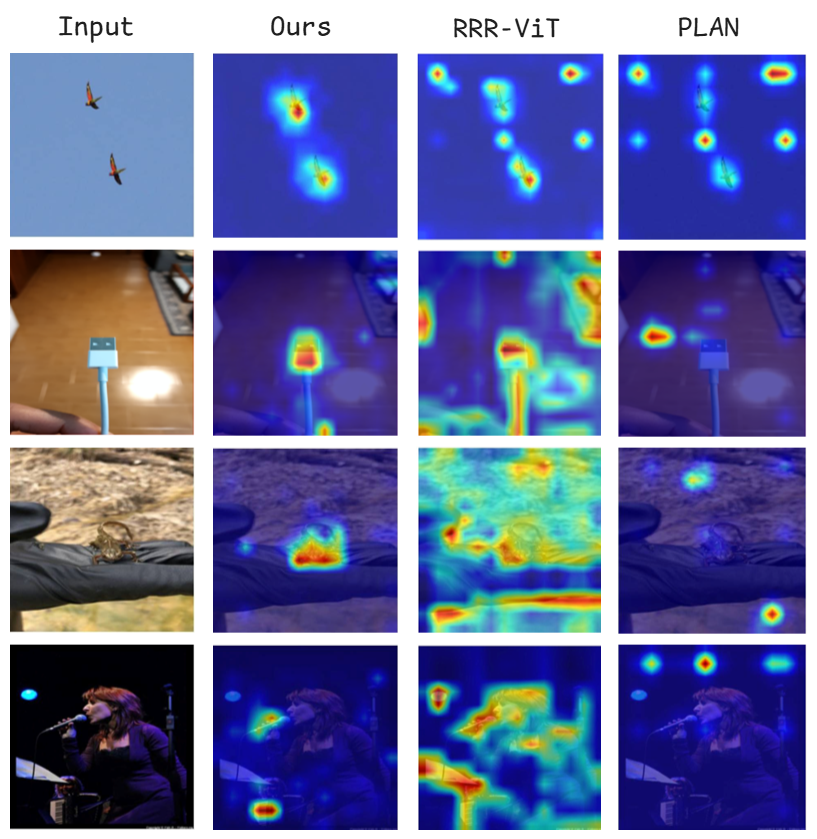
Figure 3 — 설명 맵 정성적 비교
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
Review 의 다른글
- 이전글 [논문리뷰] S3AC: Stabilized, Selective, and Scalable Actor-Critic for LLM Reasoning
- 현재글 : [논문리뷰] Semantic Concept Steering Breaks the Explanation Drift Loop in Continual Learning
- 다음글 [논문리뷰] Skill^{infty}: Recursive Self-Improvement for Agent Skill Optimization
댓글