[논문리뷰] Zooming without Zooming v2: From Seeing Details to Connecting Evidence for Generalizable Multimodal Perception
링크: 논문 PDF로 바로 열기
메타데이터
저자: Lai Wei, Yatai Li, Liangbo He, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- EvidenceConnect: 다중 이미지 영역을 연결하는 추론 문제를 생성하여 모델의 시각적 증거 연결 능력을 향상시키는 자동화된 데이터 합성 프레임워크입니다.
- Connecting Evidence: 모델이 시각적 사실을 식별하고, 적절한 엔티티와 결합하며, 관계를 재구성하여 최종 답변을 도출하는 핵심적인 원자적(atomic) 능력을 의미합니다.
- RLVR (Reinforcement Learning with Verifiable Rewards): 정형화된 정답(Multiple-choice 등)을 기반으로 모델을 학습시켜, 정답률과 추론 정확도를 최적화하는 학습 기법입니다.
- Privileged Evidence Layout: 데이터 합성 단계에서만 사용되는 고해상도 영역별 크롭(crop) 구성으로, 모델이 세부 정보를 명확하게 인지하고 추론할 수 있도록 돕는 도구입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 현대 VLM들이 공간 지각(Spatial perception)과 다중 모달 장기 문맥 이해(Multimodal long-context understanding)에서 겪는 한계를 해결하는 것을 목표로 합니다. 기존 연구들은 방대한 양의 데이터를 필요로 하지만, 정교한 시각적 증거를 연결하고 추론하는 고품질 데이터는 여전히 부족하며 생성이 어렵습니다. 특히 로봇 공학이나 에이전트 서비스와 같은 실무 분야에서는 파편화된 시각적 정보 간의 관계를 정확히 파악해야 하는 요구가 높지만, 이를 위한 확장 가능한 정량적 데이터 확보가 어렵다는 문제가 있습니다 [Figure 1]. 저자들은 이러한 과제들이 공통적으로 시각적 증거를 연결하는 능력을 요구한다는 점에 주목하고, 이를 효과적으로 학습시킬 수 있는 대안적 방법을 제시합니다.
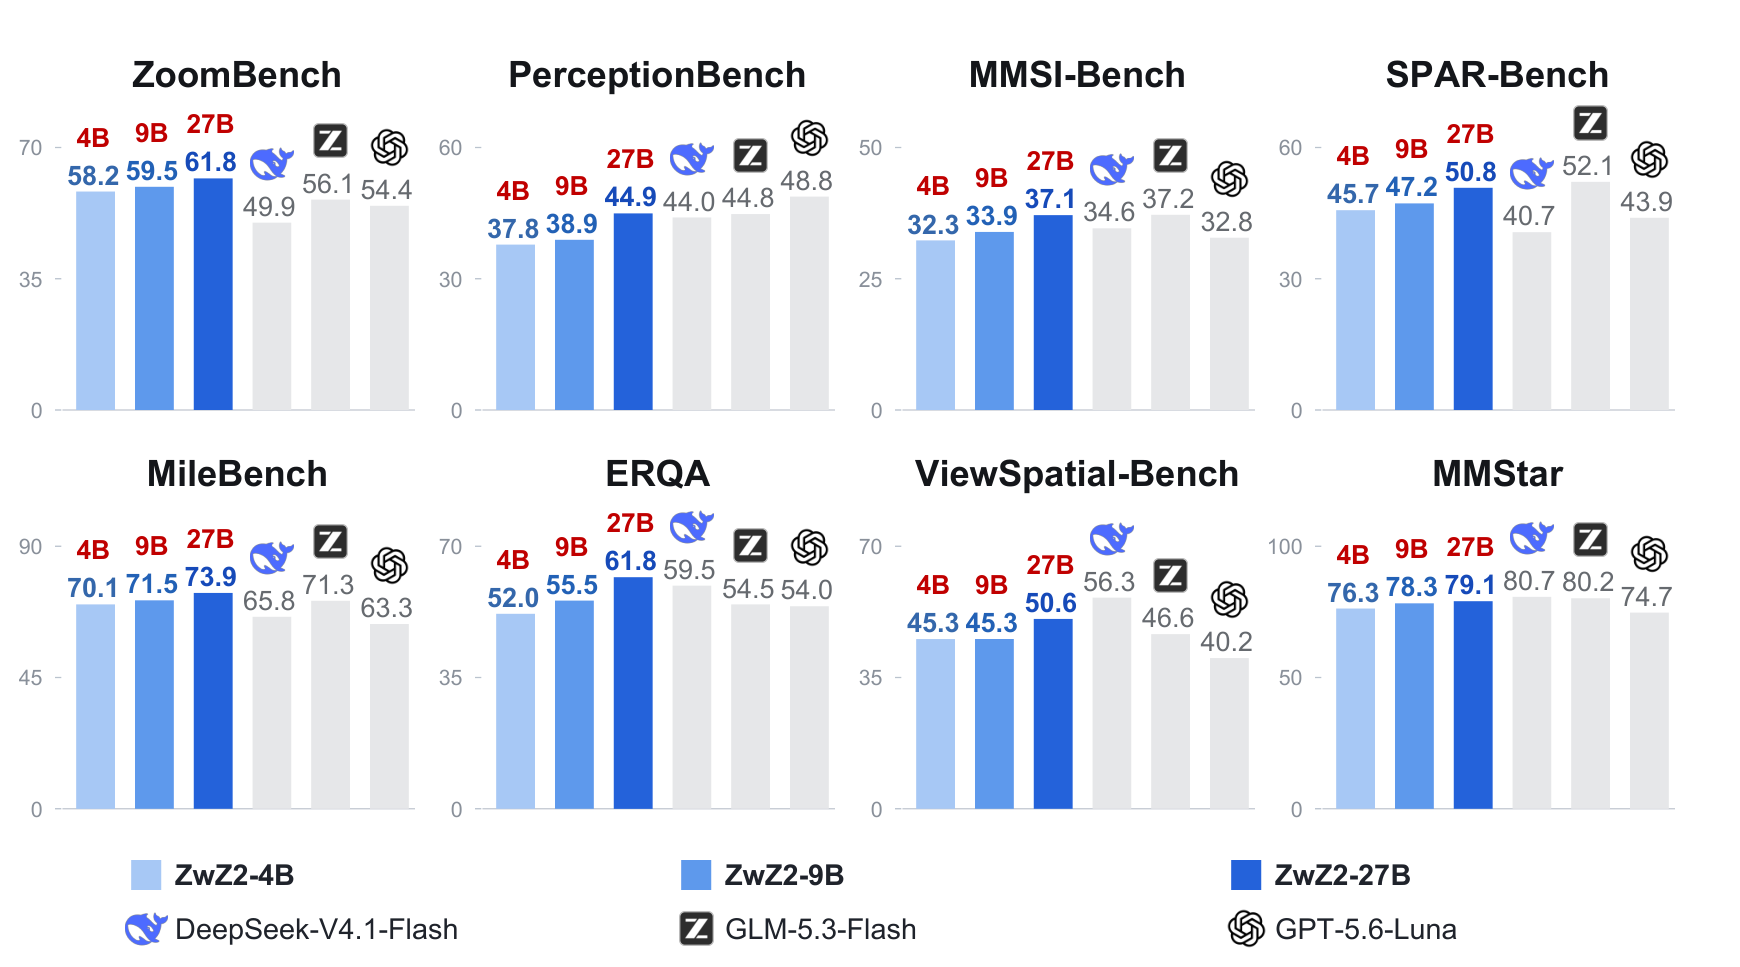
Figure 1 — ZwZ2와 타 모델 성능 비교
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 증거 연결 능력 향상을 위해 단일 이미지 내의 관련 영역을 선택하고 합성 문제를 생성하는 EvidenceConnect 프레임워크를 제안합니다 [Figure 2]. 이 방법론은 세 가지 핵심 단계로 구성됩니다: (1) 다중 영역 증거 discovery 및 질문 합성, (2) 교차 모델 답변 고정 및 영역 제거 테스트(Drop-one testing)를 통한 데이터 검증, (3) RLVR을 이용한 모델 학습입니다. 특히 Privileged evidence layout을 활용하여 세부 내용을 시각화하고, 다수의 VLM이 독립적으로 동의하는 경우에만 정답을 확정함으로써 높은 신뢰성을 보장합니다. 실험 결과, ZwZ2 모델은 기존 모델 대비 Fine-grained 및 공간 지각 능력을 크게 향상시켰습니다. 정량적으로 ZwZ2-4B 모델은 ViewSpatial-Bench에서 37.43에서 45.26(+7.83)으로, MileBench에서 60.08에서 70.08(+10.00)으로 우수한 성능 개선을 입증하였습니다. 또한 ZwZ2-27B 모델은 25개 벤치마크 평균 성능을 55.52에서 60.51로 끌어올리며 다양한 태스크에서 일반화 성능을 확인했습니다.
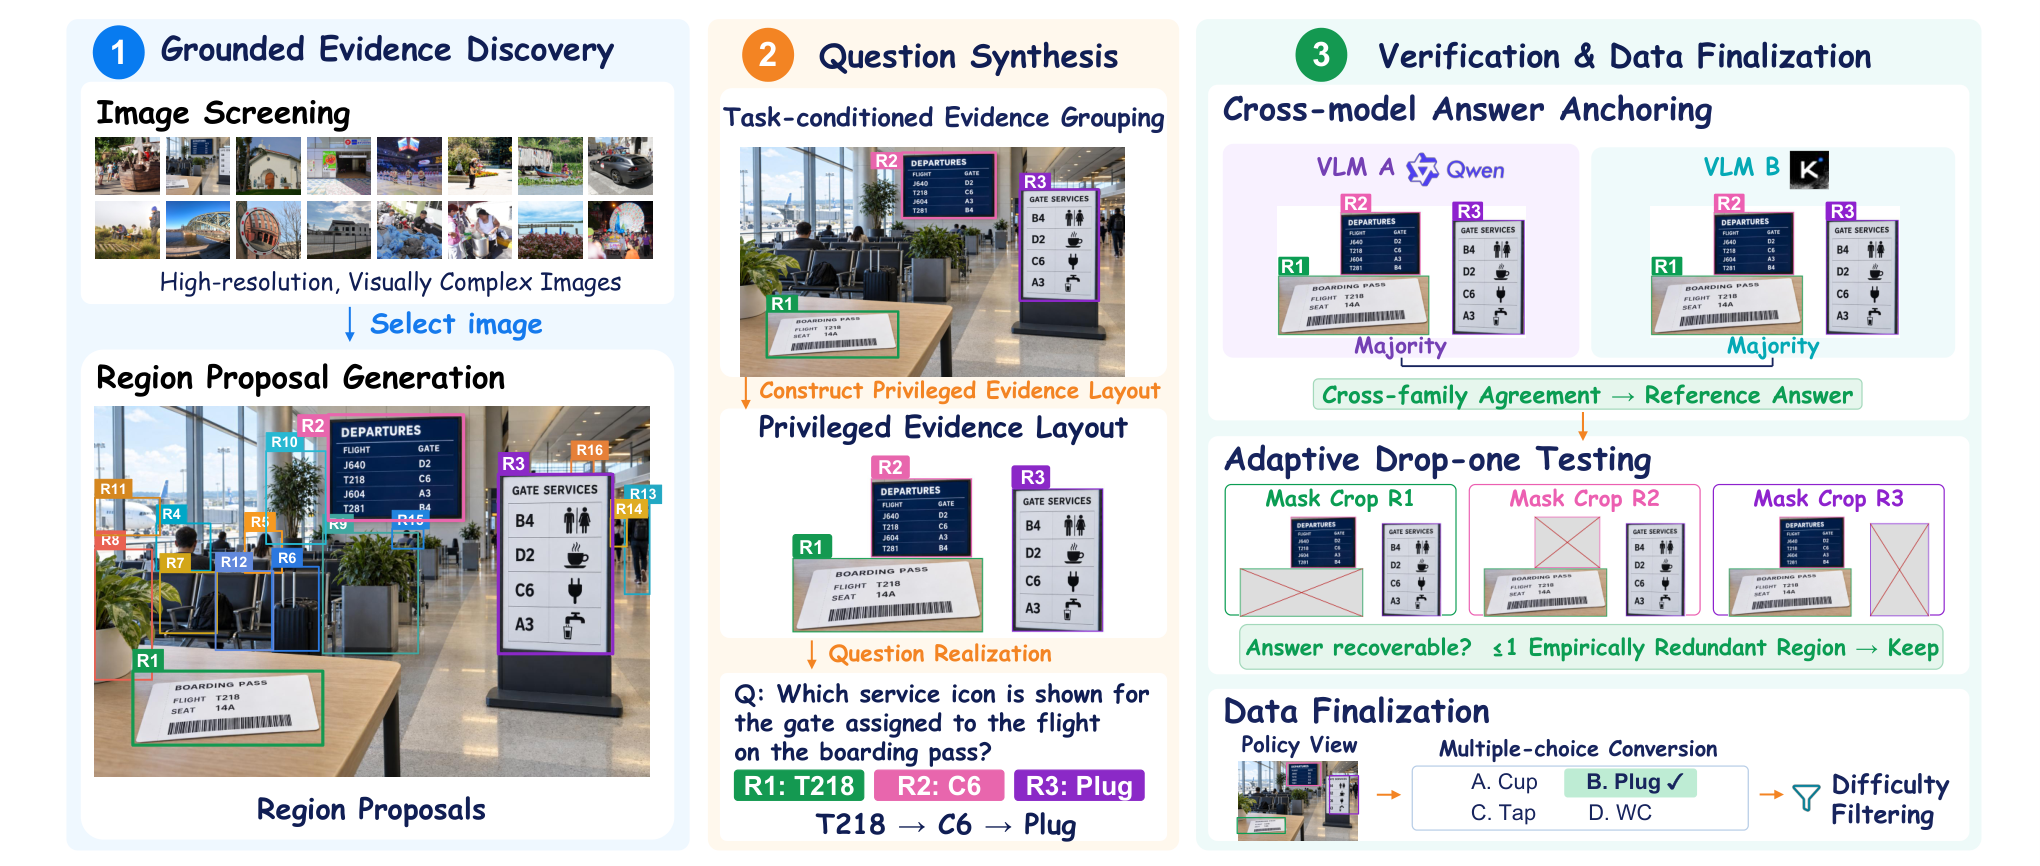
Figure 2 — 데이터 합성 파이프라인 개요
4. Conclusion & Impact (결론 및 시사점)
본 논문은 시각적 증거를 연결하는 능력이 다중 모달 지능의 핵심이며, 이를 강화함으로써 공간 지각 및 에이전트와 같은 하위 태스크까지 전이 학습 효과를 얻을 수 있음을 입증했습니다. EvidenceConnect 프레임워크는 인간의 수동 개입 없이도 정교하고 신뢰성 높은 데이터를 생성할 수 있는 확장 가능한 경로를 제공합니다. 이 연구는 VLM의 데이터 효율적인 학습 전략을 제시하며, 향후 embodied AI나 복잡한 시각적 추론을 요구하는 다양한 응용 분야의 성능 발전에 중요한 토대가 될 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] LongZero: Enhancing Long-Context Reasoning in LLMs from Zero Data
- [논문리뷰] SpatialASM: Internalizing Active Mentalization for Spatial Reasoning
- [논문리뷰] OmniVChat: Synthesizing, Benchmarking, and Training for Native Audio-Visual Dialogue
- [논문리뷰] SpatialBlock: Enhancing Spatial Intelligence in LVLMs via Synthetic Block-Stacking Problem
- [논문리뷰] MentalThink: Shaping Thoughts in Mental SVG World
Review 의 다른글
- 이전글 [논문리뷰] Your Policy Is Secretly a Harness: The Decision Geometry of Agent Interfaces
- 현재글 : [논문리뷰] Zooming without Zooming v2: From Seeing Details to Connecting Evidence for Generalizable Multimodal Perception
- 다음글 [논문리뷰] h1: A Taste of the Bitter Lesson in Automated Theorem Proving
댓글