[논문리뷰] Your Policy Is Secretly a Harness: The Decision Geometry of Agent Interfaces
링크: 논문 PDF로 바로 열기
메타데이터
저자: Jian Mu, Ruibo Shen, Yao Shu
1. Key Terms & Definitions (핵심 용어 및 정의)
- Harness: LLM agent를 배포하고 Task를 수행하기 위해 prompt, tool, control logic을 결합한 인터페이스 프레임워크를 지칭함.
- Semantic Action: Agent가 수행하는 작업(예: 클릭, 쿼리 등)과 그 매개변수를 의미하며, Harness는 이를 실행 가능하도록 변환함.
- Ceiling: 특정 Harness 환경 하에서 정책(Policy)이 도달할 수 있는 최대 가능한 Return을 의미함.
- Mismatch: 최적 정책(Optimal Policy) 대비 현재 정책이 결정 내리는 과정에서 손실되는 Return으로, 정책의 suboptimal함을 측정하는 지표.
- Readout: 학습된 모델의 가중치가 특정 인터페이스를 통해 표현하는 Action preference(점수)를 지칭함.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 LLM agent의 성능이 Harness 디자인에 크게 의존함에도 불구하고, 모델 학습 시 사용된 Harness와 실제 배포 시의 Harness가 다를 때 발생하는 성능 저하 문제를 해결하고자 한다. 기존 연구들은 고정된 모델을 다양한 Harness에서 평가함으로써 최적의 환경을 선택하려 하지만, 모델의 성능은 단순히 환경뿐만 아니라 학습된 가중치와 인터페이스 간의 상호작용에 의해 결정된다. 저자들은 학습된 정책(Policy)이 학습 Harness의 정보를 내재하고 있어, Harness가 변경될 때 정책의 Action 선택 편향(Bias)과 최적 목표가 어긋나면서 성능이 급락하는 현상을 지적한다 [Figure 2]. 따라서 단순한 비교 평가 방식의 한계를 극복하고, 정책과 Harness 간의 기하학적 관계를 규명하는 것이 본 연구의 목적이다.
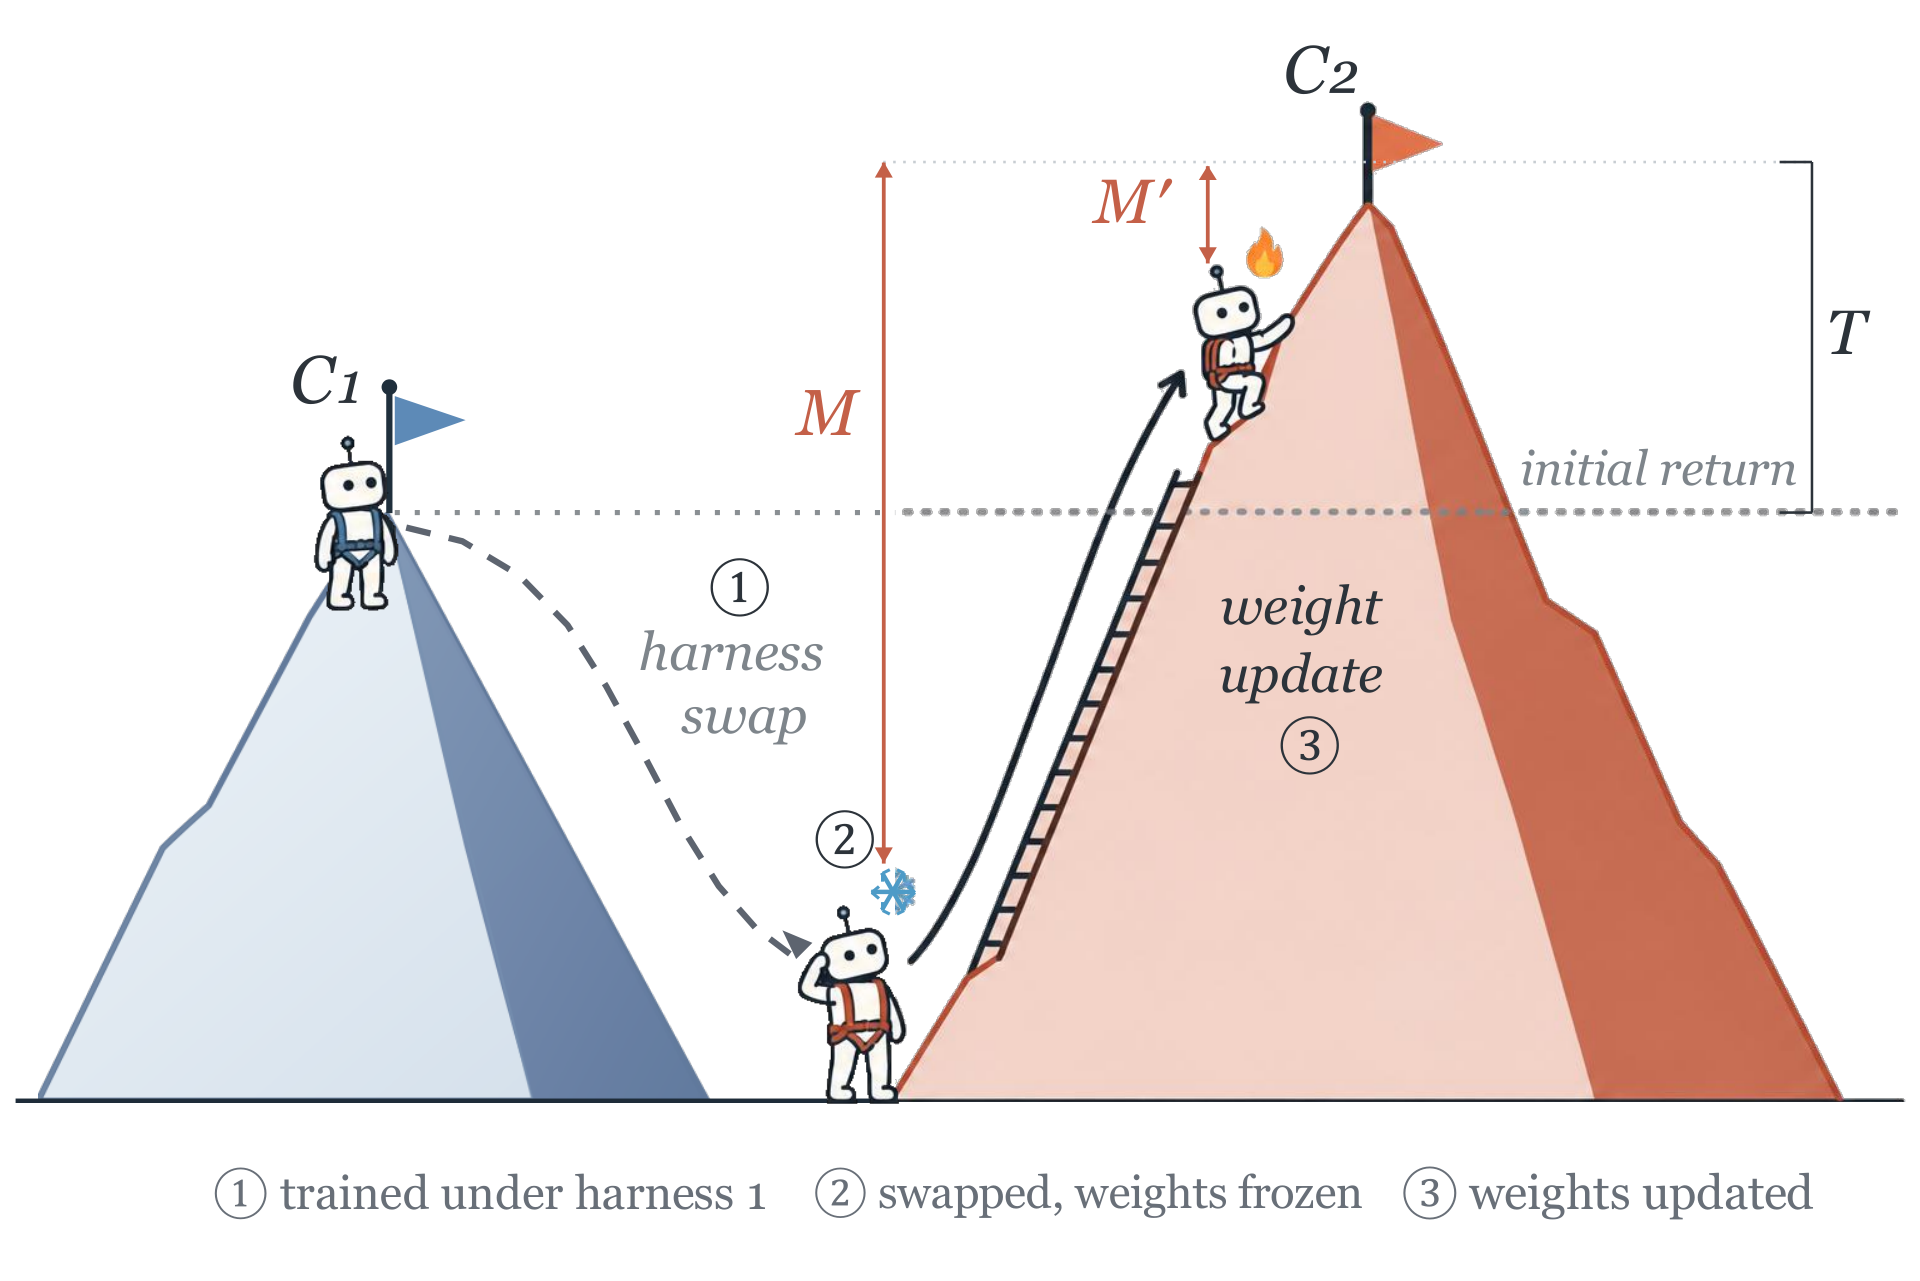
Figure 2 — Harness 수정과 정책 수정의 기하학적 분석
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 KL-regularized control 프레임워크를 기반으로, 최적 정책의 Log-odds가 Harness가 부여하는 Action 선호도를 반영함을 수학적으로 증명한다. 제안하는 핵심 수식에 따르면, 배포된 모델의 Return은 해당 Harness의 Ceiling에서 정책의 Mismatch를 뺀 값으로 정의된다 [Figure 2]. 실험 결과, MiniWoB++ 환경에서 Harness의 필드 순서만 변경하더라도 최적의 Action 결정은 그대로임에도 불구하고, 모델의 Action 선택이 변하여 성공률이 85.0%에서 19.2%까지 하락함을 확인하였다 [Table 1]. 반면, 학습 후 추가적인 Adaptation(추가 학습)을 거치면, 고정된 모델 평가에서는 거부되었던 Harness가 최종적으로는 기존보다 더 높은 성능을 달성할 수 있음을 입증하였다. 이는 Ceiling과 Mismatch를 측정함으로써 특정 Harness Revision이 장기적으로 성능 향상에 도움이 될지 사전에 예측 가능하다는 것을 의미한다 [Figure 1].
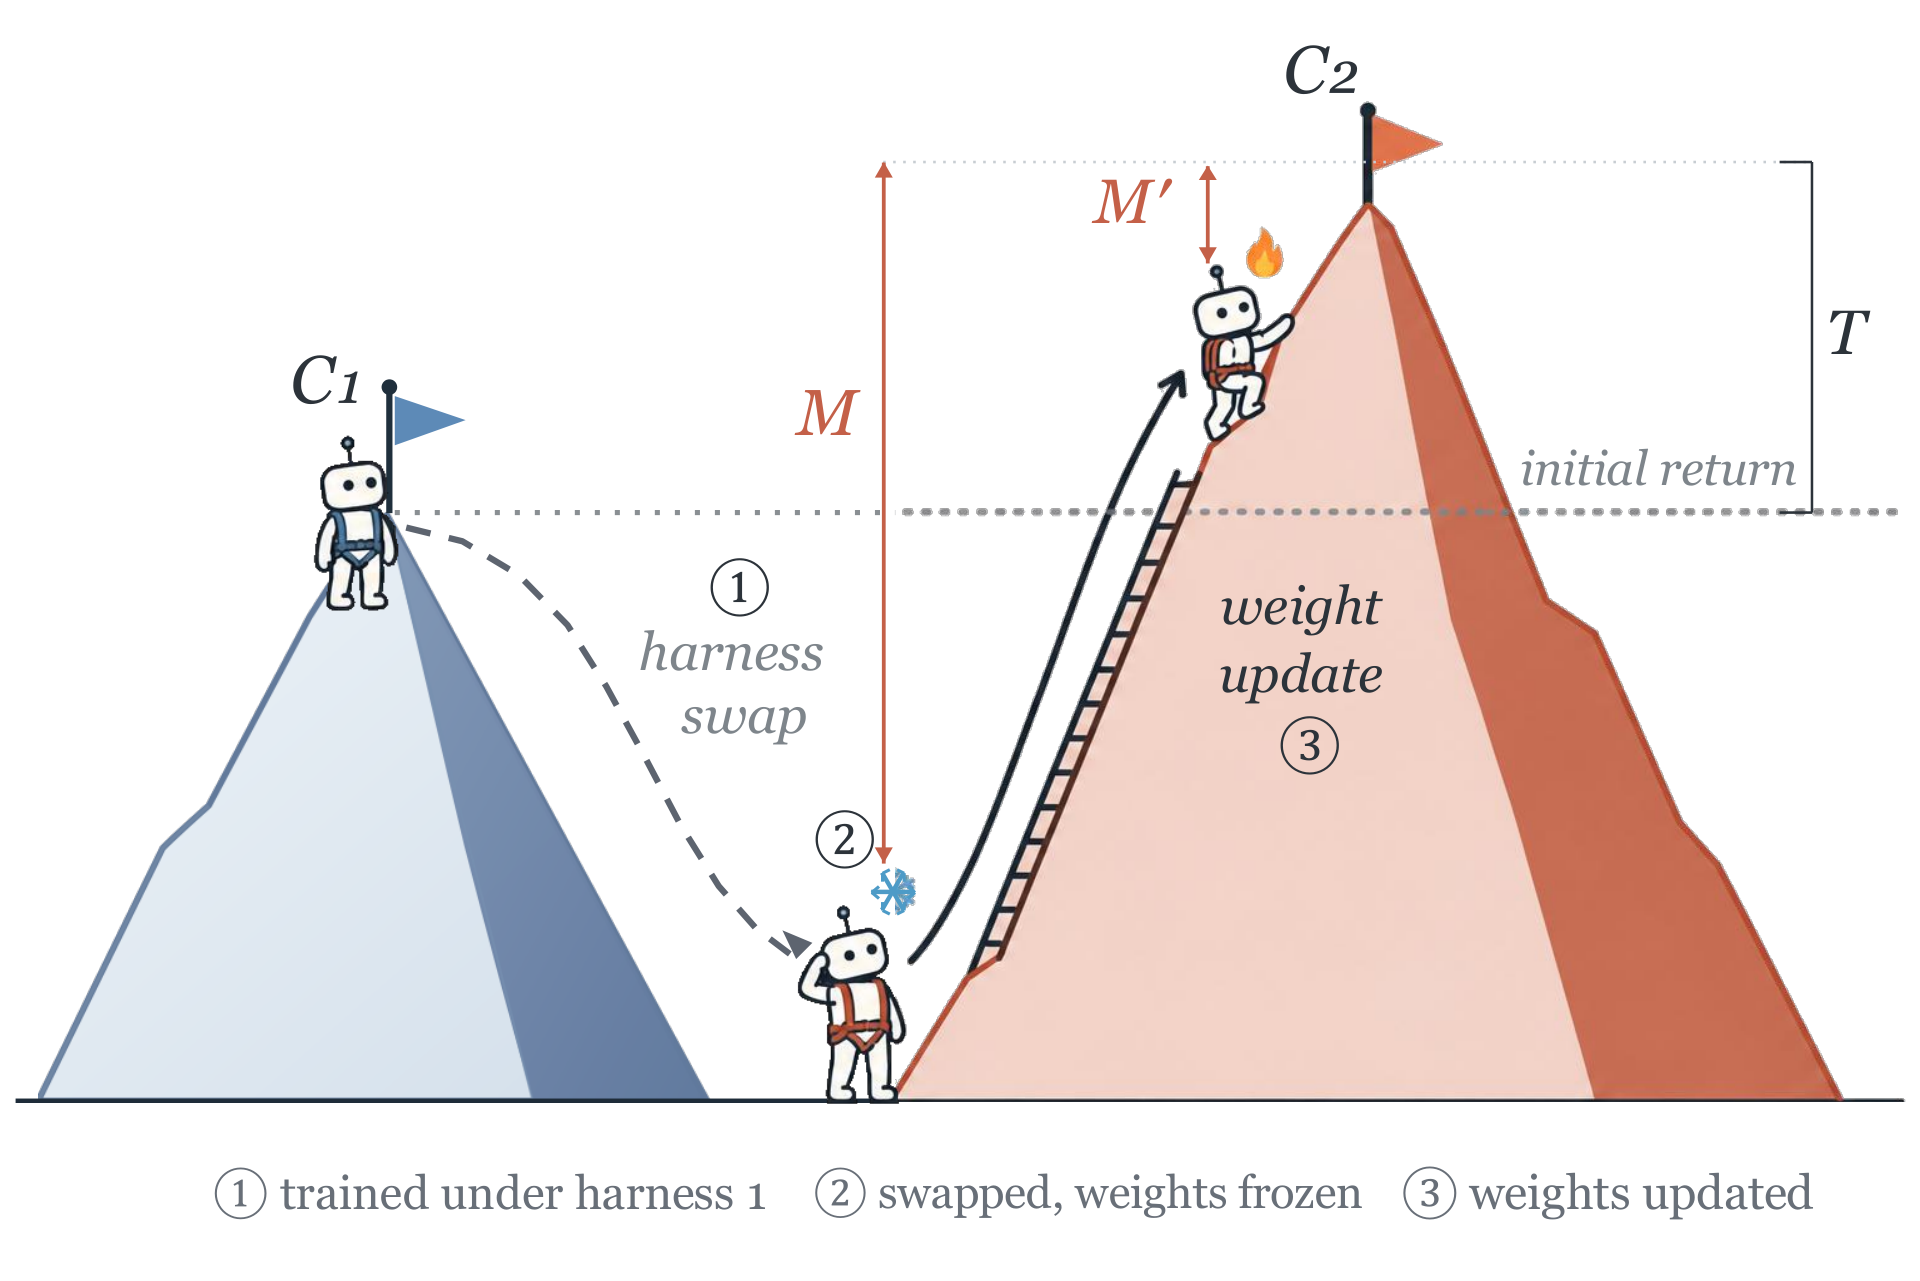
Figure 1 — 적응 학습을 통한 성능 회복 과정
4. Conclusion & Impact (결론 및 시사점)
본 논문은 정책이 단순히 특정 Task를 수행하는 것이 아니라 학습된 Harness의 설정을 내재화하고 있다는 사실을 "Policy is secretly a harness"라는 개념으로 명확히 규명하였다. 연구 결과는 Harness 디자인 및 모델 평가 시, 단순히 고정된 모델의 성능을 비교하는 방식이 아닌, 해당 인터페이스가 제공하는 Ceiling과 모델의 Mismatch를 동시에 고려해야 함을 시사한다. 이 접근법은 복잡한 Agent 시스템 구축 시 인터페이스 변경에 따른 모델의 성능 저하를 진단하고, 효율적인 적응형 학습 전략을 수립하는 데 핵심적인 학술적·실무적 토대를 제공한다.
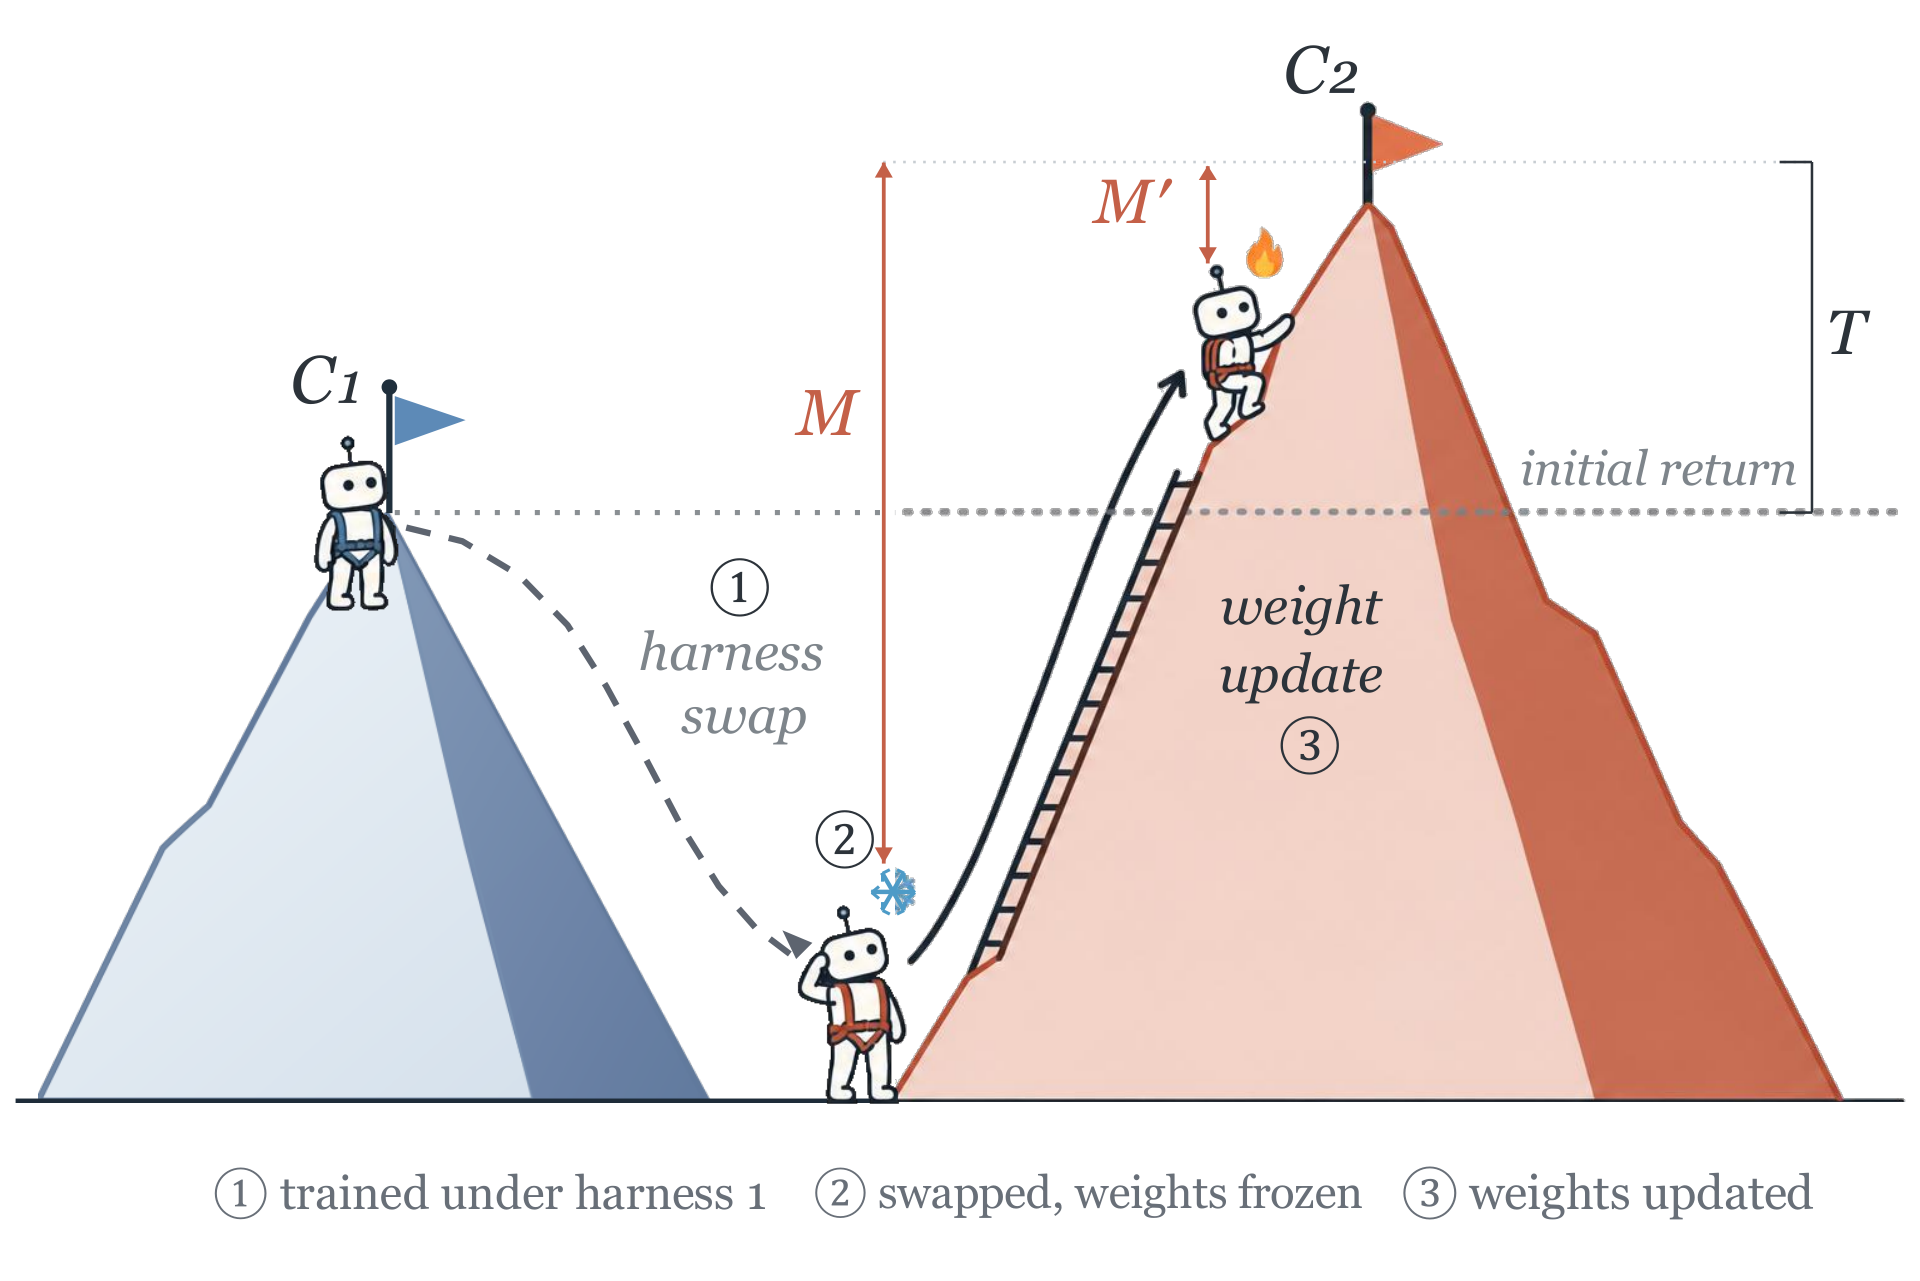
Figure 3 — 학습 Harness에 대한 편향 특성 실험
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Trial by Trace: Benchmarking AI Agent Harnesses for Reliability and Failure Attribution
- [논문리뷰] From VLM Planners to Robotic Agents: Self-Evolving Harnesses for History-Dependent Manipulation
- [논문리뷰] HarnessPro: Recursive Harness Self-Improvement with Pareto Optimization for Performance-Cost Trade-offs
- [논문리뷰] WebFovea: When the Model Is Right but the Click Is Wrong -- Reliable Round Trips for Vision-Based Web Agents on Live Websites
- [논문리뷰] Self-Evolving Coding Agents: From Digital Programs to Physical-World Intelligence
Review 의 다른글
- 이전글 [논문리뷰] What Outcome RL Buys: Finishing, Reliability, Rarely Reach
- 현재글 : [논문리뷰] Your Policy Is Secretly a Harness: The Decision Geometry of Agent Interfaces
- 다음글 [논문리뷰] Zooming without Zooming v2: From Seeing Details to Connecting Evidence for Generalizable Multimodal Perception
댓글