[논문리뷰] From VLM Planners to Robotic Agents: Self-Evolving Harnesses for History-Dependent Manipulation
링크: 논문 PDF로 바로 열기
저자: Tingwen Du, Haoyu Guo, et al.
1. Key Terms & Definitions
- Vision-Language-Action (VLA) models: 시각적 이해, 언어적 조건화, 그리고 행동 생성을 통합하여 로봇 조작 작업을 수행하는 모델.
- SERA (Self-Evolving Robotic Agent): 고수준 VLM을 편집 가능한 Harness를 통해 로봇 에이전트로 조직화하여, 태스크 Context를 유지하고 실행 경험을 통해 Planning을 개선하는 방법론.
- Harness: VLM 기반 Planning을 위한 외부 관리 프레임워크로, 태스크 Context 관리, Planning Guidance, Assessment Criteria, Control Rules 등을 담당하며 Self-evolution의 대상이 되는 핵심 구성 요소.
- RoboMME: History-Dependent 로봇 조작 태스크를 위한 벤치마크로, Counting, Permanence, Reference, Imitation 등 네 가지 스위트(suite)로 구성됨.
- Self-evolution: 환경 Rollout 피드백을 사용하여 Harness의 Planning Guidance, Assessment Criteria, Control Rules에 대한 수정(revision)을 제안하고 평가하며, 최적의 Harness 구성을 자율적으로 선택하는 과정.
2. Motivation & Problem Statement
본 논문은 Long-horizon 로봇 조작 태스크에서 비(Non)-Markovian 의존성, 부분적 관측 가능성(Partial Observability), 그리고 누적되는 실행 오류로 인해 발생하는 문제를 해결하고자 합니다. 기존 VLA models는 일반적인 조작에서 강력한 성능을 보이지만, 과거 상호작용의 결과나 현재 관측으로 드러나지 않는 정보를 기억하고 활용해야 하는 History-Dependent 태스크에서는 한계를 가집니다. 기존 Memory-augmented policies는 Temporal Representation이나 Memory Retrieval을 통해 이력을 통합하지만, 태스크 Context를 명시적으로 유지하고 실행 결과에 따라 Planning 프로세스를 재사용 가능한 형태로 개선하는 메커니즘이 부족했습니다. 따라서 현재 관측을 넘어 태스크 관련 정보를 보존하고, 실행 결과를 추적하여 의사결정을 지원하며, 과거 경험을 통해 미래 Planning을 개선할 수 있는 새로운 접근 방식이 필요합니다.
3. Method & Key Results
저자들은 고수준 VLM을 로봇 에이전트로 조직하는 SERA (Self-Evolving Robotic Agent)를 제안하며, 이는 고정된 VLA executor 위에 편집 가능한 Harness를 배치하는 방식으로 작동합니다. SERA의 Harness는 실행 중에 지속적인 태스크 Context 관리를 담당하며, 관측 및 실행 피드백으로부터 태스크 진행 상황 및 결과를 추출, 보존, 업데이트하여 VLM의 Planning을 안내합니다. Harness가 태스크의 모든 요구사항을 예측하지 못할 수 있다는 점을 고려하여, SERA는 Execution-driven Self-evolution 절차를 통해 Harness의 Planning Guidance, Assessment Criteria, Control Rules의 한계를 자율적으로 진단하고 수정합니다. 이 Self-evolution은 개발 단계의 환경 Rollout을 활용하여 수정안을 제안하고 평가하며, 추가적인 SFT(Supervised Fine-Tuning) 데이터셋 구축 없이 Harness를 개선합니다 [Figure 2].
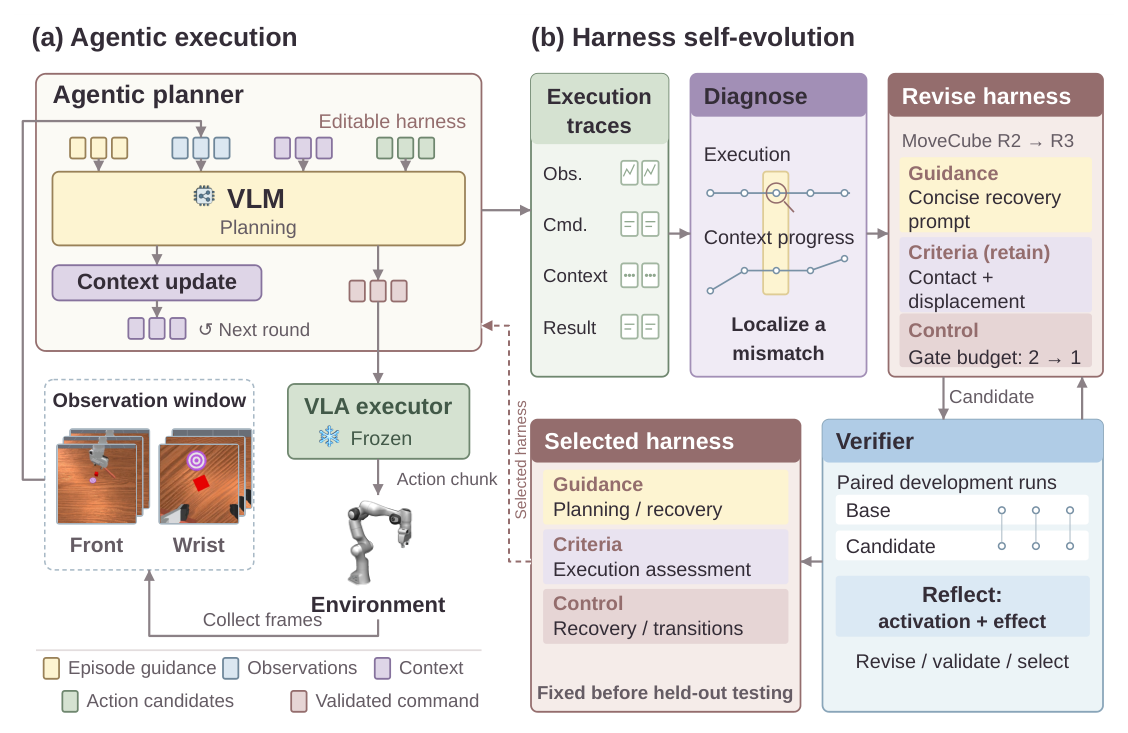
Figure 2 — SERA의 Agentic Execution 과정과 Harness Self-Evolution 메커니즘의 세부 아키텍처 및 데이터 흐름을 보여주는 핵심 다이어그램.
SERA는 RoboMME 벤치마크에서 History-Dependent 로봇 조작 태스크에 대해 평가되었으며, 51.38%의 전체 Success Rate (SR)를 달성했습니다. 이는 Self-evolution이 없는 초기 구성의 44.38% 대비 7.00%p 개선된 결과입니다 [Table 1, Figure 3(a)]. 특히 SERA는 Reference 및 Permanence 스위트에서 가장 높은 점수를 기록하여, 이전 관측을 활용해야 하는 태스크에서 History-Dependent Manipulation을 위한 Agentic Planning의 잠재력을 입증했습니다. 예를 들어, PatternLock 태스크에서 Self-evolution은 시각적 방향과 Executor Command 간의 잘못된 Mapping 및 누락된 Action Candidate 문제를 성공적으로 진단하고 수정하여, Revised Agent가 시퀀스를 완료할 수 있도록 했습니다 [Figure 3(c)]. 이 결과는 실행 기반 Harness 수정이 Planning Guidance 및 Control Rules의 결함을 효과적으로 보완하고 전반적인 태스크 성능을 향상시킴을 보여줍니다.
4. Conclusion & Impact
본 논문은 편집 가능한 Harness를 통해 고수준 VLM을 로봇 에이전트로 조직하는 SERA를 제안했습니다. SERA의 Harness는 실행 중 태스크 Context를 효과적으로 관리하며, Self-evolution 프로세스는 개발 단계의 실행 경험을 활용하여 Planning Guidance, Assessment Criteria, Control Rules을 자율적으로 수정합니다. RoboMME 벤치마크에서 SERA는 51.38%의 전체 Success Rate를 달성했으며, Self-evolution을 통해 7.00%p의 상당한 성능 향상을 보였습니다. 이 연구는 High-level Planner의 조직화 및 적응이 VLA 기반 로봇 제어에서 Long Execution Horizon에 걸친 성능 향상에 기여할 수 있음을 시사합니다. 이는 History-Dependent 로봇 조작 분야에서 Agentic Planning의 가능성을 확장하고, 미래 연구에서는 Planning Latency를 줄이면서 의사결정 품질을 유지하는 더 효율적인 Context Processing 및 Reasoning 전략을 탐구할 필요성을 제기합니다.
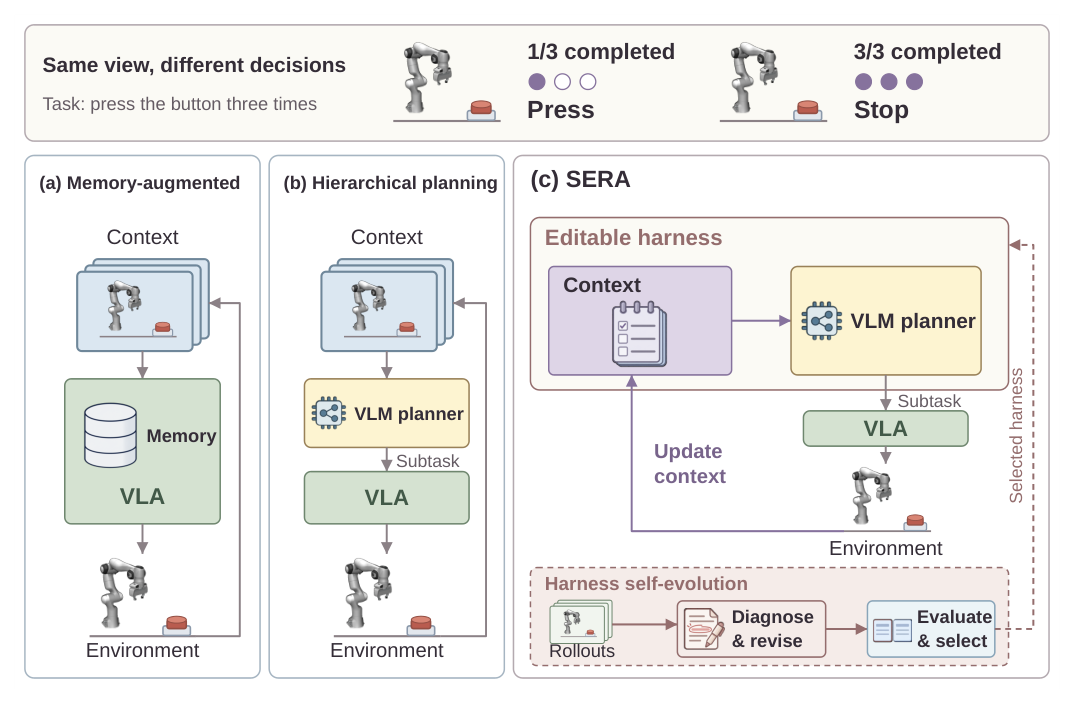
Figure 1 — History-Dependent Manipulation을 위한 기존 접근 방식(Memory-augmented, Hierarchical planning)과 제안하는 SERA의 개념적 Framework를 시각적으로 비교 설명하는 핵심 다이어그램.
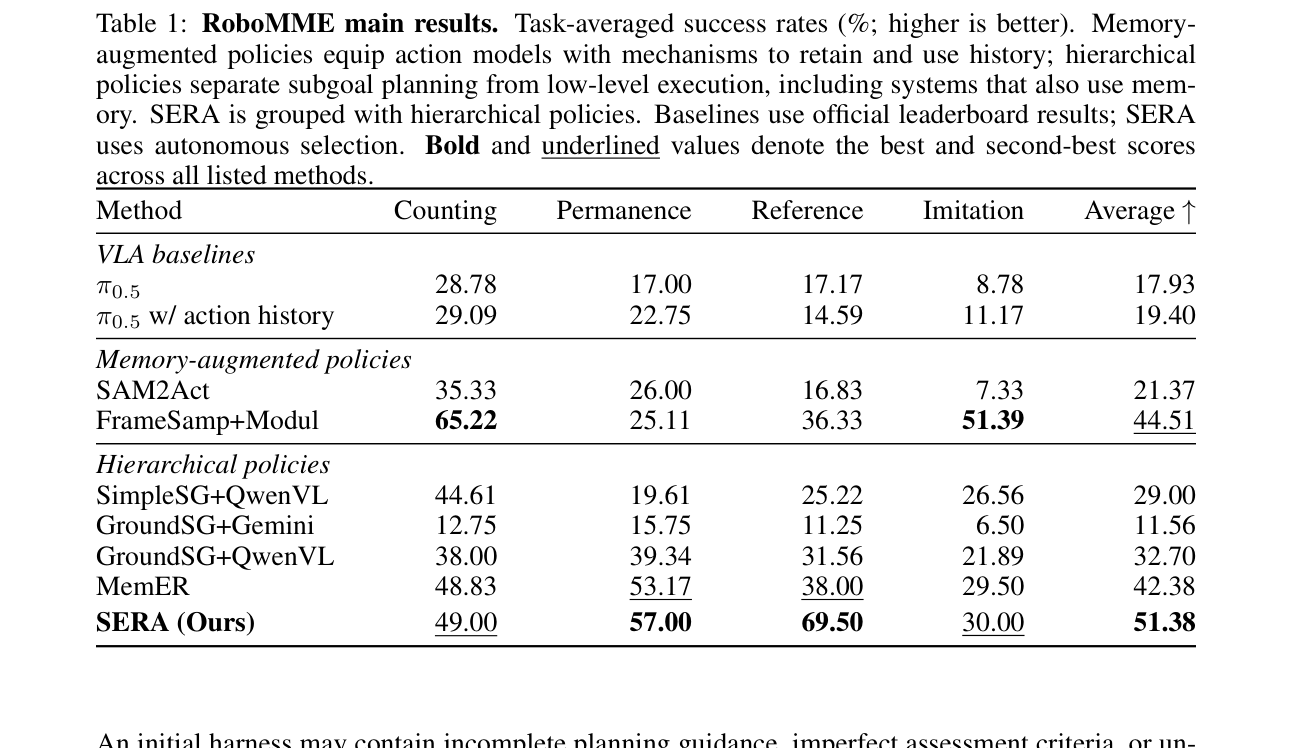
Table 1 — RoboMME 벤치마크에서 SERA와 다양한 Baseline 방법론들의 태스크별 및 평균 Success Rate를 비교하는 핵심 정량적 결과 테이블.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] HarnessPro: Recursive Harness Self-Improvement with Pareto Optimization for Performance-Cost Trade-offs
- [논문리뷰] Pack Light, CarryOn: Building Object-Oriented Context for Long-Horizon Agents
- [논문리뷰] Mosaic: Multi-Session Agentic Reinforcement Learning
- [논문리뷰] MJev-Spatial: System One Spatial Intelligence via Native Attention Matching
- [논문리뷰] WebFovea: When the Model Is Right but the Click Is Wrong -- Reliable Round Trips for Vision-Based Web Agents on Live Websites
Review 의 다른글
- 이전글 [논문리뷰] From RL Papers to Framework Code: Inclusion and Review in Seven Open-Source Training Frameworks
- 현재글 : [논문리뷰] From VLM Planners to Robotic Agents: Self-Evolving Harnesses for History-Dependent Manipulation
- 다음글 [논문리뷰] Harness Scaling for Generalizable Agentic Reinforcement Learning
댓글