[논문리뷰] Efficient Streaming Audio-Visual Target Speaker Extraction for Real-World Acoustic Scenes
링크: 논문 PDF로 바로 열기
Part 1: 요약 본문
메타데이터
저자: Wendi Sang, Kai Li, Yifan Li, Jianqiang Huang, Xiaolin Hu
1. Key Terms & Definitions (핵심 용어 및 정의)
- AVTSE (Audio-Visual Target Speaker Extraction): 타겟 화자의 시각 정보(주로 입술 움직임)를 활용하여 다중 화자 혼합 음성에서 타겟 화자의 음성만을 분리하는 기술.
- Causal System: 미래의 프레임을 참조하지 않고 현재와 과거의 정보만을 사용하여 실시간 처리가 가능한 시스템.
- RealSSA: 본 논문에서 제안한 새로운 AVTSE 벤치마크로, 근거리/원거리 간섭, 잔향, 급격한 환경 소음을 포함한 시뮬레이션 데이터셋(RealSSA-Sim)과 실제 녹음된 평가 데이터셋(RealSSA-Real)으로 구성됨.
- Falcon: 제안하는 효율적인 causal AVTSE 모델로, single-pass encoder-decoder 구조를 통해 Multi-scale 시간-주파수 분리를 수행함.
- Encoder-Space Speaker Contrastive Loss: 인코더 공간에서 타겟 음성과 근거리 간섭 화자의 임베딩을 분리하여 간섭 제거 성능을 향상시키는 학습 기법.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 실제 환경에서의 성능과 컴퓨팅 효율성을 동시에 만족하는 실시간 AVTSE 시스템의 부재를 해결한다. 기존 벤치마크는 화자 수를 2명으로 고정하거나 복잡한 실제 음향 환경(잔향, 원거리 간섭, 급격한 소음 등)을 반영하지 못한다는 한계가 있다 [Figure 1]. 또한, 기존의 고성능 causal 아키텍처들은 연산량이 과도하여 에지 디바이스 배포에 부적합하며, 경량화된 모델들은 반복적인 처리를 통해 연산 복잡도를 다시 높이는 trade-off 문제를 가진다. 따라서 연구자들은 실제 환경을 모사할 수 있는 새로운 벤치마크와, 실시간 추론을 보장하면서도 강력한 분리 성능을 갖춘 효율적인 아키텍처를 요구한다.
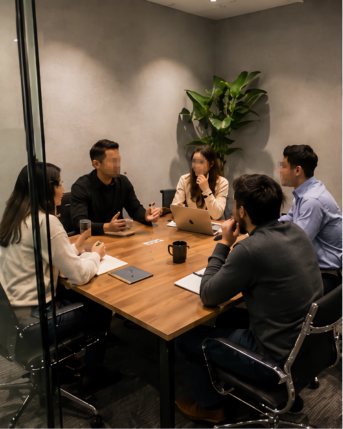
Figure 1 — RealSSA를 촉발하는 실제 시나리오
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 연구는 단일 encoder-decoder 패스를 통해 다중 스케일 시간-주파수 처리를 수행하는 Falcon 아키텍처를 제안한다 [Figure 2]. Falcon은 U-Net 형태의 구조를 기반으로 bottleneck에서 전역적인 문맥을 형성하고, 각 디코더 레벨에서 세부적인 분리를 수행함으로써 반복 연산 없이 효율성을 극대화한다 [Figure 3]. 또한, 추론 시 추가 비용 없이 간섭 화자의 잔여 leakage를 억제하기 위해 Encoder-Space Speaker Contrastive Loss를 도입하였다. 실험 결과, Falcon은 causal AV-TFGridNet 대비 파라미터 수를 91.9%, 연산량(FLOPs)을 20.2×, GPU 추론 레이턴시를 11.1× 절감하는 성과를 거두었다 [Table 3]. 더불어, 제안된 모델은 RealSSA-Sim 및 다양한 표준 벤치마크(LRS2-2Mix, LRS3-2Mix, VoxCeleb2-2Mix)에서 최첨단(State-of-the-art) 수준의 추출 품질을 달성하였다.
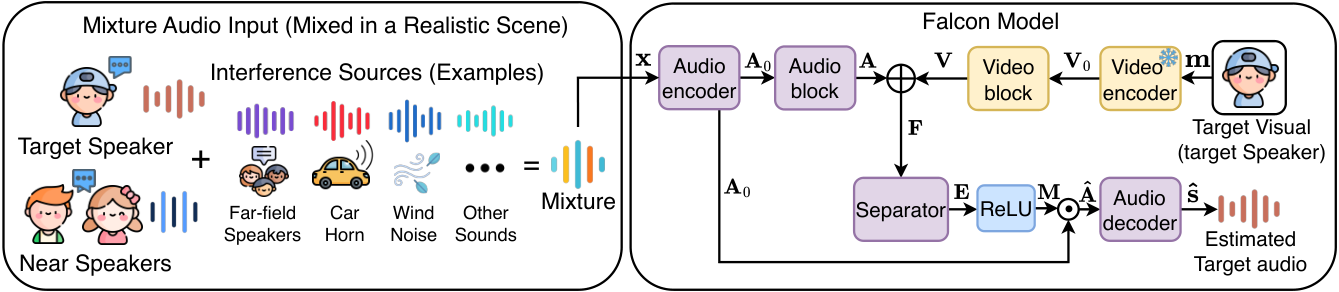
Figure 2 — Falcon 모델의 전체 파이프라인
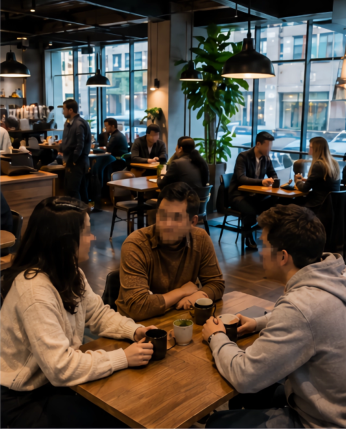
Figure 3 — Single-Pass Multi-Scale Separator 구조
4. Conclusion & Impact (결론 및 시사점)
본 논문은 실시간 AVTSE 분야에서 실용성과 효율성을 모두 갖춘 Falcon 모델과 현실적인 데이터셋 RealSSA를 성공적으로 제시하였다. 이 연구는 단순히 정확도를 높이는 것을 넘어, 복잡한 실제 음향 환경에서의 배포 가능성을 확보하고 에지 환경에서의 추론 지연 시간을 획기적으로 단축했다는 점에서 큰 의의가 있다. 본 방법론은 비디오 회의 시스템, 보청기 기기 등 레이턴시가 중요한 다양한 음성 처리 애플리케이션에 즉각적으로 적용되어 관련 산업의 기술적 진보를 이끌 것으로 기대된다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] What Makes a Good Unmasking Policy? A Controlled Study of Learned Unmasking in Diffusion Language Models
- [논문리뷰] WorldStream: Streaming Interactive 3D Worlds with Hierarchical Planning and Persistent State
- [논문리뷰] OpenGCUA: Toward a Fully Open Stack for Generalist Computer Use
- [논문리뷰] Are We Testing Too Much? A Survey of Benchmark Compression for Efficient Evaluation of Large Language Models
- [논문리뷰] VEDJE: Video-Efficient Discriminative Joint Encoder for Scalable Video-Text Retrieval
Review 의 다른글
- 이전글 [논문리뷰] CausGround: Causal Interaction Grounding for Adaptive Embodied Planning
- 현재글 : [논문리뷰] Efficient Streaming Audio-Visual Target Speaker Extraction for Real-World Acoustic Scenes
- 다음글 [논문리뷰] Evaluating DeepSeek V4.1 Flash-1017 for loss of control and harmful manipulation risks
댓글