[논문리뷰] VEDJE: Video-Efficient Discriminative Joint Encoder for Scalable Video-Text Retrieval
링크: 논문 PDF로 바로 열기
저자: Shahaf Wagner, Gabriele Serussi, Dan Ben Ami, et al.
1. Key Terms & Definitions
본 논문에서 제안하는 VEDJE(Video-Efficient Discriminative Joint Encoder)의 핵심 개념과 주요 구성 요소는 다음과 같습니다.
- Cached Joint Encoder: 쿼리 시점의 비디오 인코딩 비용을 줄이기 위해, 미리 압축된 비디오 표현을 저장하고 이를 활용하여 경량화된 조인트 인코더로 온라인에서 재랭킹(Reranking)을 수행하는 방식입니다.
- Frame-Indexed Cache: 비디오를 샘플링된 여러 프레임으로 나누고, 각 프레임의 특징을 개별적으로 압축하여 저장하는 캐시 구조입니다. 이는 시공간적 정보를 유지하면서도 캐시 크기를 최소화하는 데 기여합니다.
- Feature-Change Supervision: 캐시된 비디오 표현의 효율성을 높이기 위해 도입된 훈련 전용(training-only) 보조 손실 함수입니다. 이 방식은 샘플링된 프레임 간의 특징 변화를 예측하도록 학습하여, 추론 시 추가적인 연산 없이 압축된 캐시로부터 검색 성능을 향상시킵니다.
- R@1 (Recall@1): 검색 시스템의 성능 지표 중 하나로, 전체 쿼리 중 정답 아이템이 상위 1위로 검색된 비율을 나타냅니다. 본 논문에서는 Text-to-Video (T2V) 및 Video-to-Text (V2T) 검색 방향 모두에서 사용됩니다.
- Residual Prior: 첫 번째 검색 단계(First-Stage)에서 얻은 대략적인 유사도 점수
ρ(q,v)를 경량 조인트 인코더의 출력에 추가하여 최종 랭킹 점수s_θ(q,v)를 보정하는 메커니즘입니다.
2. Motivation & Problem Statement
대규모 비디오 검색 시스템은 일반적으로 두 단계로 운영되는데, 첫 번째 단계에서는 전체 인덱스에서 후보 비디오를 빠르게 검색하고, 두 번째 단계에서는 각 후보가 쿼리와 일치하는지 정밀하게 검증합니다. 기존 연구들은 듀얼 인코더(Dual-Encoder) 방식으로 저렴하게 후보를 검색하지만, 조인트 토큰(Joint Token) 상호작용 없이 유사도를 계산하여 정밀도가 떨어지는 한계가 있습니다. 반면, 조인트 리랭커(Joint Reranker)는 교차 모달리티(Cross-Modality) 어텐션을 통해 검색 성능을 향상시키지만, 비디오의 풍부한 표현을 쿼리마다 처리하거나 후보를 온라인으로 재인코딩하는 데 막대한 비용이 발생하여 높은 Latency를 유발합니다. 특히, Multimodal LLM (MLLM) 기반 리랭커는 수십억 개의 파라미터를 가진 디코더를 쿼리 경로에 직접 배치하여 배포에 있어 현실적인 어려움을 겪습니다. 이러한 문제에 직면하여, VEDJE 연구자들은 온라인 비디오 인코더 없이도 정교한 조인트 매칭(Joint Matching)이 가능한 효율적이고 확장 가능한 비디오 검색 시스템을 구축하는 것을 목표로 합니다. 즉, 다양한 객체, 액션 및 시간적 관계를 포함하는 쿼리에 대해 충분한 증거를 유지하면서도 저장 및 처리 비용을 최소화할 수 있는 재사용 가능한 비디오 캐시 설계가 핵심 문제입니다.
3. Method & Key Results
본 논문은 확장 가능한 비디오-텍스트 검색을 위해 쿼리 시점의 비디오 인코딩을 캐시 설계 문제로 전환하는 VEDJE 방법론을 제안합니다 [Figure 2]. VEDJE는 비디오별로 Visual Backbone을 한 번 오프라인으로 실행하여 프레임별로 압축된 특징을 Frame-Indexed Cache Z(v)로 저장하며, 쿼리 시점에는 경량 조인트 인코더가 이 캐시와 쿼리 텍스트, 그리고 첫 번째 단계의 스코어(First-Stage Score)를 읽어 Reranking을 수행합니다.
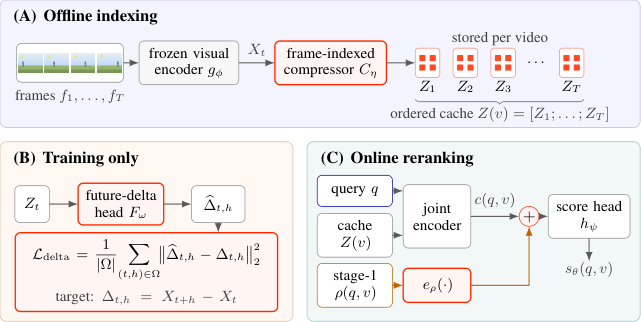
Figure 2 — VEDJE 파이프라인
VEDJE의 핵심 방법론은 다음과 같습니다. 첫째, Compact Frame-Indexed Video Caches는 각 샘플링된 프레임의 패치 특징을 소수의 토큰 뱅크 Z_t로 압축하고, 이 뱅크를 시간적 위치에 배치하여 Z(v)를 구성합니다. 이 구조는 고정된 저장 예산(예: 프레임당 1개의 캐시 토큰 사용 시 12 KiB)으로도 시공간적 증거를 보존할 수 있게 합니다. 둘째, Feature-Change Supervision은 훈련 시에만 사용되는 경량 예측기 F_ω를 통해 Z_t로부터 프레임 간의 특징 변화(Feature Differences)를 예측하는 보조 학습 목표 L_delta를 사용합니다. 이는 압축된 캐시로부터의 검색 성능을 향상시키면서도 추론 시에는 추가적인 연산 비용을 발생시키지 않습니다. 셋째, Cached Joint Reranking with a Residual Prior는 쿼리 텍스트 토큰과 캐시된 비디오 토큰 Z(v)를 결합하여 Pairwise Representation c(q,v)를 생성하고, 여기에 첫 번째 단계의 스코어 ρ(q,v)를 임베딩하여 Residual Prior로 추가함으로써 최종 랭킹 점수 s_θ(q,v)를 결정합니다. 온라인 재랭킹은 약 33M 파라미터를 가진 MiniLM-L12-uncased 모델을 기반으로 합니다.
이러한 방법론을 통해 VEDJE는 다음과 같은 핵심 결과를 달성했습니다. MSR-VTT, MSVD, DiDeMo, ActivityNet 등 4개 데이터셋에서 VEDJE는 매칭된 First-Stage Retriever 대비 일관되게 R@1 성능을 향상시켰습니다. 특히 MSR-VTT에서 Fine-tuned VideoCLIP-XL First-Stage를 사용할 경우, Text-to-Video R@1을 56.2%에서 59.8%로 +3.6%p 개선했으며, Video-to-Text R@1은 55.1%에서 58.8%로 +3.7%p 향상되었습니다. 이는 약 157M의 총 온라인 파라미터(Online Parameters)로 달성되었습니다 [Figure 1, cite: 1]. 또한, VideoPrism 설정에서 비디오당 캐시 크기를 12 KiB로 4배 축소했을 때도 Text-to-Video R@1 성능은 0.2%p 이내로 유지되었습니다. Feature-Change Supervision은 특히 타이트한 캐시 예산(예: 16 토큰)에서 R@1을 1.9%p 향상시키는 등 중요한 역할을 했습니다. 완전한 쿼리(Complete Query) 실행 비용 측면에서, NVIDIA L40S GPU 환경에서 20개 후보를 사용하는 64-token VEDJE 구성의 Latency는 5.79 ms로, First-Stage Retrieval 단독 실행(약 4.3 ms)과 비교할 만한 수준의 효율성을 보였습니다.
4. Conclusion & Impact
VEDJE는 미래 쿼리가 알려지지 않은 상황에서도 유용한 증거를 보존하는 재사용 가능한 비디오 캐시를 설계함으로써, 확장 가능한 조인트 비디오 검색의 주요 과제를 성공적으로 해결합니다. 본 연구는 압축된 특징을 샘플링된 프레임 내에서 유지하되, 각기 다른 시간대의 증거를 분리하여 접근 가능하도록 하는 캐시 조직의 가치를 입증했습니다. 또한, Feature-Change Supervision이 압축된 표현으로부터의 검색 성능을 효과적으로 개선함을 보여주었습니다. 결과적으로, VEDJE는 4가지 벤치마크(MSR-VTT, MSVD, DiDeMo, ActivityNet)에서 첫 번째 단계 검색뿐만 아니라 Fine-tuned First-Stage 검색에 대해서도 상당한 성능 향상을 제공했습니다. 이러한 연구 결과는 Compact한 증거가 한 번 계산되어 향후 쿼리에 재사용될 수 있는 효율적이고 정확한 조인트 비디오 검색의 실용적인 경로를 제시하며, 이는 학계 및 산업계에서 대규모 비디오 검색 시스템의 배포 가능성과 성능을 크게 향상시키는 중요한 시사점을 가집니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] SWE-at-Scale: Scalable Issue Synthesis from Historical Bug Fixes
- [논문리뷰] OpenGCUA: Toward a Fully Open Stack for Generalist Computer Use
- [논문리뷰] Are We Testing Too Much? A Survey of Benchmark Compression for Efficient Evaluation of Large Language Models
- [논문리뷰] Multics: Generative Multi-Player World Model with Hierarchical Communication
- [논문리뷰] SoftwareGym: Scaling Computer-Use Agent Training with Diverse Synthesized Software Environments
Review 의 다른글
- 이전글 [논문리뷰] Urbex: Agentic Spatial Grounding for City-Scale 3D Scenes
- 현재글 : [논문리뷰] VEDJE: Video-Efficient Discriminative Joint Encoder for Scalable Video-Text Retrieval
- 다음글 [논문리뷰] VIEWCRAFT: Evolving What Multimodal Agents See and How They Read It
댓글