[논문리뷰] Urbex: Agentic Spatial Grounding for City-Scale 3D Scenes
링크: 논문 PDF로 바로 열기
The paper "Urbex: Agentic Spatial Grounding for City-Scale 3D Scenes" proposes a new framework for city-scale 3D grounding. I will now extract the required information and format the summary.
Part 1: Summary
Authors: Yu Wang, Rui Dai, Wei Chen, Yi Wang, Bo Dang, Kaikui Liu, Xiangxiang Chu, Yansheng Li
Keywords: City-Scale 3D Grounding, Agentic Vision-Language Models, Reinforcement Learning, Spatial Search, Multi-View Environment, Tool Use
1. Key Terms & Definitions (핵심 용어 및 정의)
- City-Scale 3D Grounding: 자연어 쿼리를 사용하여 광범위한 도시 규모 3D Scene에서 특정 Object를 Localization하는 Task.
- Agentic Spatial Search: Static Candidate Ranking 방식과 달리, VLM Agent가 Interactive Multi-View Environment에서 Tool을 사용하여 능동적으로 Spatial 정보를 탐색하고 Target Location을 찾는 Method.
- Bird’s-Eye View (BEV): 도시 Scene을 위에서 내려다보는 Global View Image로, Urbex가 초기 Observation 및 주요 Spatial Interface로 활용한다.
- Landmark Query: 쿼리에 포함된 명명된 Landmark(예: Building, Road Name)를 해석하여 해당 Landmark의 World Position과 View Projection을 반환하는 Tool.
- Oblique Rendering: Agent가 선택한 Candidate Region을 특정 Cardinal Direction에서 3D View로 Render하여 Object Shape, Height, Spatial Placement를 Verification하는 Tool.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존의 City-Scale 3D Grounding Method들이 가진 Inefficiency와 제한적인 Accuracy 문제를 해결하고자 한다. 기존 Indoor 3D Grounding Method들은 Point Cloud를 Downsampling하여 Fine-Grained Geometry 정보를 손실시키며 (Figure 1b 참조), City-Scale Scene에 적용 시 성능 저하를 초래한다. Ranking-Based Method들은 Precomputed Instance Proposal에 의존하며, Proposal Quality에 따라 Accuracy가 결정되고 Candidate 수가 많아질수록 Inference Cost가 증가하는 한계가 있다. 또한, 이러한 Method들은 Grounding을 Static Retrieval Problem으로 간주하여 본질적으로 Sequential하고 Exploratory한 Urban Environment에서의 Localization 특성을 반영하지 못한다. 저자들은 이러한 문제점을 극복하고 City-Scale 3D Grounding을 Active Spatial Search Problem으로 재구성하여, VLM Agent가 Task-Specific Interactive Interface를 통해 Global Context와 Local Detail 사이를 효율적으로 이동하며 Target을 Localization할 수 있는 새로운 접근 방식의 필요성을 제기한다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 City-Scale 3D Grounding을 Active Spatial Search로 재정의하는 Agentic Vision-Language Framework인 Urbex를 제안한다. Urbex는 City-Scale 3D Scene을 Interactive Multi-View Environment로 표현하며 [Figure 2], VLM Agent는 Landmark Query, Zoom-in, Oblique Rendering과 같은 City-Aware Tool을 사용하여 Scene과 상호작용한다. Agent는 Global Bird’s-Eye View (BEV)에서 시작하여 Landmark Query로 Coarse Spatial Anchor를 설정하고, Zoom-in으로 유망한 Region을 Fine-Grained Inspection하며, Oblique Rendering으로 3D Confirmation을 수행한 후 최종 Bounding Box를 Commit한다. 이 Tool-Use Policy는 CityRefer Dataset에서 Reinforcement Learning (GRPO)을 통해 Optimization된다.
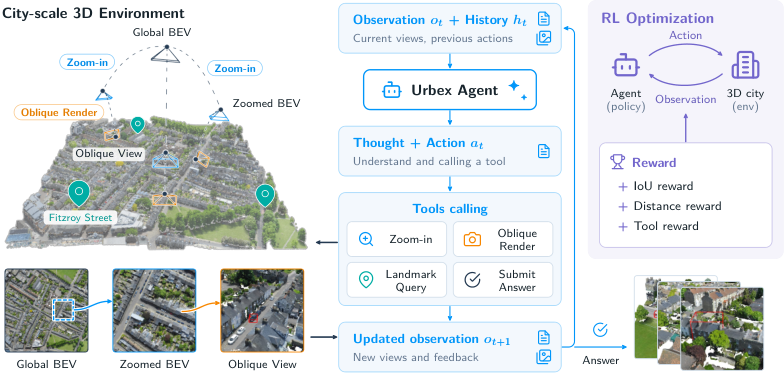
Figure 2 — Urbex 아키텍처
핵심 결과로, Urbex는 CityRefer Dataset에서 Baseline Method들을 능가하는 성능을 보였다. With GT Setting에서 Urbex는 Hit@1 및 Hit@3 Metric에서 가장 우수했으며, 특히 NO Split에서 Hit@5도 최고 성능을 달성했다. Without GT Setting에서는 2D IoU, 3D IoU, Point F1 모두에서 Urbex가 우월한 성능을 보여, Candidate-Free Grounding 능력을 입증했다 (Table 1 참조). 또한, Urbex는 가장 강력한 Ranking Baseline인 CityAnchor 대비 약 10배 빠른 Online Inference Efficiency를 달성했다 (3.2초/Query vs 32.1초/Query). Zero-Shot Generalization Test인 STPLS3D-Refer Dataset에서도 Urbex는 모든 Accuracy Metric에서 최고 점수를 기록하며, 학습된 Policy가 새로운 Geometry와 Visual Appearance를 가진 Scene에도 Robust하게 Transfer됨을 입증했다 (Table 2 참조). Ablation Study를 통해 Landmark Query, Zoom-in, Oblique Rendering 각 Tool과 Terminal Reward 및 Tool-Level Shaping Reward의 기여도가 확인되었다 (Tables 3, 4 참조).
4. Conclusion & Impact (결론 및 시사점)
본 논문은 City-Scale 3D Grounding을 위한 Agentic Framework인 Urbex를 제안하며, 기존의 Static Candidate Ranking 방식을 능동적인 Spatial Search로 재정의하는 성공적인 접근 방식을 제시한다. Urbex는 Interactive Multi-View Environment에서 VLM Agent가 City-Aware Tool을 사용하여 Efficient하고 Accurate하게 Localization을 수행하도록 Reinforcement Learning으로 Optimization된다. 이 연구는 CityRefer Dataset에서 Baseline 대비 뛰어난 Grounding Accuracy와 Inference Efficiency를 달성했으며, Candidate-Free Localization을 지원한다. 또한, STPLS3D-Refer Dataset에서의 Zero-Shot Generalization 결과는 Urbex의 Active Spatial Search가 대규모 3D Scene Understanding에서 Robust한 대안임을 시사한다. 이는 Embodied Intelligence, Autonomous Driving, Robotic Navigation 등 다양한 응용 분야에서 Long-Range Spatial Reasoning 및 Fine-Grained Visual Recognition 능력을 요구하는 Task의 발전에 중요한 시사점을 제공한다.
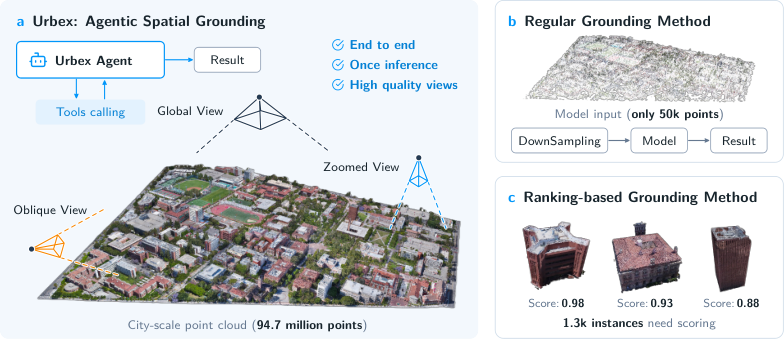
Figure 1 — Urbex 개요
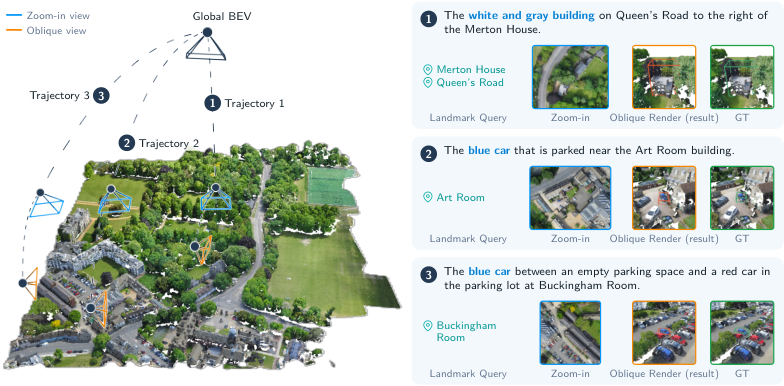
Figure 3 — CityRefer 정성적 예시
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] WorldCast: Exploring Intelligent Visual Generation in World State Prediction
- [논문리뷰] Waypoint-OPD: Transferring RL-Induced Policy Shifts via Gated On-Policy Distillation
- [논문리뷰] Virtual Head Attention
- [논문리뷰] VLA-Δ: Learning Physical State Transition for Vision-Language-Action Models
Review 의 다른글
- 이전글 [논문리뷰] UniForge3D: Joint 3D Reconstruction and Generation in a Shared Anchor-Guided Space
- 현재글 : [논문리뷰] Urbex: Agentic Spatial Grounding for City-Scale 3D Scenes
- 다음글 [논문리뷰] VEDJE: Video-Efficient Discriminative Joint Encoder for Scalable Video-Text Retrieval
댓글