[논문리뷰] Multi-Token Prediction Done Right
링크: 논문 PDF로 바로 열기
Part 1: 요약 본문
저자: Jayden Teoh
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- Multi-Token Prediction (MTP): 모델이 다음 토큰뿐만 아니라 미래의 여러 토큰을 예측하도록 학습하는 방식으로, downstream 성능 향상과 speculative decoding 가속화에 활용됨.
- KL Self-Distillation: MTP 헤드가 모델 자신의 next-token prediction (NTP) 분포를 모사하도록 하여 추론 안정성과 성능을 높이는 학습 신호.
- KL Gradient–Recovery Trick: MTP 학습 시 발생하는 cross-entropy gradient에서 명시적인 KL divergence 계산 없이 self-distillation 신호를 추출하는 straight-through gradient routing 기법.
- Soft-MTP: KL gradient-recovery trick을 적용하여 MTP gradient에서 노이즈가 많은 residual을 제거하고, 핵심적인 self-distillation 신호만을 효과적으로 전파하는 학습 방법론.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 기존 MTP 학습은 standard cross-entropy objective를 사용하는데, 이 gradient에는 유용한 KL self-distillation 신호와 학습을 방해하는 고노이즈(low signal-to-noise ratio) residual 성분이 혼재되어 있습니다. 저자들은 이 residual 성분이 모델 규모가 커질수록 NTP 및 MTP 학습 과정에서 더 심각한 간섭을 일으키며 학습 효율을 저해한다는 점을 발견하였습니다 [Figure 3]. 기존 연구에서 이를 해결하고자 시도한 명시적 KL divergence 최소화는 계산 자원 소모가 크고, 표준 fused cross-entropy 커널과 호환되지 않는다는 한계가 있습니다. 따라서 본 논문은 추가 비용 없이 기존 학습 프레임워크 내에서 순수한 self-distillation 신호만을 추출하는 새로운 최적화 기법을 제안합니다.
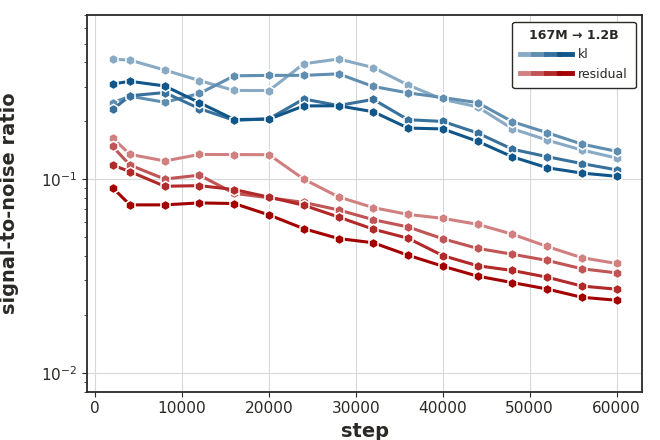
Figure 3 — 모델 규모별 gradient SNR 비교
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 본 논문은 MTP gradient가 KL self-distillation 성분과 잔차 성분(residual)으로 명확히 분해됨을 이론적으로 증명하고, 이를 바탕으로 Soft-MTP를 제안합니다 [Figure 1]. 저자들은 Straight-Through Gradient Routing을 활용하여 MTP 헤드와 모델 trunk에 residual 성분을 배제한 KL gradient만을 전파하는 KL gradient-recovery trick을 도입하였습니다. 이 방식은 단 한 줄의 코드 수정으로 구현 가능하며, 추가적인 parameter나 연산 오버헤드가 전혀 발생하지 않습니다. 실험 결과, 167M에서 1.2B 규모의 모델에서 Soft-MTP는 기존 standard MTP 대비 더 낮은 NTP perplexity를 달성하였습니다 [Figure 4]. 특히, speculative decoding 속도 향상과 더불어 수학 및 코드 추론 능력이 유의미하게 개선되었으며, 대부분의 지표에서 고비용의 명시적 KL 최적화 기법과 대등하거나 능가하는 성능을 보였습니다 [Table 1].
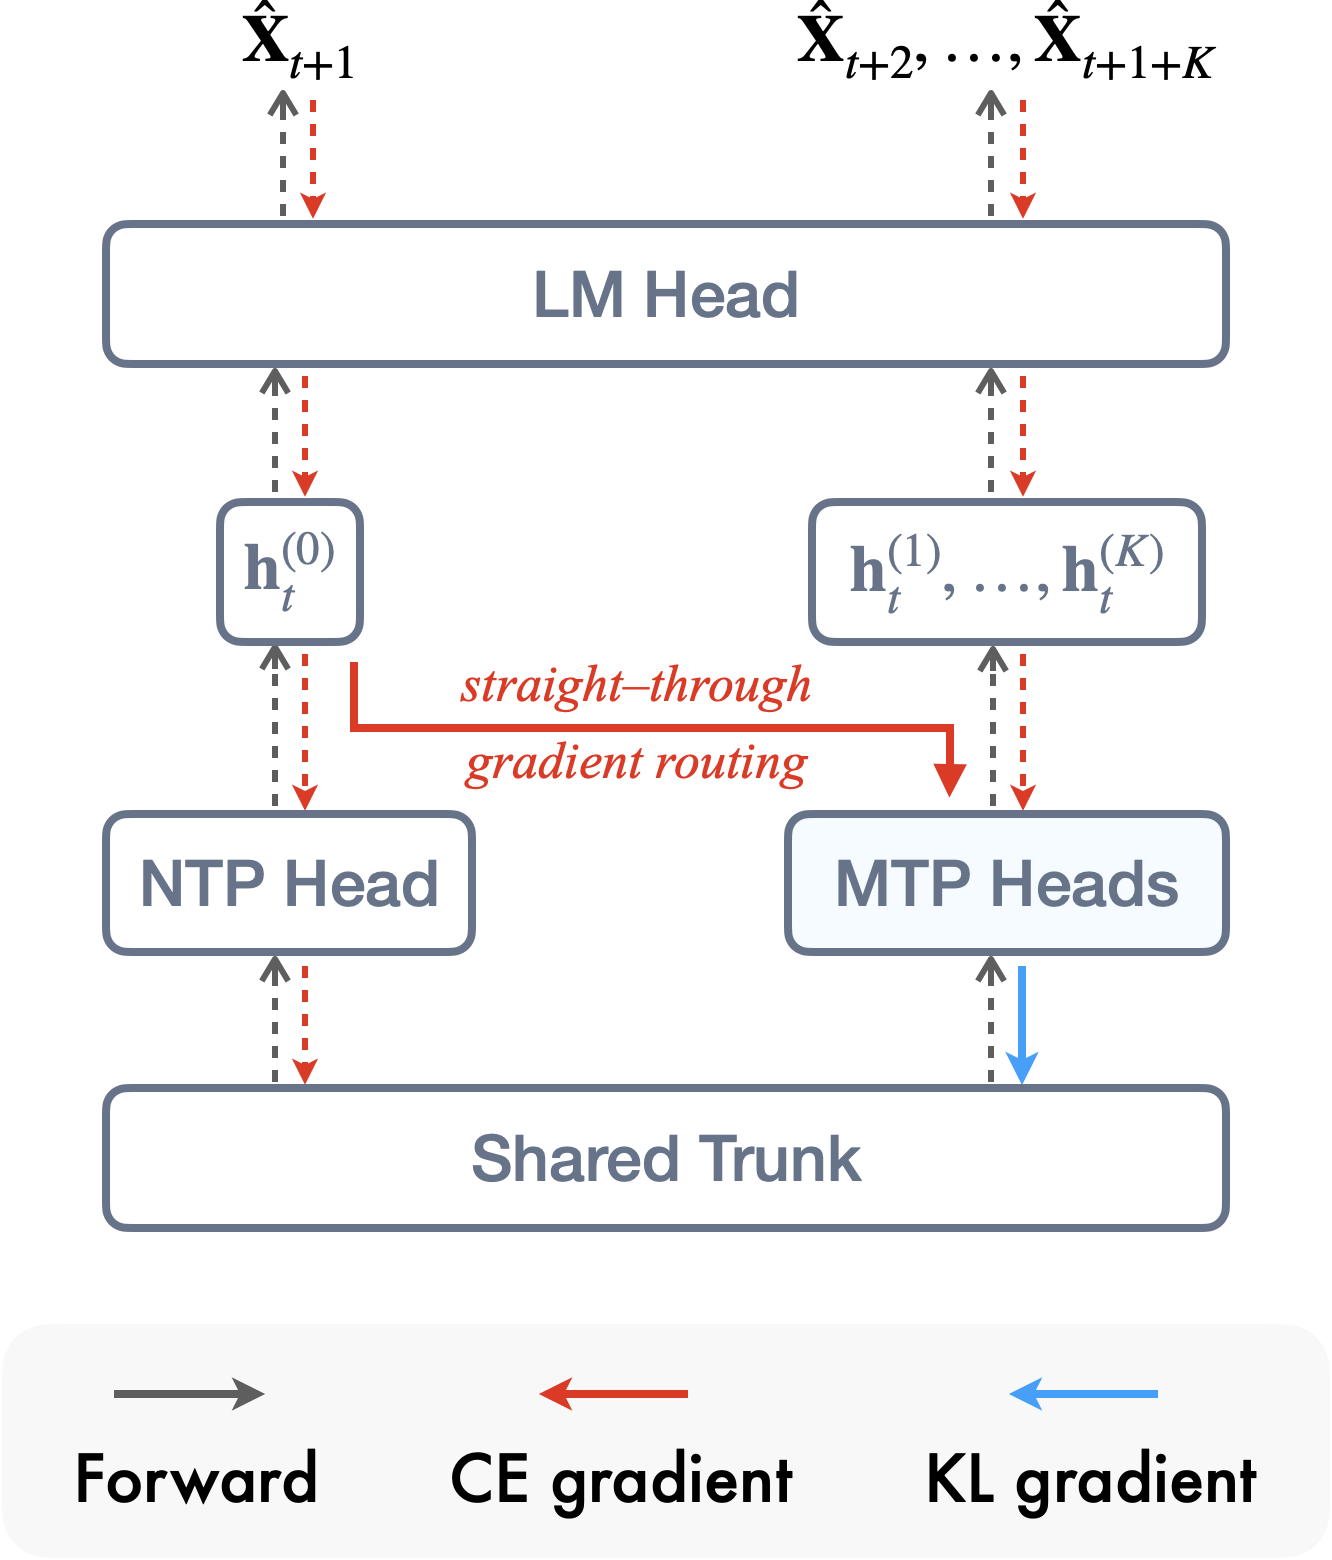
Figure 1 — Soft-MTP 개념 및 구현
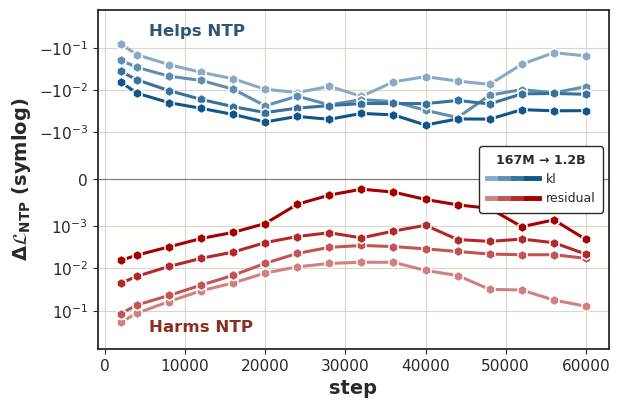
Figure 4 — residual의 학습 간섭 효과 분석
## 4. Conclusion & Impact (결론 및 시사점) 본 연구는 MTP 학습에서 residual 성분이 실질적인 노이즈로 작용함을 밝히고, 이를 제거하는 최적의 솔루션인 Soft-MTP를 제시함으로써 LLM 사전 학습 최적화의 새로운 방향을 제시했습니다. 제안된 방법론은 frontier-scale 모델 학습에 요구되는 효율성과 확장성을 모두 충족하며, 복잡한 인프라 변경 없이 즉각적인 성능 개선을 제공합니다. 이는 향후 대규모 언어 모델의 학습 효율성을 극대화하고 speculative decoding의 신뢰성을 높이는 데 핵심적인 기여를 할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] ECHO: Efficient Causal Self-Recursion Beyond Auxiliary Multi-Token Prediction
- [논문리뷰] The Lexical Imprint of Pre-training Data
- [논문리뷰] On the SPOT: Enhancing Speculative Decoding for Diffusion Language Models via Commit-Order Prediction
- [논문리뷰] Spatial Audio Generation and Editing with Executable Plans and Self-Distilling Transfusion
- [논문리뷰] Speculative Diffusion is a Tale of Two Tradeoffs
댓글