[논문리뷰] Online Dense Reinforcement Learning with Planning-Grounding Agent for UI Navigation on Live IOS Apps
링크: 논문 PDF로 바로 열기
메타데이터
저자: Peitong Duan, Khashayar Gatmiry, Jeffrey Nichols, Samy Bengio, Emmanuel Abbe, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Planning Agent: 사용자의 목표를 해석하고, 이를 달성하기 위한 고수준의 계획(Chain-of-Thought)과 단계별 실행 계획을 생성하는 모델입니다.
- UI Grounding Model: Planning Agent가 생성한 고수준의 단계를 입력받아, 화면 내 특정 좌표(x,y)와 action primitive를 결정하여 실제 기기에서 실행하는 모델입니다.
- LLM-as-a-Judge: 환경과의 상호작용 결과를 평가하기 위해 대규모 언어 모델을 활용하여, step-level의 Dense Reward와 episode-level의 Terminal Reward를 산출하는 프레임워크입니다.
- GiGPPO: 학습 과정에서 visually similar한 상태 간의 reward 신호를 critic에 반영하여 안정적인 학습을 도모하는 neighbor-conditioned value estimation 방법론입니다.
- Asymmetric Discounting: 학습 시 Dense Reward는 감쇠(γ=0.5)를 적용하여 효율적인 학습을 유도하고, Terminal Reward는 무감쇠(γ=1)로 처리하여 task 완료를 강력하게 유도하는 reward 설계 전략입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 frontier 모델의 높은 Inference Cost와 SFT 방식의 제한적인 범용성 문제를 해결하기 위해, 실제 iOS 환경에서 작동하는 효율적인 온라인 강화학습 프레임워크를 제안합니다 [Figure 1]. 기존의 SFT는 특정 데이터셋에 과적합되어 에러 발생 시 회복 능력이 떨어지며, 기존 RL 연구들은 sparse한 Terminal Reward에 의존하거나 단순 반복 작업에 치중하여 일반화 성능이 낮다는 한계가 있습니다. 이를 해결하기 위해 저자들은 계획과 실행을 분리하고, dense한 피드백을 통해 학습 효율을 높이는 새로운 온라인 RL 시스템을 구축하였습니다 [Figure 1].
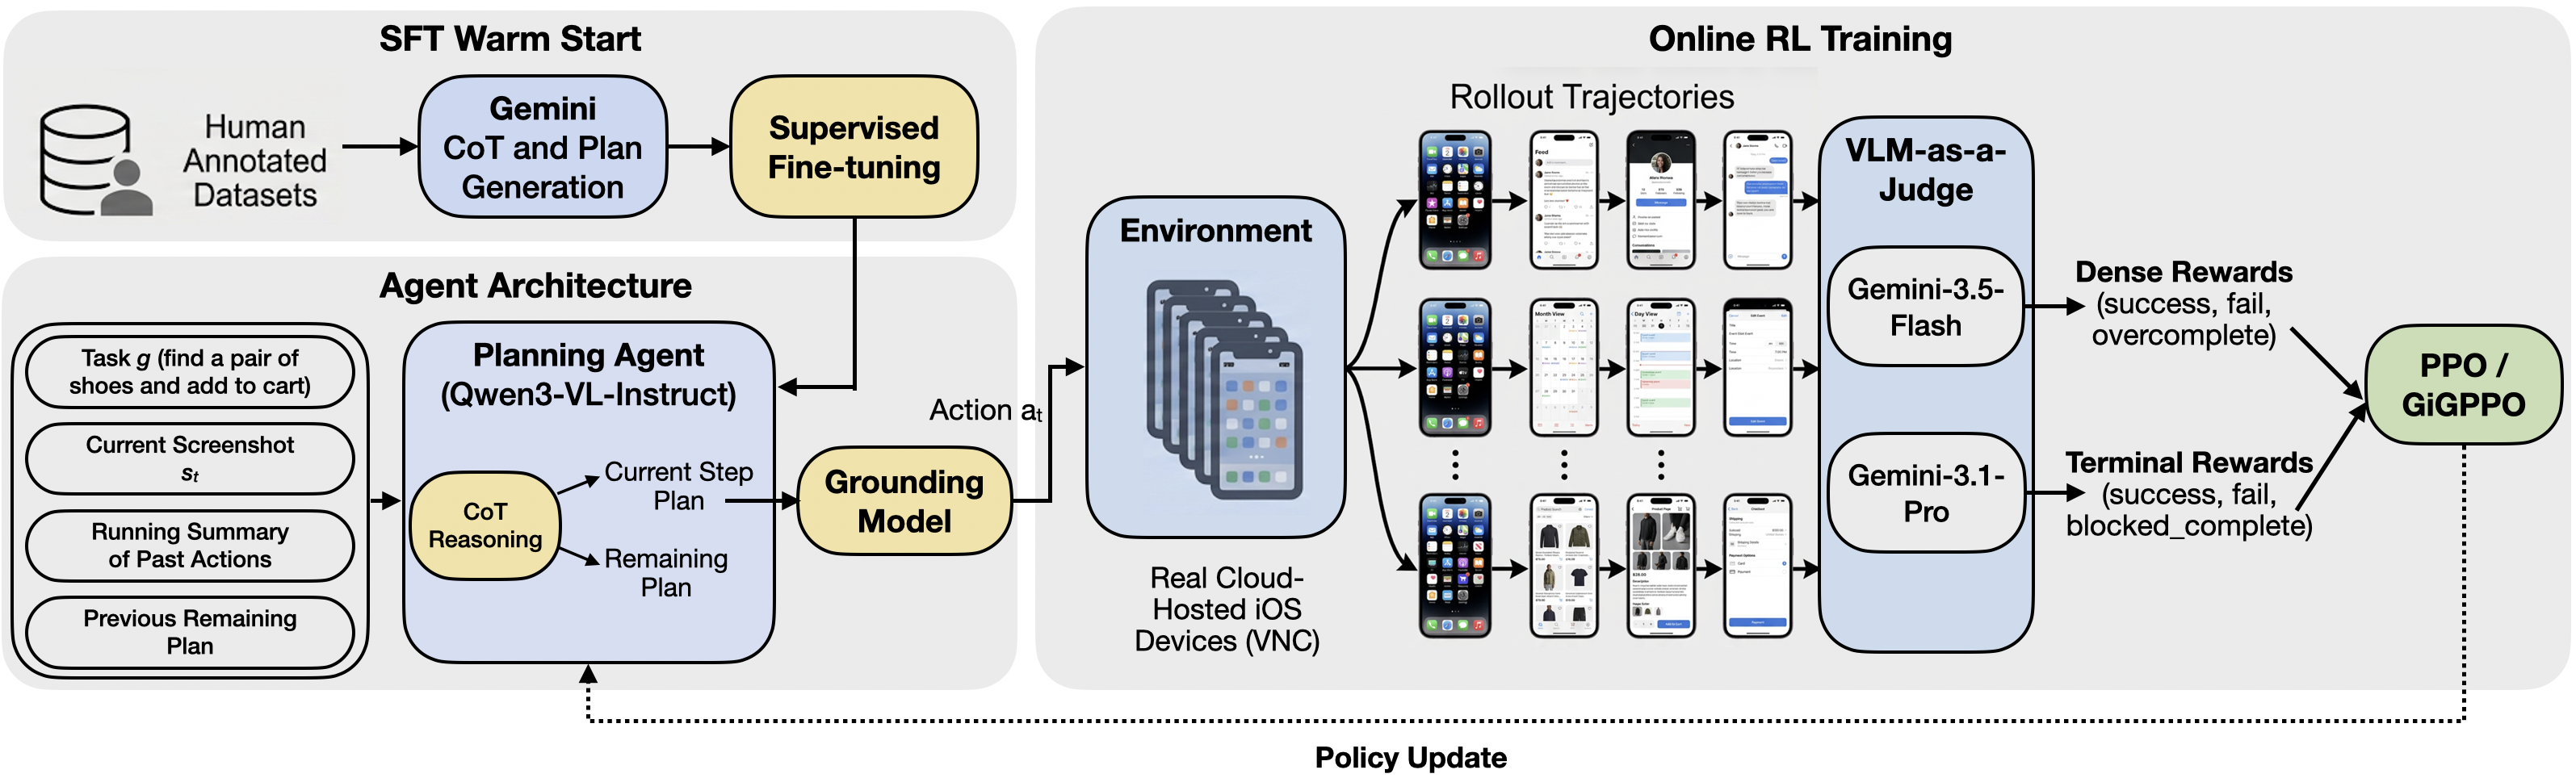
Figure 1 — iOS 에이전트 아키텍처 및 학습 시스템 개요
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 연구는 Planning Agent와 UI Grounding Model을 분리하고, PPO 알고리즘 기반의 Asymmetric Discounting 전략과 GiGPPO를 결합하여 학습 효율을 극대화합니다 [Figure 1]. 특히 LLM-as-a-Judge를 통해 step별 진척도와 최종 목표 달성 여부를 정량적으로 평가하여 에이전트의 안정적인 탐색을 유도합니다. 실험 결과, 8B 파라미터를 가진 RL 에이전트는 SFT Baseline 대비 AndroidWorld 환경에서 약 7배 높은 성공률을 기록하며 뛰어난 일반화 성능을 입증하였습니다 [Table 1]. 또한, UINavBench에서 Gemini-3.1-Pro와 대등한 성능(32.4%)을 달성하는 동시에, Gemini-3.5-Flash를 능가하는 등 소형 모델로서 높은 Throughput과 효율성을 보여주었습니다 [Table 1].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 실시간 iOS 애플리케이션 환경에서 대규모로 에이전트를 학습시키는 온라인 강화학습 프레임워크를 성공적으로 구축하였습니다. 제안된 GiGPPO와 dense reward 전략은 이전 방식보다 훨씬 빠른 학습 수렴 속도를 보였으며, 에이전트의 에러 복구 능력 및 일반화 성능을 비약적으로 향상시켰습니다. 이러한 연구 결과는 모바일 기기상에서 AI 에이전트를 일상적으로 활용하기 위한 경량화 모델 학습의 새로운 표준을 제시하며, 향후 더 복잡하고 긴 호흡의 사용자 태스크를 자동화하는 기반 기술로 작용할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Rethinking Critic Learning in PPO: Understanding and Mitigating Value Flattening
- [논문리뷰] ESPO: Early-Stopping Proximal Policy Optimization
- [논문리뷰] DenseGRPO: From Sparse to Dense Reward for Flow Matching Model Alignment
- [논문리뷰] Training Foundation Models with a Single Algorithm
- [논문리뷰] IntReal: A Real-World Dataset and Benchmark for Multimodal Interleaved Generation
Review 의 다른글
- 이전글 [논문리뷰] Multi-Token Prediction Done Right
- 현재글 : [논문리뷰] Online Dense Reinforcement Learning with Planning-Grounding Agent for UI Navigation on Live IOS Apps
- 다음글 [논문리뷰] OpenFlyV2: An onboard vision-language-action model for aerial perception and navigation
댓글