[논문리뷰] Your LR Schedule May Not Be Principled: Effective Learning Rate Scheduling in Weight-Normalized Training
링크: 논문 PDF로 바로 열기
저자: Qifan Yu, Xinyu Ma, Xingyan Bin, Di He
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- Weight-Normalized (WN): 각 파라미터 블록의 노름(norm)을 업데이트 후 고정하여 학습의 안정성과 토큰 효율성을 높이는 기법입니다.
- Effective Learning Rate (ELR): 명목상의 학습률(nominal LR)을 파라미터 블록의 노름으로 나눈 값($\eta_{eff} = \eta/r$)으로, 모델의 가중치 업데이트가 실제 방향 변화에 미치는 실질적인 영향력을 나타내는 지표입니다.
- AIR (Affine Inverse-square-Root decay): 저자들이 제안한 새로운 학습률 스케줄링 방식으로, 이론적으로 도출된 $1/\sqrt{t}$ 감쇠 형태를 아핀 변환(affine transformation)하여 지정된 피크 및 종단 학습률에 맞춘 기법입니다.
- Directional Alignment: 모델 파라미터가 최적의 타겟 방향으로 얼마나 일치하게 진화하는지를 나타내는 척도로, 본 논문에서는 이를 최대화하는 방향으로 학습률 스케줄을 설계합니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 연구는 Weight-Normalized (WN) 학습이 기존 Weight Decay (WD) 기법과 달리 왜 특정한 학습률 스케줄에서 다른 성능을 보이는지 그 근본 원인을 규명하고자 합니다. 기존 연구들은 WN이 노름을 고정함으로써 얻는 이점만을 강조했으나, 본 논문은 학습 손실(training loss) 동역학의 차이가 사실은 노름 자체보다 ELR 궤적의 차이에서 비롯됨을 밝힙니다. 실제로 [Figure 1]에서 볼 수 있듯이, 동일한 명목 학습률을 사용하더라도 두 기법의 ELR은 상이하게 진화하며, 이로 인해 학습 결과에 큰 격차가 발생합니다. 따라서 단순히 명목 학습률만 제어하는 스케줄은 WN 학습에서 원칙적(principled)이지 않으며, ELR을 직접적으로 타겟팅하는 새로운 스케줄 설계가 필수적입니다.
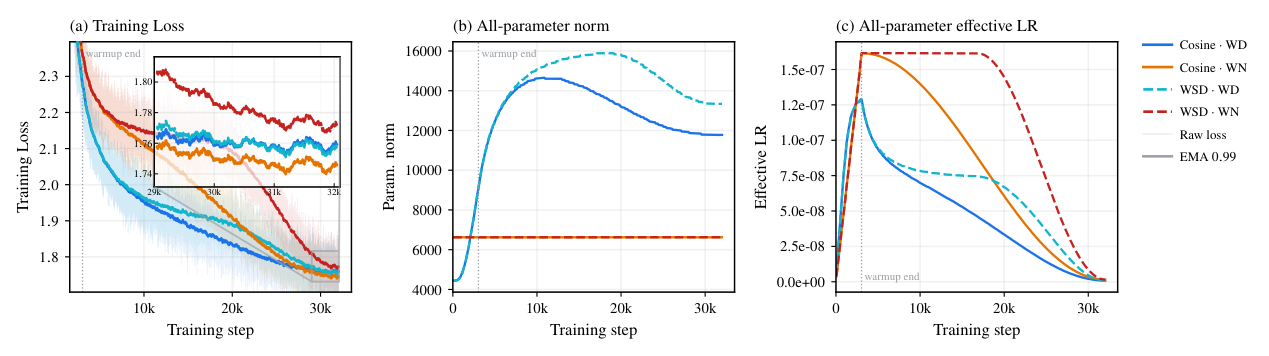
Figure 1 — WN과 WD의 학습 손실 및 ELR 차이를 보여주는 핵심 분석 결과
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 본 연구는 WN 환경에서 방향 정렬(directional alignment)을 최대화하는 최적의 ELR 궤적이 $1/\sqrt{t}$ 형태임을 이론적으로 유도하고, 이를 실제 학습 환경에 적용 가능한 AIR로 구현하였습니다. AIR는 학습 기간 동안 고정된 피크 및 종단 학습률 제약 조건을 아핀 변환을 통해 만족시키며, 특히 학습 후반부의 스케줄링이 최종 성능에 결정적인 영향을 미친다는 점을 발견하여 이를 최적화했습니다. [Table 1]에 따르면, AIR 스케줄은 128 B-token MoE 사전 학습에서 기존 cosine 스케줄 대비 최종 학습 손실을 약 0.01가량 감소시키며 더 나은 다운스트림 성능과 하이퍼파라미터에 대한 강건성(robustness)을 보여줍니다. 또한, [Figure 2]와 같이 ELR 궤적을 일치시키는 것만으로도 WD와 WN의 학습 손실 동역학이 거의 일치(collapse)함을 증명하여, ELR이 학습 스케줄링의 핵심 원칙임을 입증하였습니다.
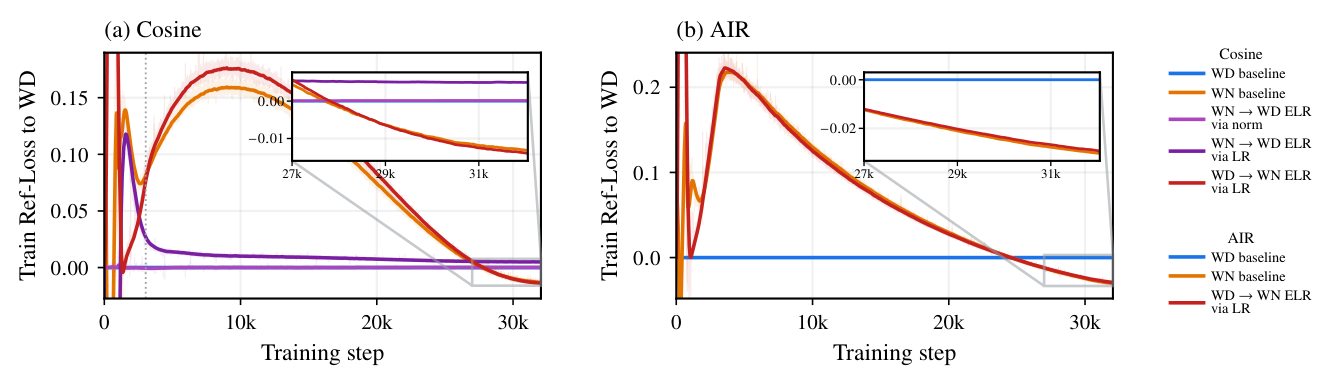
Figure 2 — ELR 일치를 통해 두 학습 기법의 동역학이 일치함을 증명하는 핵심 실험 결과
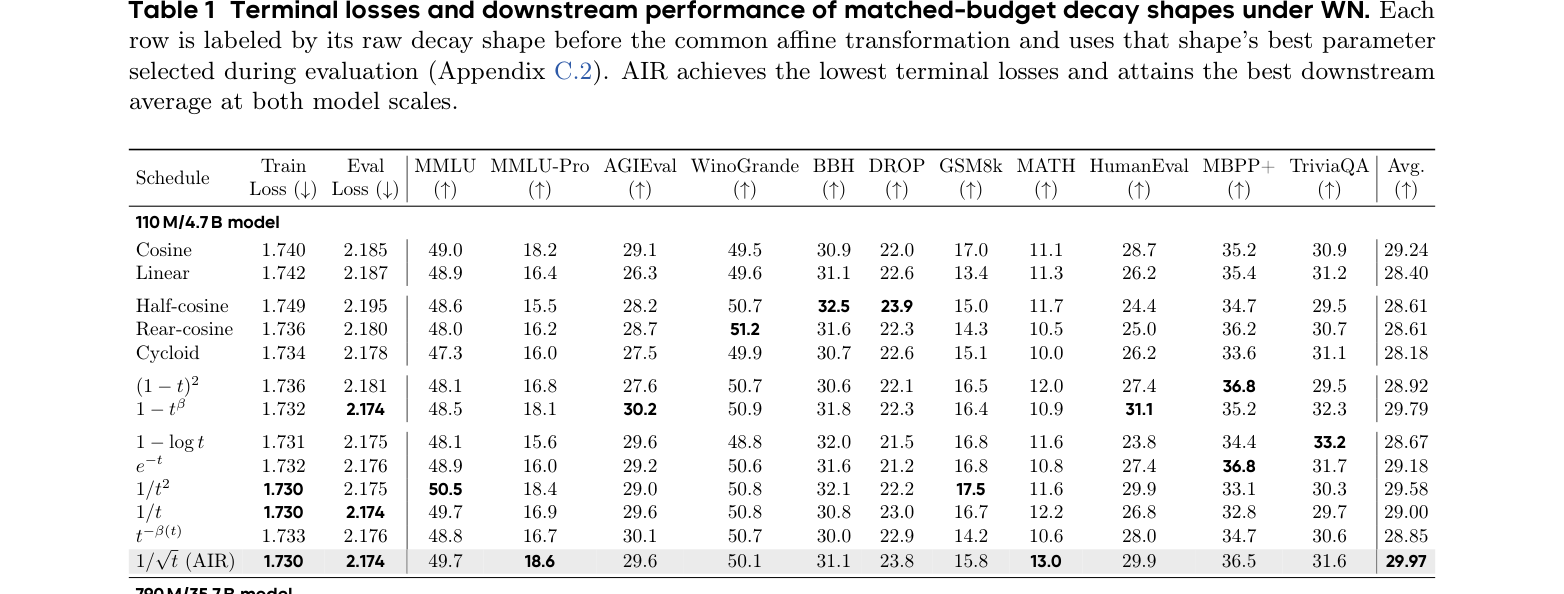
Table 1 — 제안 기법인 AIR가 기존 스케줄 대비 우수한 성능을 나타내는 정량적 벤치마크 테이블
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 ELR이 WN 학습의 성공을 결정짓는 핵심 동인임을 명확히 규명하고, 이를 위한 실질적인 스케줄링 기법으로 AIR를 제안하였습니다. 본 연구의 결과는 학습률 스케줄링이 단순한 경험적 선택을 넘어, 이론적 최적화 원칙에 기반하여 설계되어야 함을 시사합니다. 향후 AIR는 LLM 사전 학습뿐만 아니라 지속 학습(Continued Training), 지도 미세 조정(SFT) 및 강화 학습(RL) 등 다양한 학습 설정에서 더욱 효율적인 최적화 파이프라인을 구축하는 데 중요한 토대가 될 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Competing Learning in Hybrid Architectures
- [논문리뷰] Scaling Domain Data Repetition in LLM Pretraining
- [논문리뷰] OmniOpt: Taxonomy, Geometry, and Benchmarking of Modern Optimizers
- [논문리뷰] Rethinking Shrinkage Bias in LLM FP4 Pretraining: Geometric Origin, Systemic Impact, and UFP4 Recipe
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
Review 의 다른글
- 이전글 [논문리뷰] Your Benchmark Is an Empirical Measure Over Difficulty
- 현재글 : [논문리뷰] Your LR Schedule May Not Be Principled: Effective Learning Rate Scheduling in Weight-Normalized Training
- 다음글 [논문리뷰] Youtu-Parsing-Omni: One Encoder, One Schema, All Modalities
댓글