[논문리뷰] Youtu-Parsing-Omni: One Encoder, One Schema, All Modalities
링크: 논문 PDF로 바로 열기
메타데이터
저자: Yunhang Shen, Zhangquan Chen, Xiaotian Li, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Youtu-Omni-Encoder: 시각과 청각을 아우르는 단일 인코더로, 서로 다른 모달리티의 토큰을 공통된 시공간 좌표계 내에서 처리하고 융합하는 핵심 모듈입니다.
- OmniSchema: 10개의 파싱 태스크를 통합하는 단일 출력 규격으로, 모든 출력이 공간적/시간적 앵커(anchor)를 포함하도록 하여 LLM이 근거를 추적할 수 있게 합니다.
- OSAD (OmniSchema-Aware On-Policy Distillation): 모델이 자신의 출력에 대해 토큰 단위로 학습하도록 설계된 자기 진화적 학습 기법으로, 참조 조건부(reference-conditioned) 생성을 통해 지도 없이도 정교한 학습이 가능하게 합니다.
- Space-Time Positional Encoding: 이미지의 공간(H, W)과 영상/음성의 시간(T) 정보를 하나의 로터리 포지션 임베딩 체계 안에서 동일하게 표현하여 시공간 정렬을 달성하는 기법입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 다양한 모달리티(문서, 이미지, 오디오, 비디오)를 개별적으로 처리하는 기존 방식의 파편화 문제를 해결하고자 합니다. 현재의 파서들은 모달리티별로 별도의 인코더를 사용하므로 모달리티 간 상호작용이 부족하고, 각기 다른 출력 형식을 가져 Agent의 다중 모드 통합 추론을 방해합니다 [Figure 3]. 또한, 기존의 지도 미세 조정(SFT)은 모델 자신의 생성 결과를 충분히 활용하지 못하며, 시퀀스 레벨의 보상은 세밀한 토큰 단위의 정교함을 담보하기 어렵다는 한계가 있습니다. 이러한 문제를 해결하기 위해 저자들은 모달리티 통합 인코더와 단일 출력 스키마를 갖춘 Youtu-Parsing-Omni를 제안합니다.
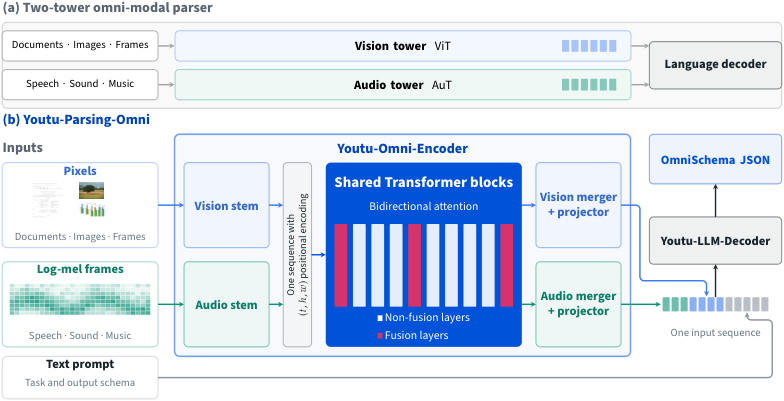
Figure 3 — 기존 및 제안 모델 아키텍처 비교
3. Method & Key Results (제안 방법론 및 핵심 결과)
Youtu-Parsing-Omni는 단일 인코더 아키텍처를 기반으로 텍스트를 포함한 모든 입력을 구조화된 JSON 데이터로 변환합니다 [Figure 2]. 인코더는 공유된 Transformer 블록을 사용하여 시각과 청각 토큰을 융합하며, Audio-Visual Fusion 레이어를 통해 짧은 윈도우 내에서 프레임과 오디오의 대응 관계를 직접 계산합니다. 학습 과정에서는 SFT 이후 OSAD를 도입하여, 학습 중인 모델이 스스로 생성한 결과에 대해 더 나은 성능을 가진 '참조용 복사본'으로부터 토큰 단위의 피드백을 받아 진화하도록 최적화합니다.
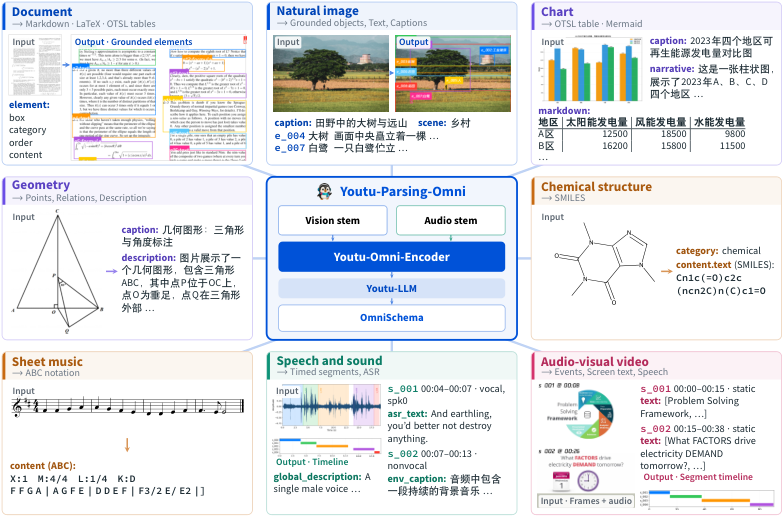
Figure 2 — 단일 인코더/스키마 파싱 구조
실험 결과, 55B 파라미터 모델인 Youtu-Parsing-Omni는 OmniDocBench v1.6에서 96.96점을 기록하며 SOTA 성능을 달성했습니다 [Figure 1]. OmniParsingBench에서도 75.08점의 평균 점수로 오픈 가중치 모델 중 1위를 차지했으며, 특히 오디오와 비디오 처리 태스크에서 월등한 성능 우위를 보였습니다. 화학 구조 분석(Tani@1.0 54.2)과 악보 필사(CER 22.73) 등 특수 도메인에서도 전문 모델들과 대등하거나 더 우수한 성능을 입증했습니다 [Figure 1].
Figure 1 — 벤치마크 평가 결과 요약
4. Conclusion & Impact (결론 및 시사점)
본 연구는 단일 인코더와 단일 스키마만으로도 범용 다중 모드 파싱이 가능하다는 것을 실증하며, 향후 Agent의 시지각 인식 인터페이스로서의 발전 가능성을 제시했습니다. 특히, 시공간 정렬을 인코더 내부에서 처리하고 OSAD를 통해 파서가 스스로 학습하는 구조는 향후 복잡한 멀티모달 데이터 처리에 있어 새로운 표준이 될 것으로 기대됩니다. 이 연구는 학계와 산업계 모두에 파싱 시스템의 경량화와 성능 극대화를 동시에 달성할 수 있는 프레임워크를 제공합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] How Much Does the Hint Matter? Scope Conditions for Hindsight Self-Distillation in Financial Reasoning
- [논문리뷰] PRISM: PRIvileged Sibling-guided Multi-Agent Topology Design
- [논문리뷰] Prospective Hindsight: Self-Calibrating Reinforcement Learning via Prediction-Reality Gaps
- [논문리뷰] On-Policy Distillation with Negative-Policy Rollouts
- [논문리뷰] Gains and Collapse in On-Policy Distillation:A Reinforcement Learning Perspective
Review 의 다른글
- 이전글 [논문리뷰] Your LR Schedule May Not Be Principled: Effective Learning Rate Scheduling in Weight-Normalized Training
- 현재글 : [논문리뷰] Youtu-Parsing-Omni: One Encoder, One Schema, All Modalities
- 다음글 없음
댓글