[논문리뷰] Dory1.0-4B: A Looped Normalized-GPT
링크: 논문 PDF로 바로 열기
메타데이터
저자: Maxim Fishman, Simeng Sun, Shantanu Acharya, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Dory1.0-4B: 4-billion parameter 규모의 looped(latent-recurrent) language model로, inference 시 반복 횟수(loop count)를 조절하여 컴퓨팅 자원과 성능을 동적으로 조정 가능함.
- nGPT (Normalized Transformer): 입력 데이터를 L2 normalization하는 Transformer 기반 아키텍처로, 안정적인 학습과 높은 성능을 제공하는 Dory1.0-4B의 backbone임.
- Loop Curriculum: 모델 학습 및 RLVR 과정에서 더 어려운 과업(어려운 prompt)에 대해 더 많은 recurrent block 반복 횟수를 할당하도록 하는 전략임.
- NVFP4: NVIDIA의 block-scaling 4-bit precision 포맷으로, BF16 대비 약 20%의 end-to-end 학습 속도 향상을 가능하게 함.
- Last-Loop KV Caching: 반복적인 loop 수행 시에도 마지막 loop의 KV cache만을 유지하여, loop count와 무관하게 고정된 메모리 footprint를 유지하는 추론 최적화 기법임.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 LLM의 성능 향상을 위한 test-time compute 확장이 주로 생성된 토큰 길이를 늘리는 방향으로 치중되어, 레이턴시와 메모리 비용을 증대시키는 문제를 해결하고자 한다. 기존의 non-looped 모델들은 고정된 계산량으로 다양한 복잡도의 과업을 처리해야 하므로, 복잡한 과업에 대해서는 자원 효율성이 떨어지는 한계가 있다. 저자들은 latent space에서 반복 계산을 수행하여 모델 파라미터 증가 없이 계산 성능을 확장하는 looped language model, Dory1.0-4B를 제안한다 [Figure 2].
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 nGPT 아키텍처를 기반으로 16층의 input block, 40층의 recurrent block, 16층의 output block으로 구성된 모델을 제안한다. recurrent block은 inference 시 반복 횟수 $k$에 따라 $k$번 재사용되며, 학습 단계에서는 NVFP4 포맷을 활용하고 이후 장문 맥락(256K context length) 확장을 거쳤다 [Figure 3]. 또한 RLVR 과정에서 difficulty-aware loop curriculum을 도입하여, 모델이 어려운 과업일수록 더 깊은 loop를 수행하도록 유도하였다 [Figure 4]. 실험 결과, Dory1.0-4B는 두 개 이상의 loop를 사용할 경우 Qwen3.5-9B, Gemma 4 12B 등의 더 큰 모델들을 능가하는 성능을 보였다 [Table 2]. 특히 4개의 loop 사용 시, agentic 과업에서 1개의 loop 대비 output token 수를 1.3~2.5배 감소시키는 높은 토큰 효율성을 입증하였다 [Figure 1]. 또한, Last-loop KV caching 기법을 통해 loop 횟수가 증가해도 메모리 사용량을 1개 loop 수준으로 유지하면서 성능 이득의 대부분을 보존하였다.
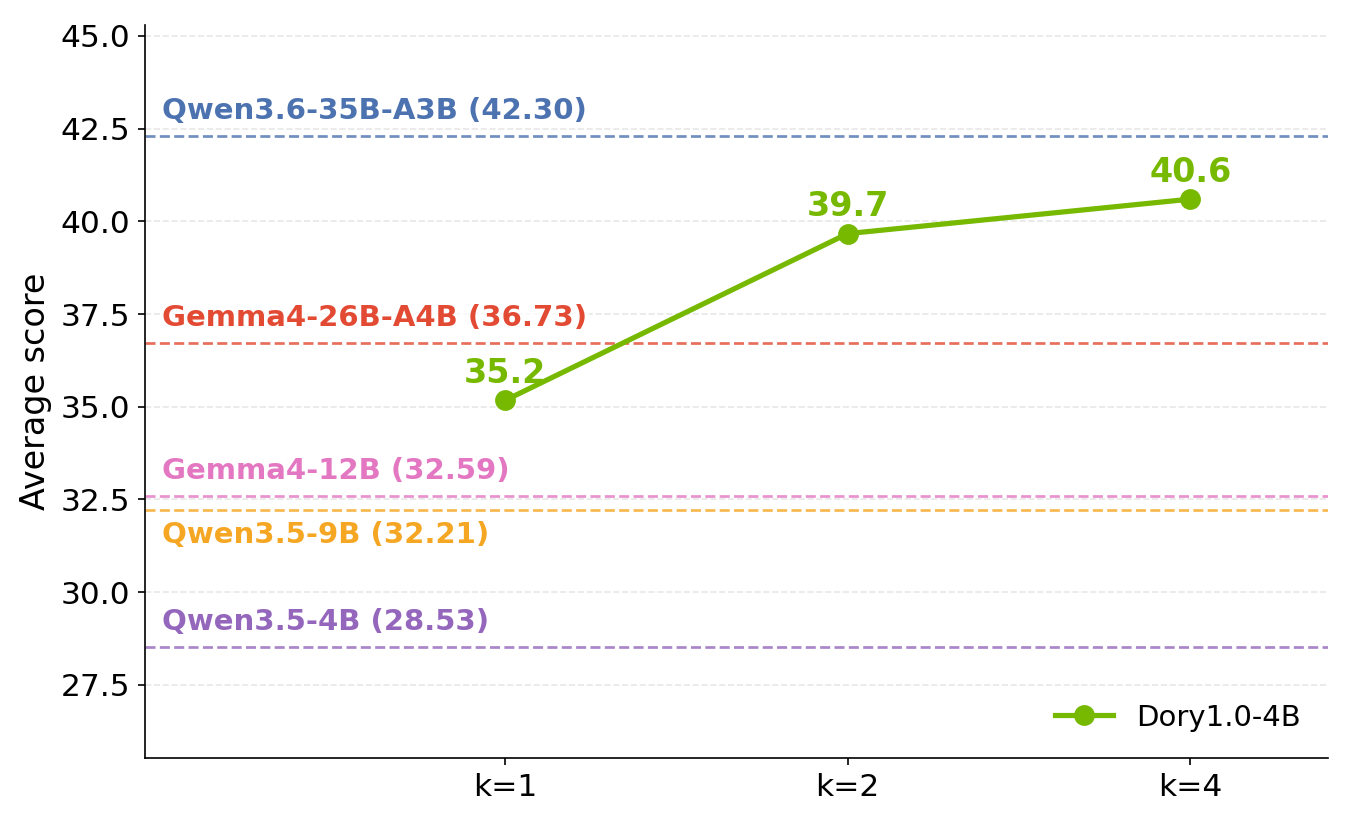
Figure 1 — 루프 횟수에 따른 성능 및 토큰 효율성
4. Conclusion & Impact (결론 및 시사점)
본 논문은 반복적인 latent 연산을 통해 파라미터 수 증가 없이 추론 효율성과 성능을 동시에 달성할 수 있음을 입증하였다. 특히, 동적인 컴퓨팅 자원 할당이 가능한 Dory1.0-4B는 자원이 제한된 환경에서도 고성능의 agentic 및 reasoning 능력을 요구하는 애플리케이션에 적합한 솔루션을 제공한다. 본 연구는 대규모 모델 파라미터에 의존하지 않고 test-time compute의 전략적 활용을 통해 모델의 범용성을 극대화할 수 있는 새로운 이정표를 제시하였다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] FLAMIA: FLAsh MIcroscaling Attention for Fast and Causally Safe Training on Blackwell
- [논문리뷰] SoloQ: Calibration-Free Quantization for Diffusion Language Models
- [논문리뷰] Studying Without a Syllabus: Task-Agnostic Environment Preprocessing
- [논문리뷰] What Else Needs Fixing? Exploring Cost-Effective Test-Time Compute for Revision Propagation in Artifacts Generated Through Conversation
- [논문리뷰] Why Gated DeltaNet Survives 4-Bit Quantization: NVFP4 W4A4 for the Recurrent Half of a Hybrid 27B LLM
Review 의 다른글
- 이전글 [논문리뷰] Do We Need an LLM to Know Why Sources Conflict? Decision Models for Knowledge-Conflict Typing in RAG
- 현재글 : [논문리뷰] Dory1.0-4B: A Looped Normalized-GPT
- 다음글 [논문리뷰] DreamX: Video Diffusion Model is a Universal Latent Action Learner
댓글