[논문리뷰] Factorized MLLM Embeddings for Composed Image Retrieval
링크: 논문 PDF로 바로 열기
저자: WonJun Moon, Seongchan Kim, Dahun Kim, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Composed Image Retrieval (CIR): 레퍼런스 이미지(reference image)와 수정 텍스트(modification text)가 주어졌을 때, 해당 수정 사항이 반영된 타겟 이미지(target image)를 갤러리(gallery)에서 검색하는 태스크.
- Multimodal Large Language Models (MLLMs): 시각(visual) 및 언어(linguistic) 정보를 통합적으로 이해하고 생성할 수 있는 대규모 언어 모델.
- Factorized Latents: MLLM 입력 시퀀스에 추가되는 학습 가능한 토큰(learnable tokens) 세트로, 복합 쿼리(composed query)를 구조화된 구성 요소(compositional components)로 분해하는 정보 병목(information bottlenecks) 역할을 한다.
- Target Imagination: Factorized Latents가 경량 디코더(lightweight decoder)를 통해 타겟 이미지의 패치 피처(patch features)를 재구성하도록 훈련하는 과정. 이는 모델이 텍스트 명령에 따른 시각적 수정을 시뮬레이션(simulate)하도록 돕는다.
- InfoNCE: Contrastive learning에 사용되는 목적 함수로, 긍정적인 샘플 페어(positive sample pairs)의 유사도를 높이고 부정적인 샘플 페어(negative sample pairs)의 유사도를 낮추는 데 활용된다. 본 논문에서는 Factor-level과 Instance-level 두 가지로 적용된다.
- Optimal Transport (OT): 두 개의 분포 간의 최소 이동 비용을 계산하는 수학적 프레임워크로, 여기서는 Factorized Latents 간의 유연한 요소-대-요소 대응(factor-to-factor correspondences)을 정의하는 데 사용된다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
기존 Composed Image Retrieval (CIR) 연구에서 Multimodal Large Language Models (MLLMs)는 강력한 성능을 보여주었지만, MLLM의 내재된 구성적 이해(compositional understanding) 능력이 충분히 활용되지 못하는 한계가 있었다. 특히, 기존 방식들은 참조 이미지와 수정 텍스트로 구성된 복합 쿼리(composed query)를 단일 임베딩(single embedding)으로 직접 매핑(direct mapping)함으로써, 의도된 시각적 수정(intended visual modifications)을 명시적으로 해결하지 못하고 식별적인 임베딩(discriminative embedding)을 형성하는 데에만 집중했다. 이는 MLLM이 쿼리 내의 수정될 시각적 속성(visual attributes)과 보존될 속성을 명확히 분리(disentangle)하고, 요청된 편집을 먼저 시뮬레이션(simulate)한 후 검색 임베딩을 구성하도록 하는 명시적인 메커니즘이 부재했기 때문이다. 따라서 본 연구는 쿼리 이해(query comprehension)와 식별적 임베딩 학습(discriminative embedding learning)을 분리하여, 모델이 먼저 요청된 편집을 상상(imagine)한 후 이를 기반으로 검색 임베딩을 구축하는 새로운 접근 방식의 필요성을 제기한다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 MLLM의 구성적 이해 능력을 효과적으로 활용하기 위해 Factorized MLLM Embeddings (FactEmbed)를 제안한다. FactEmbed는 복합 쿼리 이해를 식별적인 임베딩 구축과 분리하며, 이를 위해 학습 가능한 Factorized Latents를 도입한다 [Figure 1]. 이 Latents는 중간 타겟 상상(target imagination) 목표를 통해 의도된 시각적 수정을 시뮬레이션하도록 훈련되며, 이를 통해 Latents가 검색을 위한 식별적 표현을 형성하기 전에 타겟 의미론(target semantics)에 기반하도록 유도한다. 구체적으로, FactEmbed는 MLLM의 중간 레이어에 경량 디코더(lightweight decoder)를 연결하여, Latents가 coarse layout prior를 넘어 타겟 이미지의 미세한 패치 피처(fine-grained patch features)를 재구성하도록 학습한다 [Figure 3]. 이 Target Imagination Loss ($\mathcal{L}_{\mathrm{imag}}$)는 Latents가 타겟 이미지의 공간적으로 일관된 영역(spatially coherent regions)에 특화되도록 강제한다.
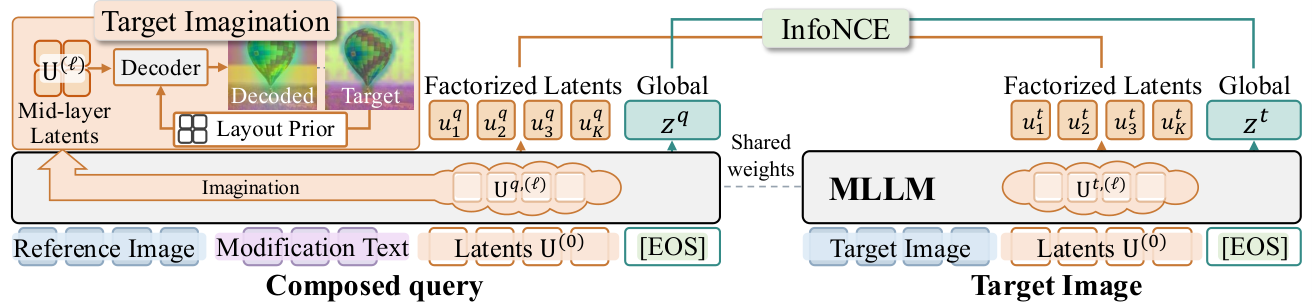
Figure 1 — FactEmbed 개요
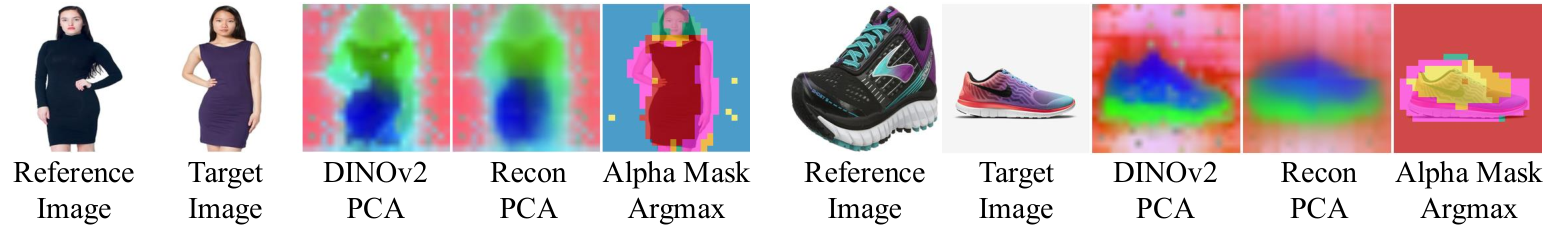
Figure 3 — Target Imagination 정성 분석
검색(retrieval)을 위해, Factor-level InfoNCE ($\mathcal{C}(\mathbf{S}^{f})$) 손실을 Factorized Latents에 직접 적용하여, Optimal Transport (OT)를 통해 쿼리와 타겟 Latents 간의 유연한 요소-대-요소 대응을 보장한다. 동시에, [EOS] 토큰에서 추출된 Global Embedding $z$에 Instance-level InfoNCE ($\mathcal{C}(\mathbf{S}^{g})$) 손실을 적용하여 효율적인 대규모 검색을 지원한다. 또한, 디코더의 Factorized Representation을 MLLM의 더 깊은 어텐션 레이어(attention layer)로 전파하기 위해 Spatial Distillation Loss ($\mathcal{L}_{\mathrm{distill}}$)를 활용한다.
실험 결과, FactEmbed는 Refined-CIRR 및 Refined-FashionIQ 벤치마크에서 기존 SOTA(state-of-the-art) 모델들을 능가하는 성능을 달성했다 [Table 1]. 특히, Refined-CIRR에서 Recall@1 지표에서 2.7% (CSMCIR 대비) 및 2.3% (ReCALL 대비) 향상을 보였고 [Table 1], Refined-FashionIQ에서는 평균 Recall@10 지표에서 각각 2.3% 및 2.4% 향상을 달성했다 [Table 1]. 또한, 효율적인 재랭킹(efficient reranking) 전략을 통해 [EOS] 토큰을 이용한 초기 검색과 평균 풀링된 Latents를 이용한 상위 후보 리스트 재랭킹을 결합하여, 전체 Factor Matching에 필적하는 성능을 달성하면서도 메모리 및 계산 오버헤드를 최소화했다 [Table 4]. 예를 들어, CIRR 테스트 세트에서 Full Factor 방식은 R@1이 56.84였으나, Efficient Rerank 방식은 56.60으로 근접한 성능을 보였다 [Table 4]. 이는 FactEmbed가 복합 쿼리 이해를 위한 미세한(fine-grained) 시맨틱 표현(semantic representations)을 명시적으로 장려함으로써, 표준 Contrastive Architecture로는 얻기 어려운 이점을 제공함을 시사한다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 Composed Image Retrieval (CIR)에서 Multimodal Large Language Models (MLLMs)의 구성적 이해 능력을 효과적으로 활용하기 위한 FactEmbed 프레임워크를 제안한다. FactEmbed는 Factorized Latents와 Target Imagination이라는 개념을 통해 복합 쿼리 이해와 식별적인 임베딩 학습 과정을 성공적으로 분리한다 [Figure 1]. 이를 통해 MLLM이 텍스트 명령에 따른 시각적 수정을 '상상'하고, 이를 기반으로 더욱 미세하고 구조화된 검색 임베딩을 생성할 수 있도록 유도한다. Factor-level InfoNCE와 Attention Distillation 같은 보조 손실 함수는 Latents가 시각적으로 일관된 요소에 특화되도록 하며, Instance-level InfoNCE는 효율적인 대규모 검색을 보장한다. FactEmbed의 주요 시사점은 Factor-level의 명시적인 supervisory signal이 Instance-level matching만 사용하는 기존 방식보다 MLLM 기반 CIR의 성능을 크게 향상시킬 수 있다는 점이다. 이는 특히 미묘한 시각적 속성 수정이나 부정적 제약(negative constraints)이 포함된 쿼리에서 MLLM의 compositional reasoning 능력을 강화하여, 더 정확하고 섬세한 이미지 검색 결과를 가능하게 한다 [Figure 8]. 이 연구는 학계에서 MLLM의 내부 작동 방식을 이해하고 제어하는 새로운 방향을 제시하며, 산업계에서는 보다 정교하고 사용자 의도에 부합하는 시각 검색 시스템 개발에 기여할 잠재력을 가진다.
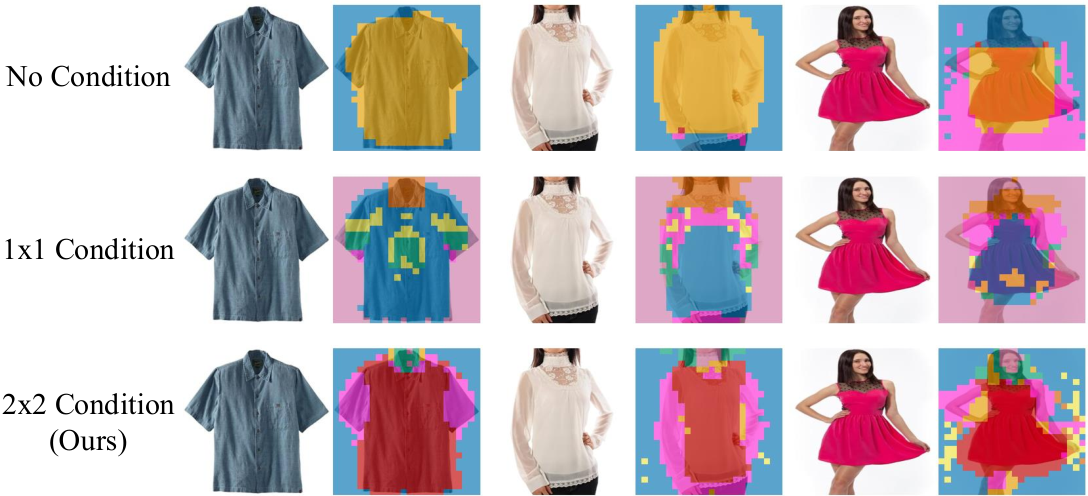
Figure 4 — Layout Prior 영향 분석
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] OpenVLThinkerV2: A Generalist Multimodal Reasoning Model for Multi-domain Visual Tasks
- [논문리뷰] From Fragmentation to Fusion: A Survey and Roadmap for Omnimodal Embeddings
- [논문리뷰] SOMA: A Benchmark for Fine-Grained Egocentric Behavior and Body-Motion Understanding
- [논문리뷰] AskStream: When and What to Ask Proactively under Uncertainty in Streaming Video Understanding
- [논문리뷰] A Broader Look into MLLM's Retrieval Heads
Review 의 다른글
- 이전글 [논문리뷰] EvoTeam: Multi-Agent Collaboration via Evolving Teams
- 현재글 : [논문리뷰] Factorized MLLM Embeddings for Composed Image Retrieval
- 다음글 [논문리뷰] FlowTranslator: Training-Free In-Image Machine Translation with Flow-Based Editing
댓글