[논문리뷰] AskStream: When and What to Ask Proactively under Uncertainty in Streaming Video Understanding
링크: 논문 PDF로 바로 열기
저자: Lu Wang, Zhuoran Jin, Longxiang Wang, Junhong Chen, Yupu Hao, Yao Xu, Daojian Zeng, Yubo Chen, Kang Liu, Guang Liu, Jun Zhao
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- AskStream: 비디오 스트리밍 환경에서 정보 불확실성이 발생할 때 모델이 능동적으로 질문을 던지는 능력을 평가하기 위해 제안된 최초의 Multi-turn 벤치마크입니다.
- Proactive Paradigm: 기존의 수동적인 응답 방식에서 벗어나, 모델이 영상 스트림을 모니터링하며 'Wait', 'Ask', 'Answer' 중 최적의 행동을 스스로 결정하는 상호작용 프레임워크입니다.
- Ask-F1: 모델이 질문(ASK)과 답변(ANSWER)을 수행하는 시점의 정확성과 내용의 정합성을 통합적으로 측정하기 위해 제안된 성능 지표입니다.
- StreamHarness: 비디오 스트리밍 환경에서 효율적인 컨텍스트 유지를 위해, 최근 프레임은 고해상도로 유지하고 이전 프레임은 계층적으로 압축하여 메모리에 저장하는 프레임워크입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 기존의 Streaming Video Understanding 연구들은 모델이 관찰된 정보 내에서만 'Wait'하거나 'Answer'하는 것을 가정했기 때문에, 실제 환경에서 발생하는 정보 부족(Incompleteness)이나 불확실성 상황에서 한계를 보입니다. 이러한 불완전한 정보는 모델이 영원히 대기하게 하거나, Hallucination이 포함된 부정확한 답변을 생성하게 만드는 원인이 됩니다. 저자들은 모델이 불확실성을 인지했을 때 누락된 정보를 능동적으로 요청하는 'Ask' 액션의 필요성을 제기하며, 이를 반영한 새로운 상호작용 패러다임의 필요성을 강조합니다 [Figure 1].
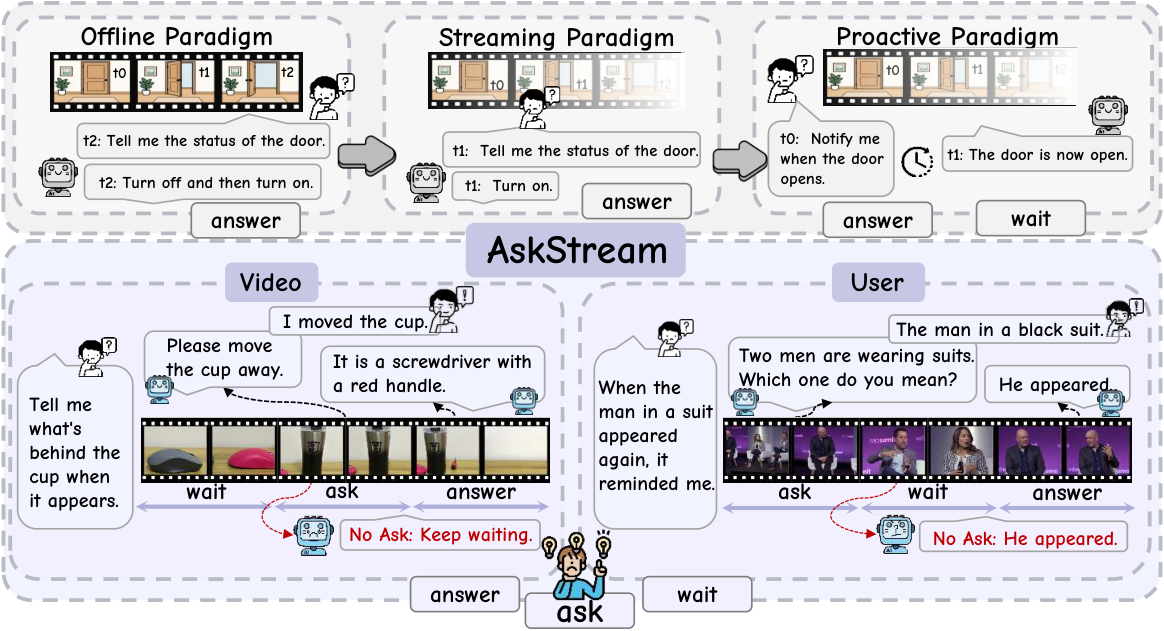
Figure 1 — 상호작용 패러다임의 진화
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 저자들은 영상의 시각적 불확실성과 사용자의 의도적 불확실성을 포함하는 8개의 Subtask로 구성된 AskStream 벤치마크를 구축하였습니다 [Figure 3]. 모델은 POMDP(Partially Observable Markov Decision Process) 기반의 의사결정을 수행하며, StreamHarness를 통해 장기 기억을 보존합니다. 실험 결과, 최신 모델들도 Proactive 정보 탐색 능력에서 큰 한계를 보였습니다. 구체적으로, 최상위 Offline 모델이 Ask-F1 52.18%를 기록한 반면, 최고의 Streaming Proactive 모델은 7.22%에 그쳤습니다 [Table 2]. 분석 결과, '언제 질문할지(When)'를 결정하는 능력이 가장 큰 병목 현상으로 확인되었으며, Oracle 정보를 제공하여 해당 결정을 보조할 경우 Ask-F1 성능이 43.83% 향상됨을 입증하였습니다 [Figure 6].
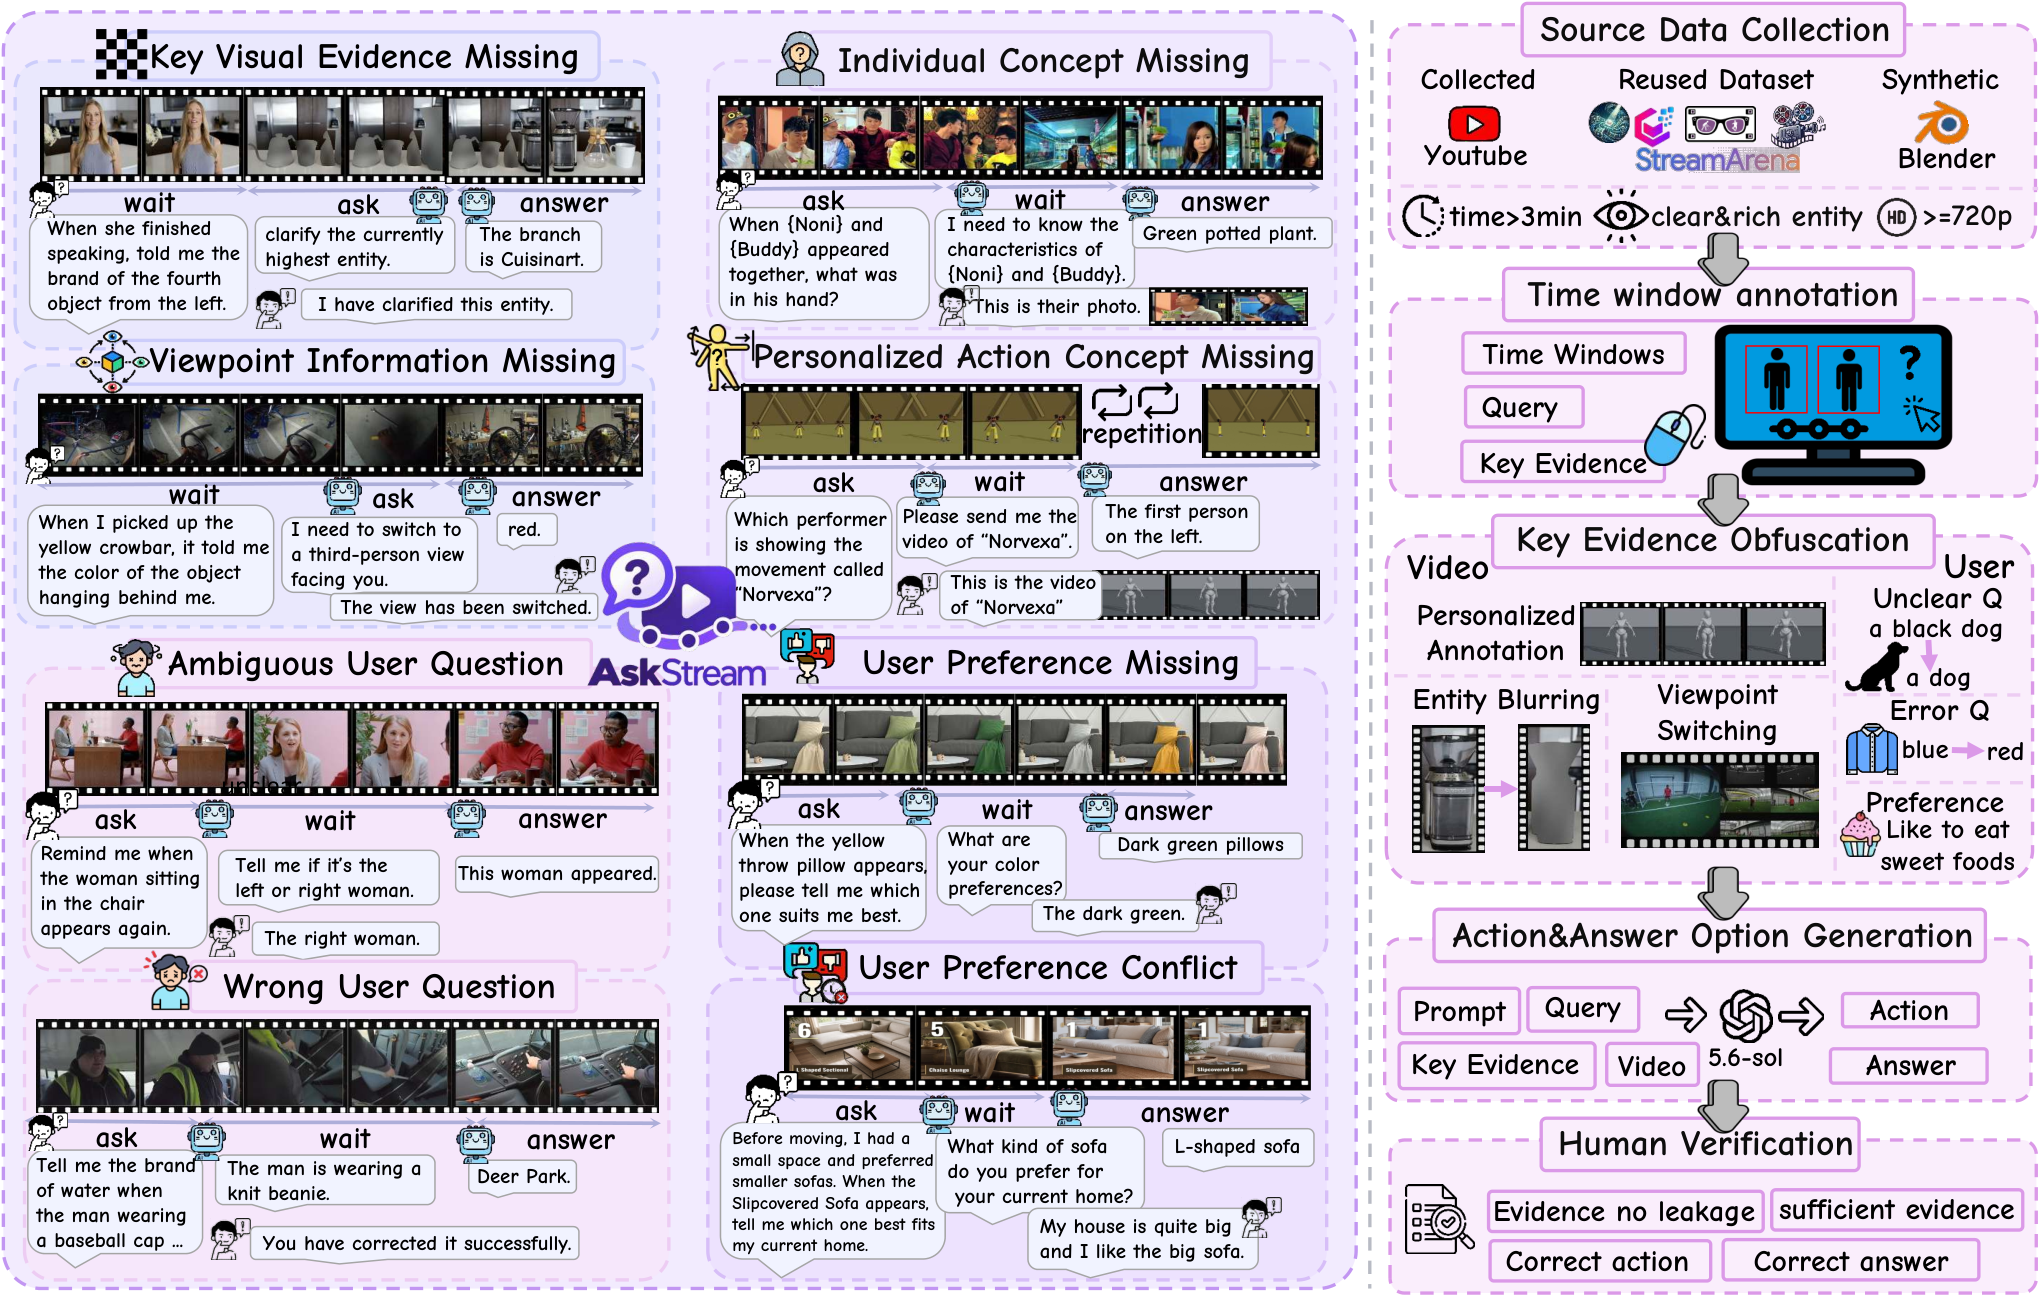
Figure 3 — AskStream 태스크 분류 및 구성
## 4. Conclusion & Impact (결론 및 시사점) 본 연구는 영상 이해 분야에서 'Ask' 액션을 포함한 새로운 Proactive 상호작용 패러다임을 정립하고, 이를 평가할 수 있는 최초의 종합적 벤치마크를 제공합니다. 연구 결과는 현재의 MLLM이 능동적인 정보 획득 능력에서 상당한 개선이 필요함을 시사합니다. 향후 본 벤치마크는 더욱 지능적이고 적응형인 실시간 영상 보조 시스템 및 복잡한 시나리오에서의 비디오 에이전트 개발을 위한 핵심 지표로 활용될 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Omni-DuplexEval: Evaluating Real-time Duplex Omni-modal Interaction
- [논문리뷰] InteractiveWorld: A Verifiable Human-Centric Environment for Building Better Interactive MLLM Assistants
- [논문리뷰] Humans in Space: Can MLLMs Construct Human-Centric Spatial Understanding via Active Exocentric Exploration?
- [논문리뷰] BlenderWorld: Benchmarking Visual Agents for 3D Creation from Real-World References
- [논문리뷰] OmniCapBench: A Deep-Structured Evaluation Framework for Fine-Grained Audio-Visual Captioning
Review 의 다른글
- 이전글 [논문리뷰] After One-Click Video: The Inflow of Service-Type Content, the Failure of the Recommendation Pool Mechanism, and the BoLe System
- 현재글 : [논문리뷰] AskStream: When and What to Ask Proactively under Uncertainty in Streaming Video Understanding
- 다음글 [논문리뷰] Broken on Arrival: Non-Functional Quantized LLM Artifacts in Public Model Registries and How to Catch Them
댓글