[논문리뷰] OmniCapBench: A Deep-Structured Evaluation Framework for Fine-Grained Audio-Visual Captioning
링크: 논문 PDF로 바로 열기
메타데이터
저자: Zhongyu Yang, Jiale Tao, Ruitao Chen, Zuhao Yang, Yingfang Yuan, Xueliang Zhao, Auden, Kai Wang, Shuai Shao, Biao Wang, Steve Yves, Qinglin Lu
1. Key Terms & Definitions (핵심 용어 및 정의)
- OmniCapBench: 오디오-비주얼 캡셔닝 모델을 평가하기 위해 제안된 Deep-Structured 진단 프레임워크이자 벤치마크.
- Atomic Units: 캡션을 구성하는 최소 단위(References, Events, Shots)로, 결정론적 검증 및 국소적 의미 비교가 가능한 평가 타겟.
- Native Track: 엔티티 식별(Reference), 오디오 이벤트 추출(Event), 시각적 샷 분할(Shot)로 구성된 세 가지 구조적 평가 경로.
- LLM-as-Judge (Global/Local): 자유 형식의 텍스트 전체를 평가하는 기존 방식(Global)과 달리, 특정 데이터 단위에 대해서만 의미적 일치 여부를 판단하는 제한된 평가 방식(Local).
- Structural Integrity: 모델이 생성한 출력이 사전에 정의된 스키마(ID 일관성, 타임스탬프 범위 등)를 충족하는지 여부.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존의 오디오-비주얼 캡셔닝 평가 방식이 전체 캡션 점수에 의존하여 세부적인 모델 결함을 진단하는 데 한계가 있다는 문제를 해결한다. 현재의 홀리스틱(Holistic) 평가 방식은 텍스트 전체를 하나의 단위로 처리하여 로컬 오류(Local Error)를 은폐하며, 프로브(Probe) 기반 방식은 로컬 정보는 제공하나 전반적인 평가 커버리지가 부족하다는 단점이 있다 [Figure 1]. 또한, 범용 LLM을 평가자로 사용하는 방식은 언어적 스타일이나 환각(Hallucination)에 의한 불확실성을 가중시킨다. 따라서 본 연구는 이러한 평가의 불투명성을 극복하고 정교한 진단이 가능한 프레임워크의 필요성을 제기한다.
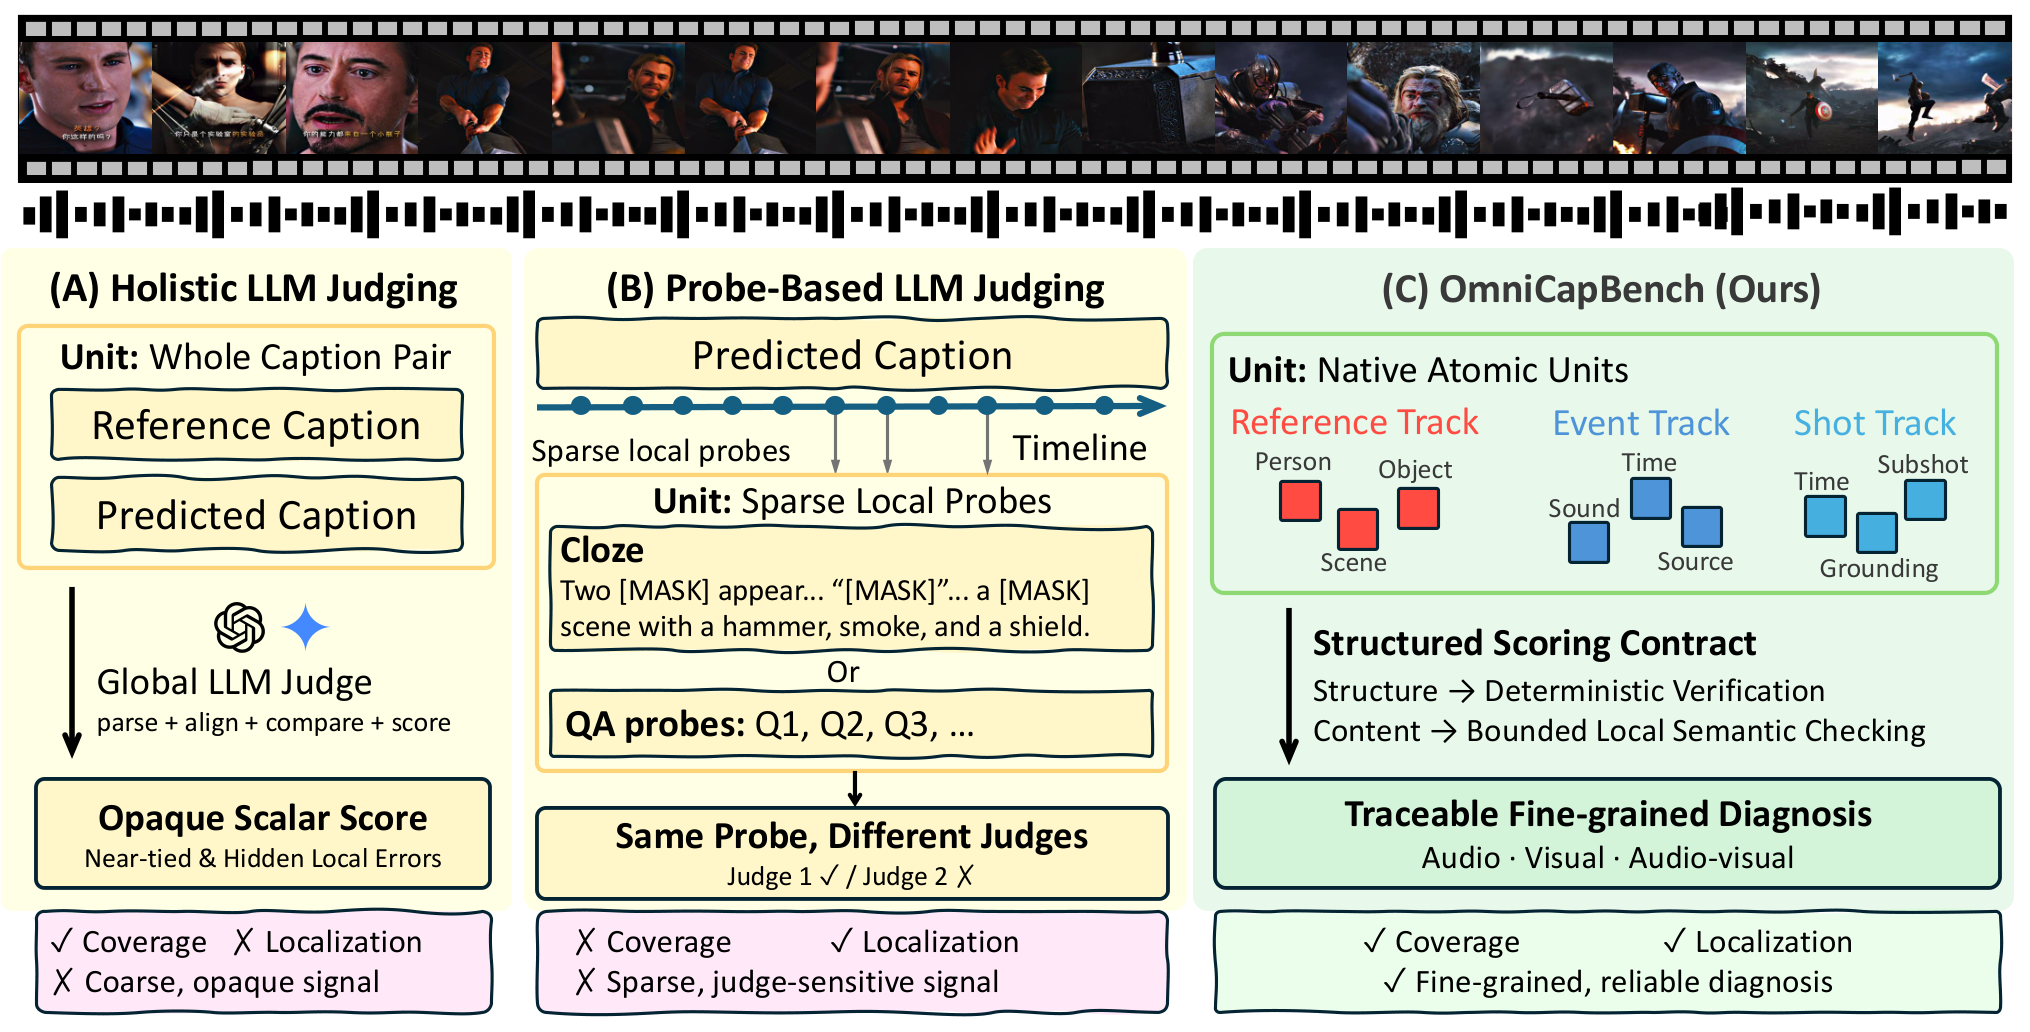
Figure 1 — 기존 평가 방식과 OmniCapBench의 비교
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 오디오-비주얼 캡셔닝을 atomic, verifiable 단위로 분해하는 Deep-Structured Evaluation Paradigm을 제안한다 [Figure 1, Figure 2]. 이 방법론은 3단계 데이터 생성 파이프라인(Candidate Curation, Native Track Construction, Quality Audit)을 거쳐 총 786개의 동영상 데이터셋을 구축한다. 평가 과정에서는 결정론적 규칙(Deterministic Rules)을 통해 structural integrity를 먼저 확인하고, 통과된 단위에 한하여 국소적 LLM(Localized LLM)이 의미적 유사성을 비교하는 'Structure-first, Semantics-second' 원칙을 적용한다. 실험 결과, Gemini 3.1-Pro는 SGC(Structural Generation Capability)에서 97.36을 기록하며 최상위 수준의 구조적 준수 능력을 보였다 [Table 3]. 또한 Gemini 3.1-Pro는 EVSA(Event-Visual Shot Association) F1 점수에서 51.46을 기록하여 다른 모델 대비 오디오-비주얼 연관성 판단에서 상대적 우위를 점했으나, 전반적인 장기 오디오-비주얼 추론 능력에는 여전히 개선의 여지가 있음을 확인하였다 [Table 3]. 모든 실험은 Recall(생략 방지)과 Precision(환각 방지)의 균형을 맞춘 Bidirectional Matching 기법을 통해 평가되었다 [Table 4].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 오디오-비주얼 캡셔닝 모델을 위한 최초의 심층 구조적 평가 프레임워크인 OmniCapBench를 도입하였다. 이 연구는 기존의 불투명한 홀리스틱 평가 패러다임을 탈피하여, 구조적 결함과 의미적 오류를 명확히 구분할 수 있는 진단 지표를 제공한다. OmniCapBench는 향후 연구자들이 MLLM의 특정 인식 오류(temporal grounding, identity drift 등)를 타겟팅하여 모델을 개선할 수 있는 정교한 로드맵을 제시하며, 학계 및 산업계의 omnimodal 연구 수준을 한 단계 높이는 데 기여할 것으로 기대된다.
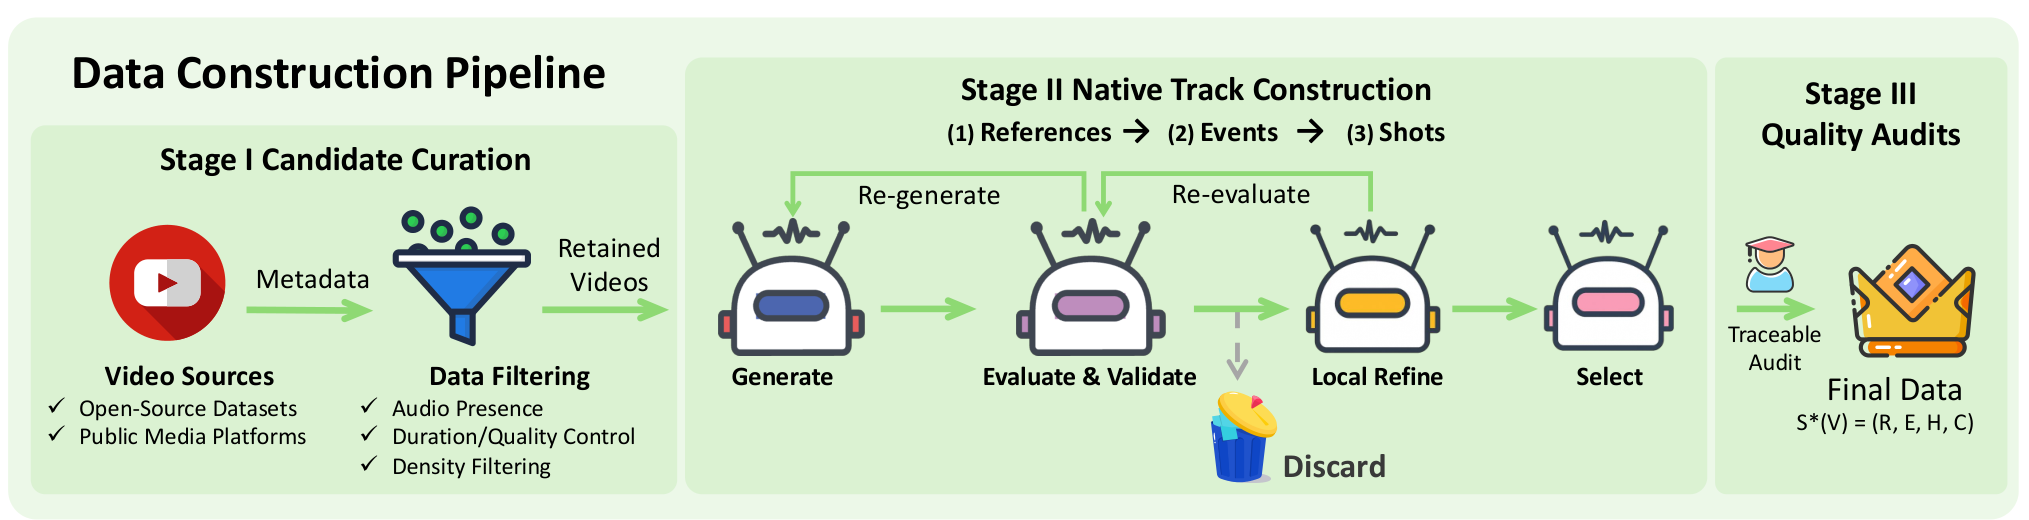
Figure 2 — OmniCapBench 데이터 구축 파이프라인
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Evaluating Multimodal LLMs as Generalist Vision-Language-Action Agents for Drone Control: Commanding, Approaching, Tracking and Searching
- [논문리뷰] Video-IFBench: Evaluating Instruction Following of Multimodal LLMs in Video Understanding Scenarios
- [논문리뷰] NARU: A Benchmark for NARrative Evolution and Cultural Nuance Understanding in Japanese Extreme Long Video
- [논문리뷰] VideoGAIA: A Benchmark for General AI Assistants on Agentic Video Understanding
- [논문리뷰] MMOOC: A Comprehensive Benchmark for Out-of-Context Evaluation in Multimodal Large Language Models
Review 의 다른글
- 이전글 [논문리뷰] Multi-Agent Egocentric World Model with Fine-Grained Embodied Interaction
- 현재글 : [논문리뷰] OmniCapBench: A Deep-Structured Evaluation Framework for Fine-Grained Audio-Visual Captioning
- 다음글 [논문리뷰] One Block, Multiple Depths: Recurrent Vision Transformers with Depth-Programmed Experts
댓글