[논문리뷰] Think Less, Locally: Local Preference Learning for Reasoning Compression
링크: 논문 PDF로 바로 열기
메타데이터
저자: Muyao Yuan, Liyan Xu, Weizhan Zhang, Muyan Jiao, Jiangnan Li, Jinchao Zhang, Jie Zhou
1. Key Terms & Definitions (핵심 용어 및 정의)
- Overthinking: 모델이 이미 충분한 정보를 획득했음에도 불구하고 불필요하게 긴 Chain-of-Thought를 지속하는 현상.
- LoCo (Local Compression): reasoning state에 기반하여 불필요한 추론을 탐지하고, 상태 조건부 선호 학습을 통해 효율적인 추론을 유도하는 프레임워크.
- Reasoning State ($P_i$): 주어진 문제와 현재까지 생성된 reasoning step들의 결합으로 정의되는, 모델이 추론을 지속할지 종료할지 결정하는 로컬 결정 지점.
- DPO (Direct Preference Optimization): 모델의 reasoning policy를 정렬하기 위해, 동일한 $P_i$에서 파생된 짧은 정답 continuation과 긴 원래 continuation 간의 선호도를 학습하는 방법론.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 Large Reasoning Models (LRMs)의 긴 Chain-of-Thought가 불필요한 추론을 포함하여 추론 지연 시간과 메모리 비용을 증대시키는 문제를 해결하고자 한다. 기존의 Trajectory-Level Compression 방식은 전체적인 길이를 줄이는 데는 효과적이나, 추론 과정 중 어느 시점에서 추론을 멈춰야 하는지에 대한 국소적인 판단을 제공하지 못하는 한계가 있다. 저자들은 추론이 단계별 상태 전이로 이루어진다는 점에 착안하여, 상태별로 추론 지속 여부를 결정하는 새로운 접근 방식이 필요함을 강조한다 [Figure 1].
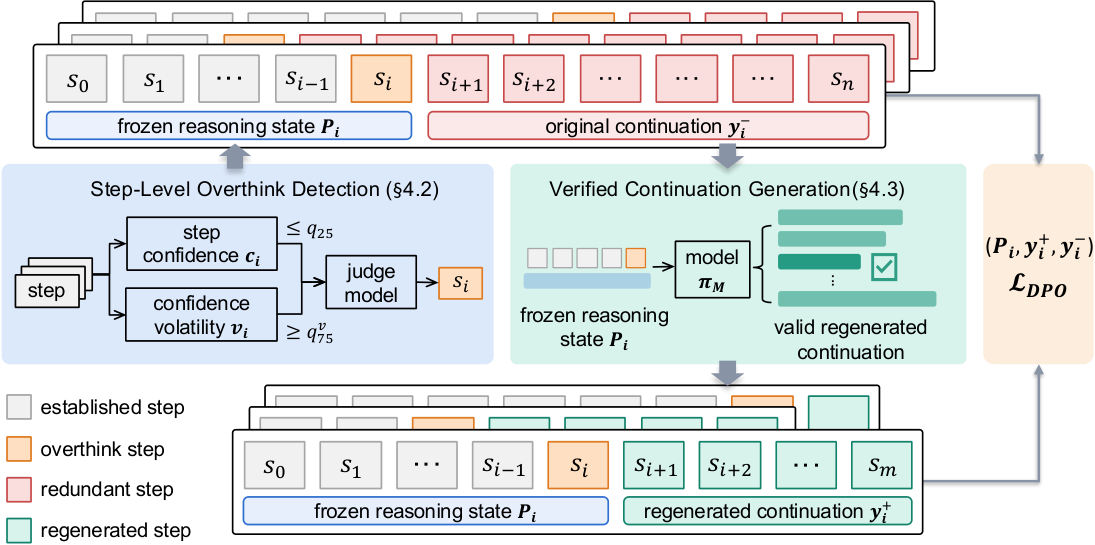
Figure 1 — LoCo 파이프라인 전체 아키텍처
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 LoCo라는 로컬 선호 학습 프레임워크를 제안하여, 모델 스스로 생성한 추론 트레이스에서 과잉 사고(overthinking) 상태를 탐지하고 최적화한다 [Figure 1]. 방법론은 크게 Step-Level Overthink Detection, Verified Continuation Generation, Local Preference Learning의 3단계로 구성된다. 모델의 확신도(confidence)와 변동성(volatility)을 기반으로 후보 상태를 스크리닝하고, 강력한 Judge 모델을 통해 이를 검증한 뒤, 동일한 상태에서 더 짧고 정확한 continuation을 생성하여 DPO로 학습시킨다. 실험 결과, LoCo는 수학적 추론 벤치마크에서 기존 모델 대비 41.7%~45.4%의 토큰 감소를 달성하면서도 정확도를 유지하거나 향상시켰다. 특히 코드 생성 작업에서도 별도의 태스크 특화 학습 없이 23.4%~36.3%의 토큰 감소와 함께 AUC 성능 개선을 보여주며 도메인 간 일반화 능력을 입증했다 [Table 1, Table 2].
4. Conclusion & Impact (결론 및 시사점)
본 연구는 reasoning compression을 단순한 경로 길이 단축이 아닌, 상태 인식 기반의 continue-or-conclude 선호 학습으로 재정의하였다. LoCo는 모델의 내재적 추론 분포를 활용하여 효율적인 추론 행동을 성공적으로 학습시켰으며, 수학과 코드 생성이라는 서로 다른 도메인에서 일관된 성능 향상을 입증했다. 이 연구는 LRM의 추론 비용을 획기적으로 절감하면서도 복잡한 문제 해결 능력을 보존하는 핵심적인 프레임워크를 제공하여, 향후 대규모 추론 모델의 실용적인 배포와 효율화에 크게 기여할 것으로 기대된다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Learning Adaptive Reasoning Paths for Efficient Visual Reasoning
- [논문리뷰] MixReasoning: Switching Modes to Think
- [논문리뷰] BeaconKV: Key-Value Cache Compression Guided by Beacon Queries for Efficient Large Reasoning Model Inference
- [논문리뷰] ReasoningLens: Hierarchical Visualization and Diagnostic Auditing for Large Reasoning Models
- [논문리뷰] An Enigma of Artificial Reason: Investigating the Production-Evaluation Gap in Large Reasoning Models
Review 의 다른글
- 이전글 [논문리뷰] Switch-SWE: Do Coding Agents Hold Focus When Switching Between Unfinished Tasks?
- 현재글 : [논문리뷰] Think Less, Locally: Local Preference Learning for Reasoning Compression
- 다음글 [논문리뷰] ToolSpace: Scaling Tool-Centric Environment Synthesis for Long-Horizon Agents
댓글