[논문리뷰] StreamDuo: A Live Commentator and a Research Agent for Unseen Games
링크: 논문 PDF로 바로 열기
저자: Zixian Gao, Penghao Luo, Xiangcheng Cao, Lixin Xiu, Ziqi Cai, Zhen Li, Erwin Wu, Kaipeng Zhang
1. Key Terms & Definitions (핵심 용어 및 정의)
- Cross-Game Streaming Commentary: 저자들이 새로 정의한 문제 설정입니다. 모델을 하나의 source game(Baldur's Gate 3)으로만 학습시킨 뒤, 학습에서 본 적 없는 unseen game들에서 실시간 해설을 생성하게 합니다.
- Research Agent: Frozen 상태의 vision-language model(Qwen3-VL-8B)입니다. 현재 플레이 중인 게임의 wiki를 BM25 search tool로 검색할 수 있습니다. Commentator가 보낸 frame을 직접 보고 search key를 만든 뒤, 최대 3개의 wiki entry(name, type, one-line description)를 반환합니다.
- Information-Gain Ask Label: 질문(ask) 시점을 정하는 supervision입니다. Frozen commentator가 ideal answer A*를 받았을 때와 받지 않았을 때 human caster 발화의 log-likelihood가 얼마나 달라지는지 계산하고, 그 차이가 γ(=1 nat)를 넘으면 δ초 앞선 시점을 ask moment로 labeling합니다.
- OPSD (On-Policy Self-Distillation): Noisy answer를 받는 student commentator가, ideal answer를 받는 자기 자신의 frozen copy(teacher)를 reverse KL로 모방하도록 학습하는 기법입니다. Teacher 쪽에는 context-aware decoding 방식의 amplification(α)을 적용합니다.
- Source-Game Leakage: 모델이 언급한 entity 가운데 학습 게임(Baldur's Gate 3)의 이름이 차지하는 비율입니다. 예를 들어 Tears of the Kingdom 캐릭터를 "Karlach"라고 부르는 경우가 여기에 해당합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
기존 streaming commentator는 게임이 바뀌어도 timing은 transfer되지만 게임 세계에 대한 knowledge는 transfer되지 않습니다. 이 논문이 해결하려는 핵심 문제가 바로 이 점입니다. Proact-VL 등 기존 연구는 같은 게임으로 학습하고 평가했습니다. 그러나 실제 해설에서는 처음 보는 캐릭터와 아이템을 계속 마주치고, 해설을 informative하게 만드는 entity는 게임마다 다릅니다. Baldur's Gate 3로만 학습한 Proact-VL은 unseen game에서 화면 속 entity를 거의 명명하지 못하며, 명명하더라도 학습 게임의 이름을 끌어다 쓰는 경우가 많습니다 [Figure 1].
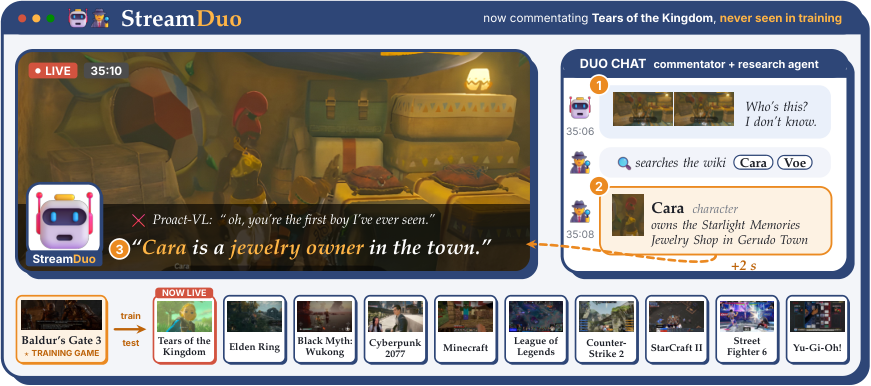
Figure 1 — Unseen game 해설 예시
기존 RAG와 tool-using agent는 live commentary 환경에서 다음과 같은 한계를 보입니다.
- 스트림 시작 전에 미리 검색해 둔 game-level dossier는 지금 이 순간 화면에 무엇이 있는지 알려주지 못합니다.
- 매초 검색하면 context가 넘쳐납니다.
- Text query 방식에서는 모델이 알아보지 못하는 대상을 말로 묘사해야 합니다.
- 이 모델에게 언제 정보가 필요한지 판단하는 메커니즘이 없습니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 학습 가능한 commentator와 frozen research agent로 구성된 two-agent 시스템 StreamDuo를 제안합니다 [Figure 2]. 설계와 학습 방식은 다음과 같습니다.
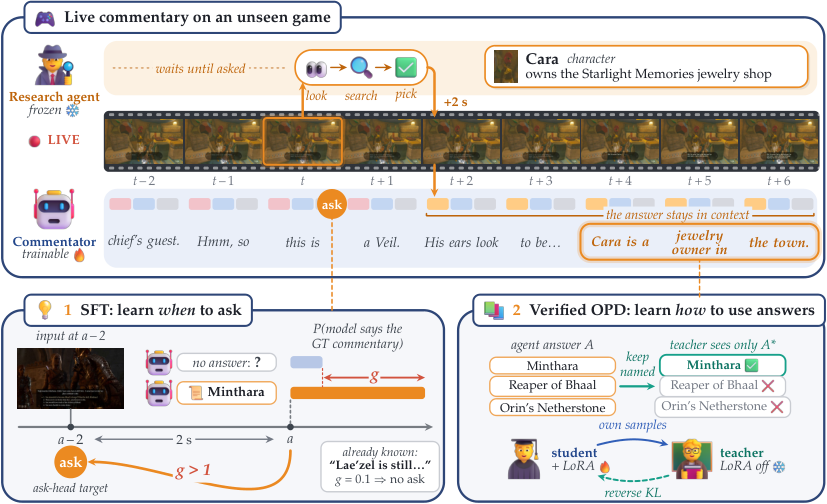
Figure 2 — StreamDuo 전체 구조
- 기본 구조: Commentator는 LiveCC-7B-Base를 기반으로 하며, Proact-VL처럼 매초 flag token의 hidden state에서 speak 확률 p_t를 예측합니다. 여기에 ask 확률 q_t를 출력하는 두 번째 head를 추가했습니다.
- Frame 기반 질문과 비동기 응답: q_t > 0.9이면 text가 아닌 현재 frame을 research agent에 보냅니다. Answer는 δ=2초 뒤에 history로 들어오고, 그동안에도 스트림과 해설은 계속 진행됩니다.
- Speak/stop threshold: 말을 시작하는 threshold(τ)보다 말을 이어가는 threshold(τ_c)를 높게 설정했습니다. 이벤트가 끝나면 장황한 설명을 멈추게 하기 위해서입니다.
- Entity renaming: 학습 중 source game의 entity 이름을 무작위로 일관되게 바꿉니다. 이렇게 하면 모델이 이름을 암기하는 shortcut을 쓸 수 없습니다.
- Stage 1 (when to ask): Information-gain label로 ask head를 학습합니다(full fine-tuning, 1 epoch). 같은 단계에서 distractor가 섞인 answer를 읽는 법도 함께 학습합니다.
- Stage 2 (how to use): Rank-32 LoRA로 OPSD를 300 step 수행합니다. Teacher는 LoRA를 끈 동일 모델이며, ideal answer를 보고 α=1로 amplified된 분포를 제공합니다.
주요 결과 (Baldur's Gate 3로 학습, 10개 unseen game의 2,470 clip으로 평가):
- Main comparison: 같은 데이터로 학습한 Proact-VL과 비교하면, Ent-R는 0.082 → 0.116, K-strict는 0.085 → 0.127로 올랐고, TimeDiff는 1.84 → 1.76s로 줄었습니다. FinalQ는 3.32 → 3.53, LiveU는 4.91 → 5.14로 개선됐습니다. CC를 제외한 모든 지표에서 최고 성능입니다.
- Source-game leakage: Proact-VL은 9.9%(2,011개 중 200개), StreamDuo는 1.0%(3,363개 중 34개)입니다. StreamDuo가 entity를 거의 2배 더 많이 언급하는데도 leakage는 훨씬 낮습니다 [Figure 5].
- Dossier 효과: Baseline에 agent dossier를 추가해도 거의 도움이 되지 않았습니다. 예를 들어 Proact-VL의 K-strict는 +0.003에 그쳤습니다.
- Ablation: Asking을 추가하면 Ent-R가 0.083 → 0.092, OPSD를 추가하면 0.092 → 0.116이 됩니다. OPSD의 기여가 가장 큽니다.
- Ask 정책 비교:
- Naive label(entity가 언급되는 모든 시점에 ask)을 쓰면 Ent-R가 0.079로 떨어집니다.
- 3초마다 질문하면 recall은 0.199로 오르지만 Ent-F1이 0.105로 떨어지고 judge score도 하락합니다.
- Learned policy는 총 264회만 질문하면서 최고 Ent-F1 0.141을 기록합니다.
- Answer 활용 패턴: Answer가 도착한 시점에 entity를 명명하는 비율은 32%로, 무작위 시점(7%)의 4.6배입니다.
- Research agent 교체: Qwen3-VL 2B
30B-A3B로 바꿔도 Ent-R는 0.1010.116 범위에 머뭅니다. 즉 agent 크기는 bottleneck이 아닙니다.
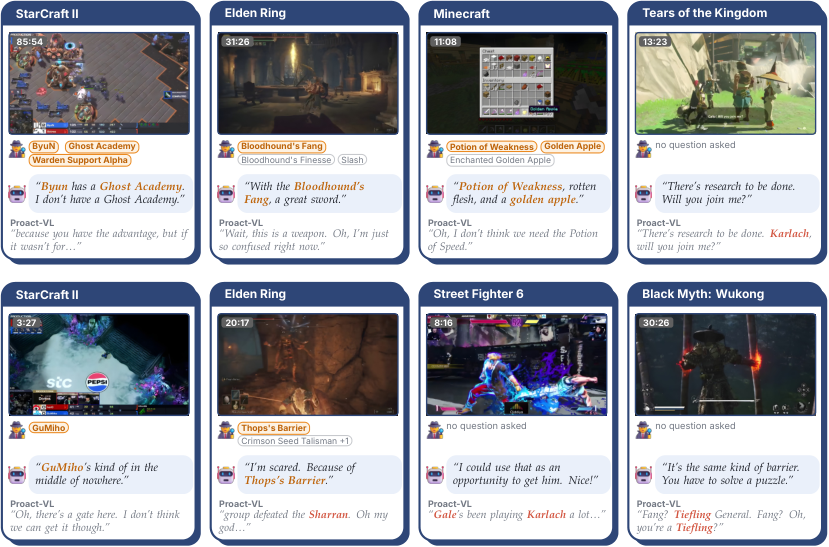
Figure 5 — 정성적 비교 결과
4. Conclusion & Impact (결론 및 시사점)
StreamDuo는 perception과 언어 능력은 commentator에 남기고, game-specific knowledge는 test time에 research agent로 조회하는 역할 분담을 택했습니다. 이 방식으로 학습하지 않은 10개 게임에서도 timing과 quality를 유지하면서 entity knowledge를 크게 높였습니다. 핵심 기여는 두 가지 학습 기법입니다. 하나는 model-dependent한 information-gain label로 "언제 물을지"를 학습시킨 것이고, 다른 하나는 privileged teacher를 활용한 OPSD로 "noisy answer를 어떻게 쓸지"를 학습시킨 것입니다.
이 연구는 다음과 같은 시사점을 가집니다.
- Retrieval 품질보다 활용 능력: Agent 크기를 바꾼 효과보다 Stage 2의 효과가 훨씬 컸습니다. Retrieval-augmented 시스템에서는 검색 품질보다 모델이 답을 활용하는 능력이 더 중요할 수 있다는 점을 보여줍니다.
- 산업적 확장성: Wiki만 있으면 재학습 없이 새 게임에 적용할 수 있으므로, live streaming 자동 해설 분야에서 실용성이 높습니다.
- 평가 프로토콜: Leakage metric과 정보 누출을 제거한 평가 프로토콜은 이후 cross-domain streaming video LLM 연구의 기준으로 쓰일 수 있습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] DirCast: Live Esports Directing and Commentary with a Single Streaming Video-Language Model
- [논문리뷰] What Does Privileged Information Add to On-Policy Self-Distillation?
- [논문리뷰] Visual Contrastive Self-Distillation
- [논문리뷰] One Symptom, Three Levers: A Critical Review of On-Policy Self-Distillation
- [논문리뷰] A Survey of On-Policy Distillation for Large Language Models
Review 의 다른글
- 이전글 [논문리뷰] SpecOPD: Branch-Parallel On-Policy Distillation for Speculative Decoding
- 현재글 : [논문리뷰] StreamDuo: A Live Commentator and a Research Agent for Unseen Games
- 다음글 [논문리뷰] TAC-CoT: Tool-Empowered Implicit Chain-of-Thought via Interleaving Explicit Tokens
댓글