[논문리뷰] VideoMemBench: How Well Do MLLMs Remember in Video Conversations?
링크: 논문 PDF로 바로 열기
저자: Zhengdong Hu, Chao Wang, et al. (Kaituo Feng, Huanjin Yao, Mingfei Lu, Hehe Fan, Yi Yang)
1. Key Terms & Definitions (핵심 용어 및 정의)
- In-Context Video Memory: 하나의 video를 두고 이어지는 multi-turn QA dialogue에서, 이전 turn에서 확인된 정보(모델이 본 것과 말한 것)를 다시 찾아 활용하는 능력입니다. 저자들은 기존 benchmark가 이 능력을 측정하지 않았다고 지적합니다.
- Episodic Dependency: 현재 질문이 이전 turn에서 다룬 visual episode를 가리키는 경우입니다(예: "the scene from T1"). 모델이 본 것에 대한 memory를 평가합니다.
- Answer Dependency: 현재 질문이 모델 자신의 이전 답변 위에서 이어지는 경우입니다(예: "the target from T1"). 이전 답변을 찾는 retrieval과 그 답변에 맞춰 답하는 consistency가 함께 필요합니다.
- Necessity / Non-leakage: 모든 dependent turn이 충족해야 하는 두 조건입니다. Necessity는 parent turn을 제거하면 질문에 답할 수 없어야 한다는 것이고, Non-leakage는 질문이 parent turn의 episode 설명이나 답을 일부라도 다시 언급하면 안 된다는 것입니다.
- Chain Crediting (AnsDepAcc): Answer dependency가 있는 turn은 그 turn의 응답과 Answer edge로 이어진 모든 조상 turn의 응답이 전부 맞아야 정답으로 인정하는 채점 방식입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존 video QA benchmark가 In-Context Video Memory를 구조적으로 측정할 수 없다는 문제를 해결하기 위해 VideoMemBench를 제안합니다. 최근 MLLM은 million-token context로 hour-long video를 처리할 수 있게 되었고, 이에 따라 하나의 긴 video를 두고 multi-turn dialogue를 이어가는 사용 방식이 자연스러워지고 있습니다. 그러나 MVBench, Video-MME, LVBench 같은 기존 benchmark는 서로 독립적인 질문들로 구성되어 있습니다. 어떤 질문도 다른 질문의 내용이나 답을 참조하지 않고 video만으로 답할 수 있기 때문에, dialogue history가 답에 실질적으로 쓰이지 않습니다. MMDU나 MT-Video-Bench 같은 multi-turn benchmark도 turn 사이의 dependency graph를 명시하지 않고, dependency type 구분이나 multi-parent 구조도 제공하지 않습니다. text-only 환경에서는 LoCoMo, LongMemEval 등이 conversational memory를 평가해 왔지만, video로 넘어오면 "정말 이전 dialogue context가 있어야 답할 수 있는 질문"과 "video와 현재 질문만으로 답할 수 있는 질문"을 구분하기 어렵다는 문제가 생깁니다 [Figure 1].
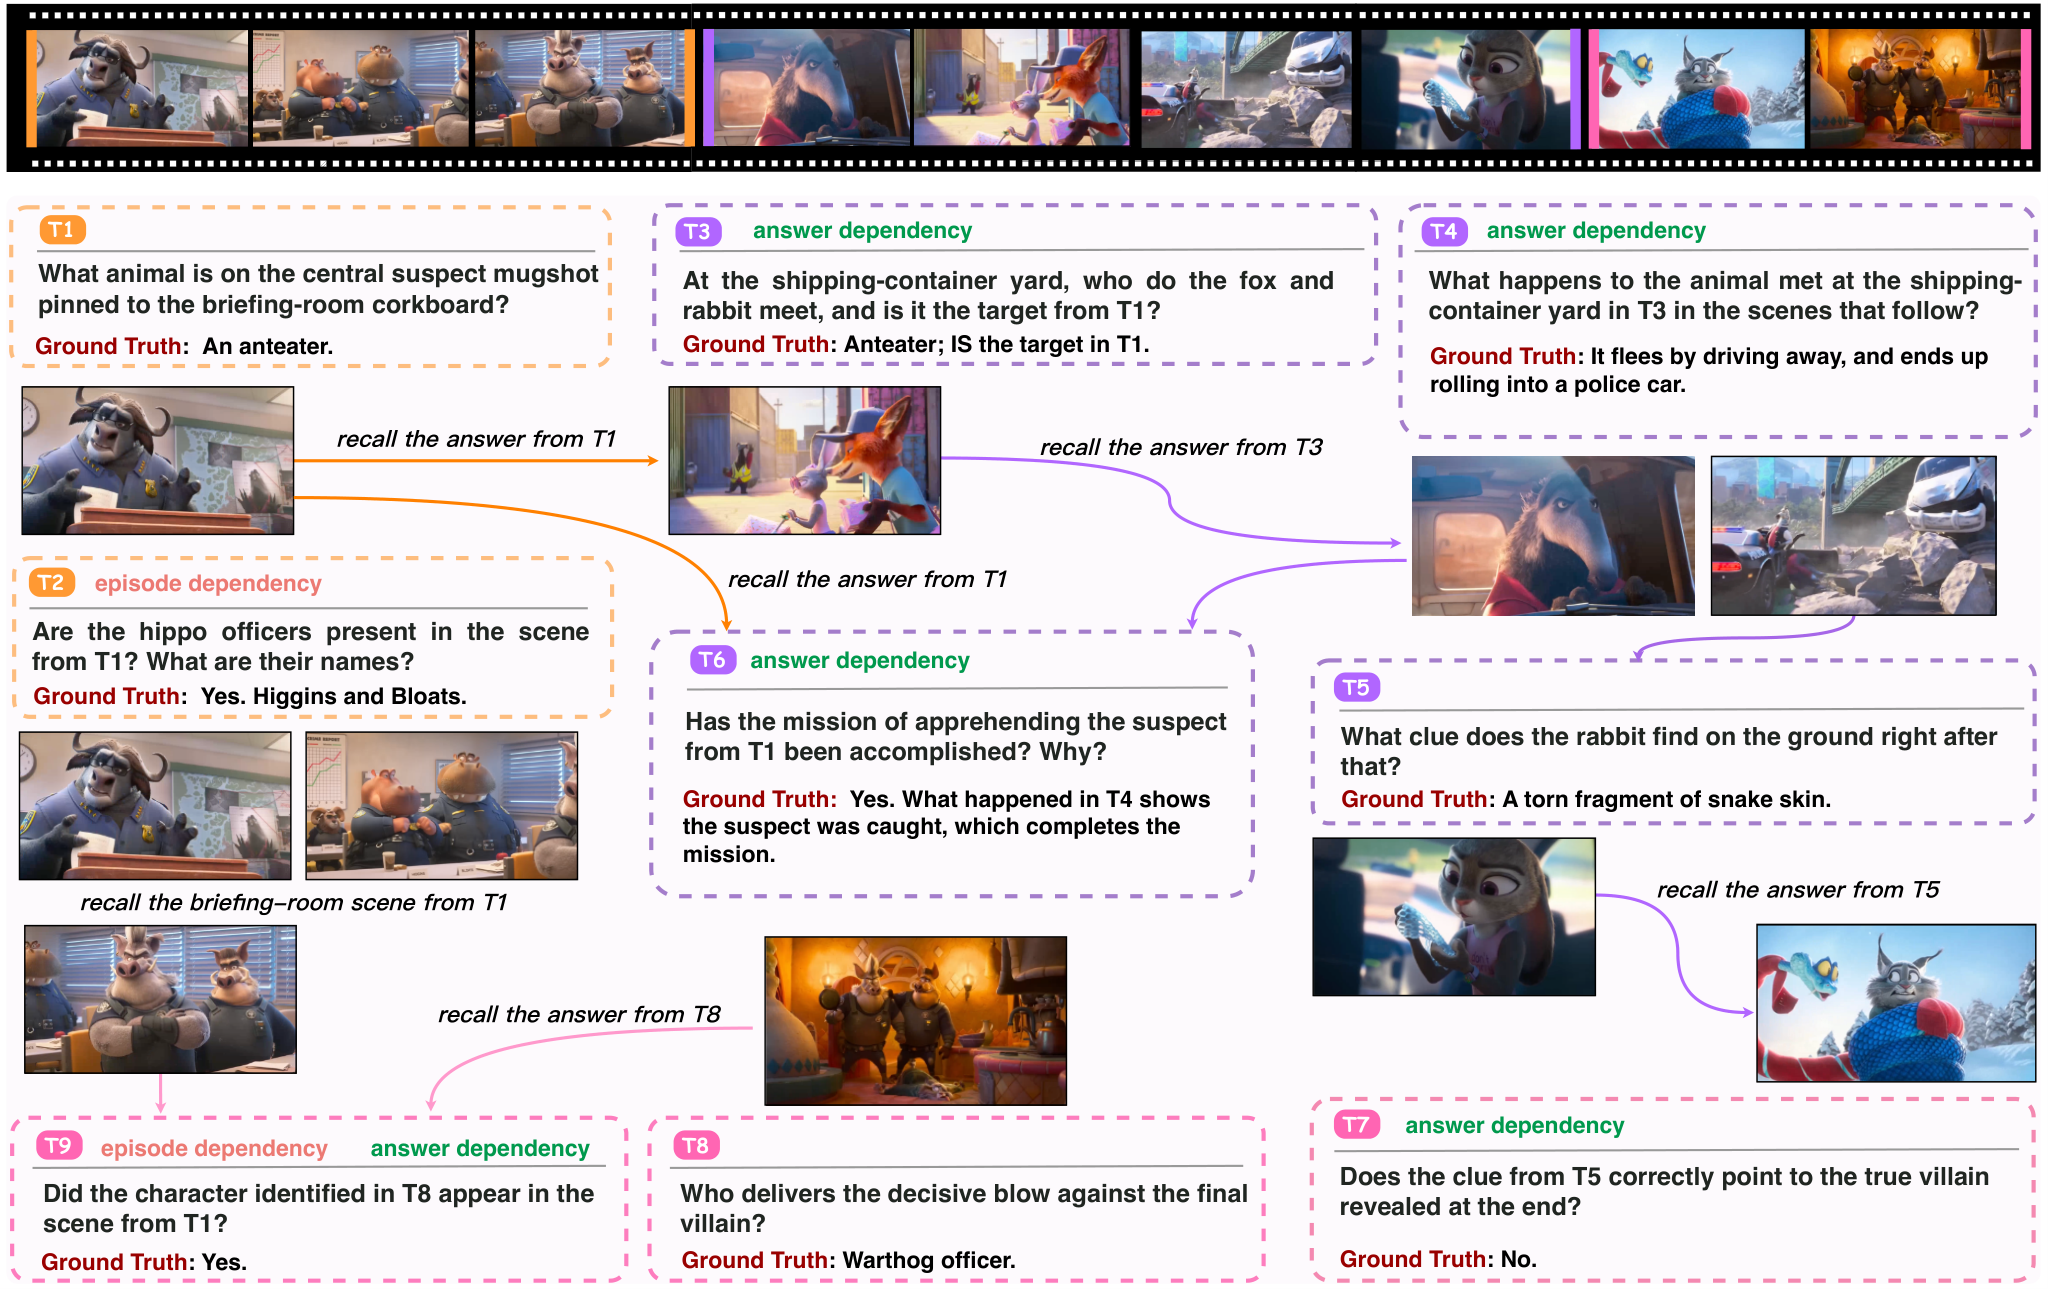
Figure 1 — Cross-turn dependency 예시
3. Method & Key Results (제안 방법론 및 핵심 결과)
VideoMemBench는 각 sample이 하나의 video와 긴 multi-turn dialogue로 구성되고, turn들이 typed dependency graph(Episodic / Answer edge)로 연결된 benchmark입니다.
구성 방법
- 세 가지 설계 요구사항: Req-1 Dependency Necessity, Req-2 Non-leakage, Req-3 Visual Grounding을 정의합니다.
- 세 개의 LLM 역할로 데이터를 구성합니다 [Figure 2]:
- planner: keyframe을 바탕으로 질문을 쓰기 전에 전체 dialogue plan을 먼저 설계합니다. plan에는 video synopsis, dialogue guideline, dependency graph, per-turn intent가 포함됩니다.
- generator: plan에 따라 turn 단위로 질문과 reference answer를 생성하고, 이전 turn은 referring expression으로만 가리킵니다.
- judger: parent turn을 제거해 보는 방식으로 necessity를 검사하고, non-leakage와 visual grounding도 함께 검증합니다. 실패한 turn은 다시 생성하고, 연속 2회 실패하면 해당 부분을 replanning합니다.
- Expert Review: 마지막으로 8명의 human expert가 모든 dialogue를 검토합니다.
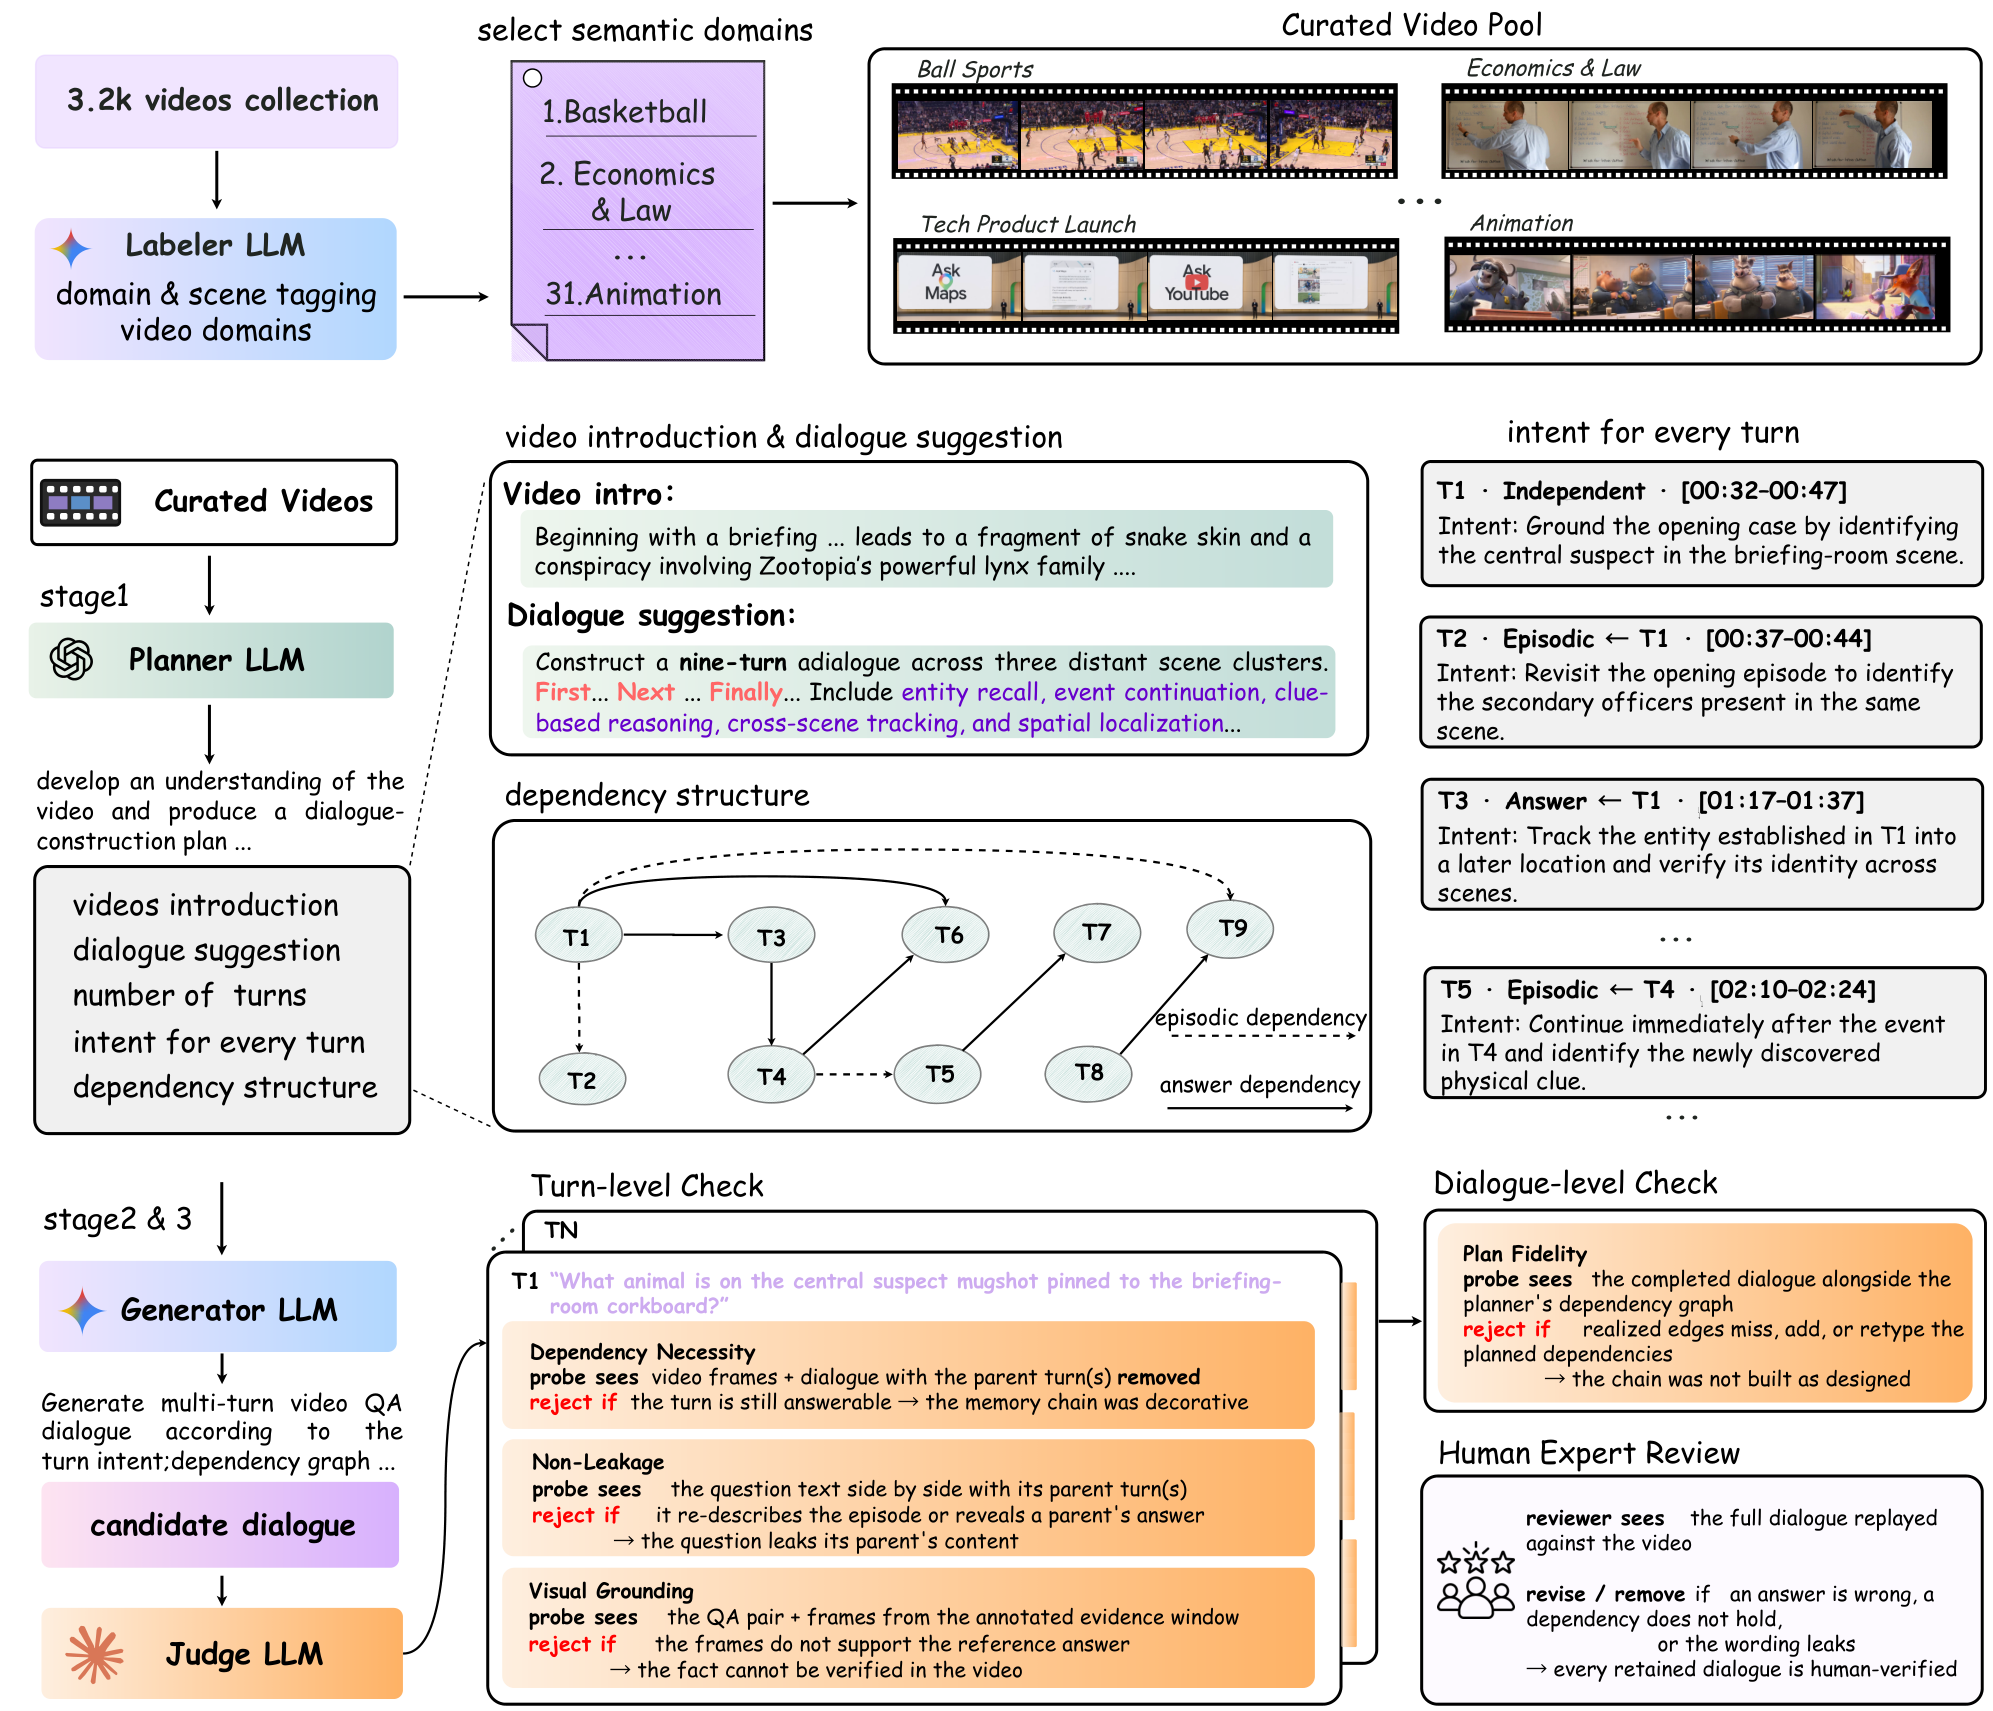
Figure 2 — 데이터 구축 pipeline
데이터셋 규모 [Figure 3]
- 326개 video, 2,476 turn으로 구성되며, 이 중 1,387 turn(56.02%)이 이전 turn에 의존합니다.
- typed dependency는 총 1,794개(Episodic 1,200, Answer 594)입니다.
- multi-parent turn은 348개입니다.
- video 길이는 최대 23.47h, dialogue 길이는 4–21 turn(평균 7.6), dependency distance는 최대 9 turn, chain depth는 최대 7입니다.
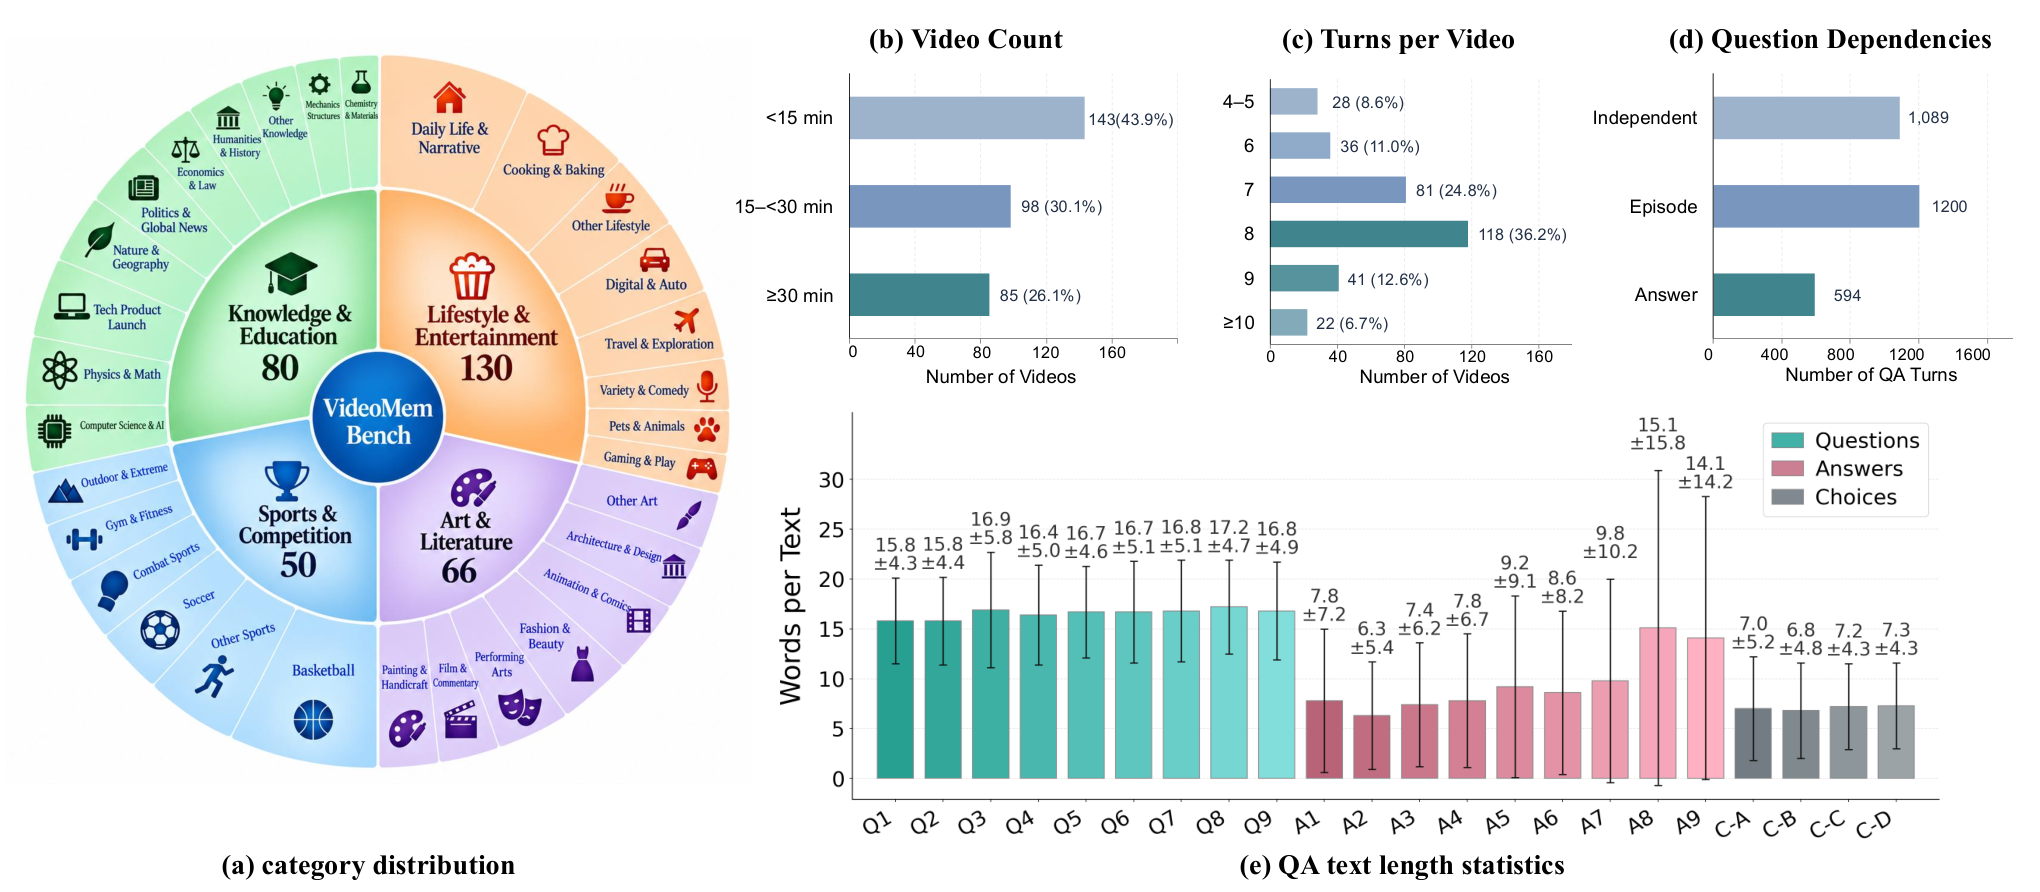
Figure 3 — 데이터셋 통계
평가 설정
- 모든 모델에 동일한 128 frame을 timestamp와 함께 입력합니다.
- self-rollout protocol을 사용합니다. 즉, 모델이 앞에서 직접 생성한 답변이 이후 turn의 history로 그대로 남습니다.
- 지표는 TurnAcc, EpiDepAcc, AnsDepAcc(chain crediting), 그리고 세 지표의 산술평균인 Overall입니다. open-ended 응답은 GPT-5.4 mini가 채점합니다.
핵심 결과
- 전체 성능: 25개 MLLM 중 Claude Opus 5가 Overall 45.7%로 1위입니다(TurnAcc 52.3%, EpiDepAcc 49.1%, AnsDepAcc 35.7%). Human의 86.1%와 비교하면 약 40%p 차이가 납니다.
- closed-source 모델의 AnsDepAcc 하락: closed-source 모델들의 AnsDepAcc는 TurnAcc보다 16.6–22.9%p 낮습니다. 사람은 이 차이가 3.9%p에 그칩니다.
- open-weight 모델: Kimi K3가 42.2%로 전체 3위입니다. 나머지 open-weight 모델은 모두 closed-source 최하위인 GPT-5.4(36.3%)보다 낮습니다. dense Qwen3.5는 크기가 커질수록 성능이 올라갑니다(0.8B 16.2% → 27B 34.3%).
- Dependency distance 영향: 전체 모델 평균 정확도는 distance 1에서 30.2%, distance 5 이상에서 23.1%로 떨어집니다.
- Parent 수 영향: Kimi K3 기준으로 parent가 1개일 때 40.8%, 3개일 때 29.8%입니다.
- Oracle history 실험: 이전 응답을 ground-truth로 바꿔 넣으면 정확도가 크게 오릅니다(Gemini 3.5 Flash 29.7% → 47.2%, Qwen3-VL-8B 12.3% → 32.4%). 그래도 independent-turn 정확도에는 미치지 못하므로, 올바른 history가 주어지는 것만으로는 충분하지 않습니다.
4. Conclusion & Impact (결론 및 시사점)
현재 frontier MLLM도 In-Context Video Memory에서 큰 한계를 보입니다. 가장 좋은 모델의 Overall이 45.7%에 그치고, dependency distance가 길어지거나 parent 수가 늘수록 성능이 계속 떨어집니다. VideoMemBench는 Episodic / Answer dependency를 명시적으로 구분해, 모델이 본 것을 기억하지 못해서 생기는 오류와 말한 것을 기억하지 못해서 생기는 오류를 따로 진단할 수 있게 해 줍니다. 특히 self-rollout 환경에서는 앞선 오답이 뒤 turn으로 누적되는 error propagation이 확인되었습니다. 이는 long-context 처리 능력만 키우는 것으로는 부족하고, dialogue context를 retrieval하고 consistency를 유지하는 능력이 따로 필요하다는 점을 보여 줍니다. 산업적으로는 video assistant나 egocentric life assistant처럼 하나의 긴 video를 두고 대화가 오래 이어지는 응용에서 신뢰성을 높이기 위한 평가 기준이자 개발 방향을 제시한다는 의미가 있습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Video-MME-v2: Towards the Next Stage in Benchmarks for Comprehensive Video Understanding
- [논문리뷰] Benchmarking Visual State Tracking in Multimodal Video Understanding
- [논문리뷰] OmniCompass: A Holistic Benchmark for Omni-Modal Video Grounding and Understanding
- [논문리뷰] LMEB: Long-horizon Memory Embedding Benchmark
Review 의 다른글
- 이전글 [논문리뷰] VidDub: Replacement-Aware Distillation for Two-Step Video Dubbing
- 현재글 : [논문리뷰] VideoMemBench: How Well Do MLLMs Remember in Video Conversations?
- 다음글 [논문리뷰] What Does Multi-Turn Reinforcement Learning Really Improve in LLM Agents?
댓글