[논문리뷰] What Does Multi-Turn Reinforcement Learning Really Improve in LLM Agents?
링크: 논문 PDF로 바로 열기
저자: Kejian Zhu, Zhuoran Jin, Shangqing Tu, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Pass@(K,T): 두 축으로 Agent를 평가하는 metric입니다. 하나는 Sampling Breadth(독립적으로 sampling한 trajectory 수 K), 다른 하나는 Interaction Depth(trajectory당 허용되는 최대 interaction turn 수 T)입니다. K개의 trajectory 중 T turn 안에서 하나라도 성공할 확률로 정의됩니다. K를 고정한 채 T만 바꾸면 Pass@T가 됩니다.
- Multi-Turn Agentic RL: Agent가 history h_t를 보고 action(tool call, terminal 명령, code 실행 등)을 sampling하고, environment에서 observation을 받는 과정을 여러 turn 반복합니다. 이 학습 방식은 terminal verifier가 주는 trajectory reward로 policy를 최적화합니다. 대표적으로 outcome-only 방식인 GRPO와 process-level credit assignment 방식인 GiGPO가 있습니다.
- Step-Level Action Quality: 동일한 state에서 Base와 RL policy가 각각 G=16개의 action을 sampling했을 때 그 action들의 평균 품질입니다. FrozenLake에서는 finite-horizon DP로 계산한 Q* 값으로, DeepCoder-MT에서는 unit-test pass rate로 측정합니다.
- Error State: 직전 step에 잘못된 action을 의도적으로 주입해 만든 state입니다. 모델의 Error Recovery 능력을 측정하는 데 쓰입니다.
- BudgetMix RL: 저자들이 제안한 학습 전략입니다. reward 설계는 그대로 두고, 학습 중 task group마다 interaction budget T를 T_max의 10% 간격 후보 중에서 uniform sampling합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문은 "Multi-turn agentic RL이 실제로 어떤 능력을 향상시키는가?"를 trajectory-level success rate만으로는 알 수 없다고 보고, 이 문제를 체계적으로 규명합니다. 기존 연구는 주어진 budget 안에서 task를 완료했는지만 보고하는 trajectory-level 평가에 머물러 있었습니다. single-turn RL 연구에서 쓰인 Pass@K는 Sampling Breadth라는 한 차원만 다룹니다. 반면 interactive agent에는 trajectory당 허용되는 turn 수라는 Interaction Depth 축이 하나 더 있는데, 기존 평가는 이를 고려하지 않았습니다. 그 결과 RL 모델이 interaction budget 변화에 일관되게 대응하는지, 개별 step의 decision이 실제로 나아졌는지가 가려져 있었습니다. 이 점은 budget 제약이 엄격하거나 되돌릴 수 없는 action(금융, database 조작 등)이 포함된 실제 deployment 환경에서 중요한 위험 요인이 됩니다 [Figure 1].
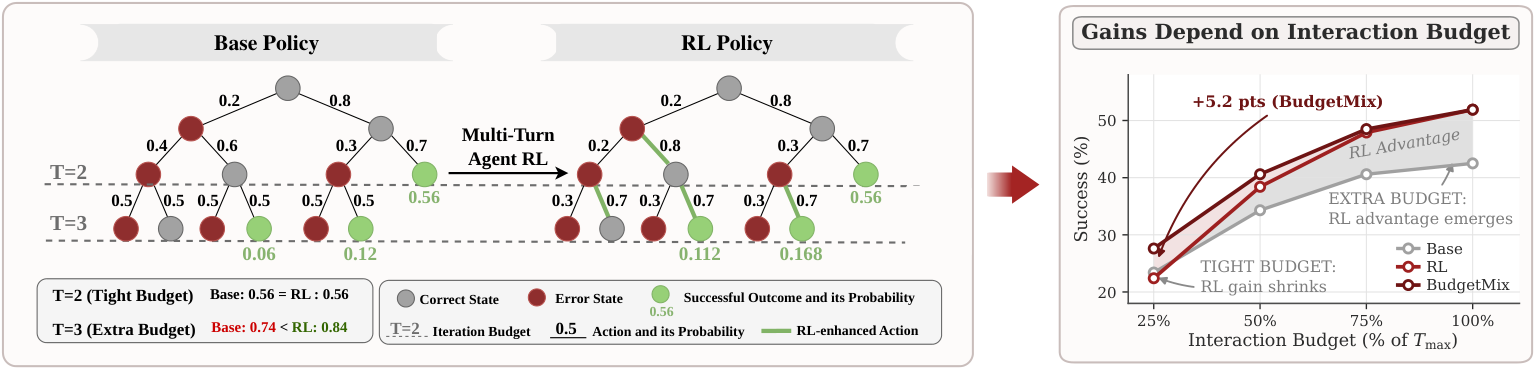
Figure 1 — 핵심 발견 개요
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 Pass@(K,T) 2차원 평가, step-level action quality 분석, likelihood 분석, training dynamics 분석으로 agentic RL의 이점이 어디서 오는지 밝혔습니다. 또 그 결과를 바탕으로 BudgetMix RL을 대안으로 제시했습니다. 주 RL 알고리즘은 GRPO이고, 평가 benchmark는 DeepCoder-MT, BFCL, InterCode-SQL, FrozenLake 네 가지입니다. 주 base model은 Qwen3-4B / Qwen3-8B입니다.
- Sampling Breadth (Pass@K): K가 커질수록 RL 모델은 base model보다 일관되게 높은 성능을 보였습니다. single-turn RL에서는 RL이 base model의 capability boundary를 넘지 못한다는 기존 관찰이 있었는데, multi-turn RL은 base model의 empirical capability boundary를 넘어섰습니다.
- Interaction Depth (Pass@T, k=8): T가 충분할 때는 RL의 우위가 컸습니다. 반면 budget이 빠듯하면 우위가 크게 줄었고, 일부 task에서는 base model보다 낮아지기도 했습니다. 저자들은 budget이 작아 task가 구조적으로 풀 수 없게 된 탓이 아님을 확인하기 위해 structural upper bound도 함께 계산했습니다 [Figure 1].
- Step-Level Action Quality: 동일한 state에서 RL이 더 나은 action을 고른 비율은 DeepCoder-MT 46.8%, FrozenLake 42.8%에 그쳤습니다. 평균 품질도 base model보다 낫지 않았고, 오히려 약간 낮았습니다.
- Error Recovery: Error State에서는 RL이 더 나은 action을 고른 비율이 FrozenLake 65.7%, DeepCoder-MT 67.3%로 경향이 역전되었습니다. 같은 error state에서 이어서 실행했을 때의 최종 성공률도 RL이 높았습니다(FrozenLake 51.3% vs. 38.6%, DeepCoder-MT 38.5% vs. 22.9%).
- Trajectory 후반부 우위: trajectory 초반에는 RL이 오히려 열세였습니다. interaction이 진행될수록 격차가 좁혀지다가 역전되었습니다.
- Likelihood 분석 (Terminal-Bench): base policy 기준으로 계산한 action NLL은 RL action이 12.20, base action이 10.25로 분포가 크게 겹쳤습니다. 즉 개별 RL action은 base model 기준으로도 충분히 그럴 법한(locally plausible) action입니다. 그러나 성공한 RL trajectory의 cumulative LLR은 약 228로, 성공한 base trajectory의 약 26보다 훨씬 높았습니다. 저자들은 이를 RL이 개별 action을 개선하기보다, 그럴 법한 action들을 이어 long-horizon trajectory를 안정적으로 구성하는 능력을 강화했다는 근거로 해석합니다.
- Training Dynamics: DeepCoder-MT에서 학습이 진행되는 동안 R_multi는 0.331 상승했지만, 학습에 사용하지 않고 추적만 한 step reward R_single은 0.097 하락했습니다.
- Process Supervision 신호: FrozenLake에서는 oracle Q-value reward나 GiGPO가 budget 의존성을 줄였습니다. 그러나 정확한 step-level oracle이 없는 BFCL에서는 GiGPO와 PPO도 GRPO와 비슷한 수준에 머물렀습니다.
- BudgetMix RL 결과: 학습할 때 prompt에 전체 budget과 남은 budget을 알려 주고, budget을 넘겨 완료하지 못하면 reward를 0으로 줍니다.
- budget을 T_max의 25% / 50% / 75%로 제한했을 때, full-budget RL 대비 네 task 평균 7.5 / 5.3 / 4.0 percentage point 향상되었습니다.
- 100% budget에서는 full-budget RL과 대등한 성능을 유지했습니다.
- 전체 평균 gain은 Qwen3-4B에서 +4.2pp, Qwen3-8B에서 +4.8pp입니다.
- 학습 중 R_single이 떨어지지 않고 유지되거나 소폭 개선되었습니다.
4. Conclusion & Impact (결론 및 시사점)
저자들의 결론은, multi-turn agentic RL의 이점이 모든 step의 action 품질을 고르게 높이는 데서 오지 않는다는 것입니다. 이점은 주로 Error Recovery와 Long-Horizon Resilience에서 나오며, 따라서 충분한 interaction budget이 있어야 드러납니다. RL은 base model의 empirical capability boundary를 넓히지만, budget이 빠듯해지면 그 우위가 줄어들거나 역전될 수 있습니다. 이 한계는 높은 trajectory success rate 뒤에 가려진 deployment 위험입니다. 저자들은 이 문제를 완화하는 실용적인 대안으로 BudgetMix RL을 제시했습니다. 학계에는 agent 평가가 최종 success rate를 넘어 budget robustness와 step-level decision 신뢰성까지 다뤄야 한다는 평가 기준을 제시합니다. 산업계에는 budget 제약이 엄격하거나 되돌릴 수 없는 action이 있는 환경에 RL agent를 배포할 때 고려해야 할 위험 요소와 학습 전략을 보여 준다는 의미가 있습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Sharpening Tax in Post-Training
- [논문리뷰] AgentProcessBench: Diagnosing Step-Level Process Quality in Tool-Using Agents
- [논문리뷰] When Tools Fail: Benchmarking Dynamic Replanning and Anomaly Recovery in LLM Agents
- [논문리뷰] DRACO: Fine-Grained Credit Assignment with Dynamic Rubrics for Long-Horizon Agent Training
- [논문리뷰] Mid-Harness: Scaling Actions Between Model and Harness for Terminal Agents
Review 의 다른글
- 이전글 [논문리뷰] VideoMemBench: How Well Do MLLMs Remember in Video Conversations?
- 현재글 : [논문리뷰] What Does Multi-Turn Reinforcement Learning Really Improve in LLM Agents?
- 다음글 [논문리뷰] Why Pay for Long Reasoning When Rewrite Do Trick? Causal Effects of Reasoning History Compaction on Future Generation and Agent Cost
댓글