[논문리뷰] SAE Interprets MoE: Sparse AutoEncoders Reveal That MoE Experts Exhibit Human-Interpretable Fine-Grained Specialization
링크: 논문 PDF로 바로 열기
저자: Anyuan Zhuo, Shaohua Zhang, Yuan Lin, Pinyan Lu (ByteDance Seed, Shanghai University of Finance and Economics)
1. Key Terms & Definitions (핵심 용어 및 정의)
- Contribution (c(j, i, x₁:ₜ)): MoE layer output은 activated expert output의 router-weighted sum이고 SAE encoder는 affine입니다. 따라서 latent i의 pre-activation을 expert별 항 gⱼ(t)·W_enc,(i)·uⱼ(t) 으로 정확히(exact) 분해할 수 있습니다. 이 항에 ReLU를 적용해 positive part만 취한 값이 expert j의 latent i에 대한 contribution입니다.
- Contribution Fraction (s(j, i)): per-token contribution을 activated expert 집합 내에서 normalize하고, 이를 corpus 전체에 대해 평균한 뒤 다시 expert 차원으로 normalize한 값입니다. expert j가 latent i의 activation을 일반적으로 얼마나 책임지는지를 나타냅니다.
- Dominance / Dominant Set S(j): s(j, i) ≥ τ(τ = 0.2)이면 expert j가 latent i를 dominate한다고 정의합니다. 한 expert가 dominate하는 latent 전체의 집합이 그 expert의 dominant set입니다.
- Dominance Graph: expert와 SAE latent를 양쪽 vertex로 두고, dominance 관계를 edge로 연결한 bipartite graph입니다.
- Explanation Word Cloud: dominant set에서 sampling한 latent들의 auto-interpretation 결과(GPT-5.5 생성)에서 단어 빈도를 집계해 시각화한 것입니다. expert의 역할을 모델 자체의 feature vocabulary로 기술하는 데 사용됩니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 MoE의 개별 expert가 실제로 무엇을 책임지는지를 analyst가 사전에 정한 domain label이 아니라 모델 자체의 feature space에서 밝히고자 합니다. 기존 연구는 domain-labeled corpus(GitHub, arXiv 등)에서 각 expert가 얼마나 자주 선택되는지(selection frequency)를 세는 방식에 의존해 왔습니다. 그 결과 "domain-specialized"라는 결론과 "token identity 같은 surface property에 의해 routing된다"는 결론이 서로 엇갈렸습니다.
저자들은 이 방식의 한계를 네 가지로 지적합니다.
- (a) taxonomy가 모델에서 recover되지 않고 analyst에 의해 강요됩니다.
- (b) corpus 단위 label은 code, math 수준으로 너무 coarse한 granularity를 가집니다.
- (c) label은 corpus에 붙지만 routing은 per-token으로 결정됩니다.
- (d) activation frequency는 router coefficient를 무시하므로 selection과 실제 contribution을 구분하지 못합니다.
따라서 unsupervised로 학습된 SAE latent를 분석 단위로 삼고, per-token·per-expert contribution을 측정하는 새로운 접근이 필요합니다 [Figure 1].
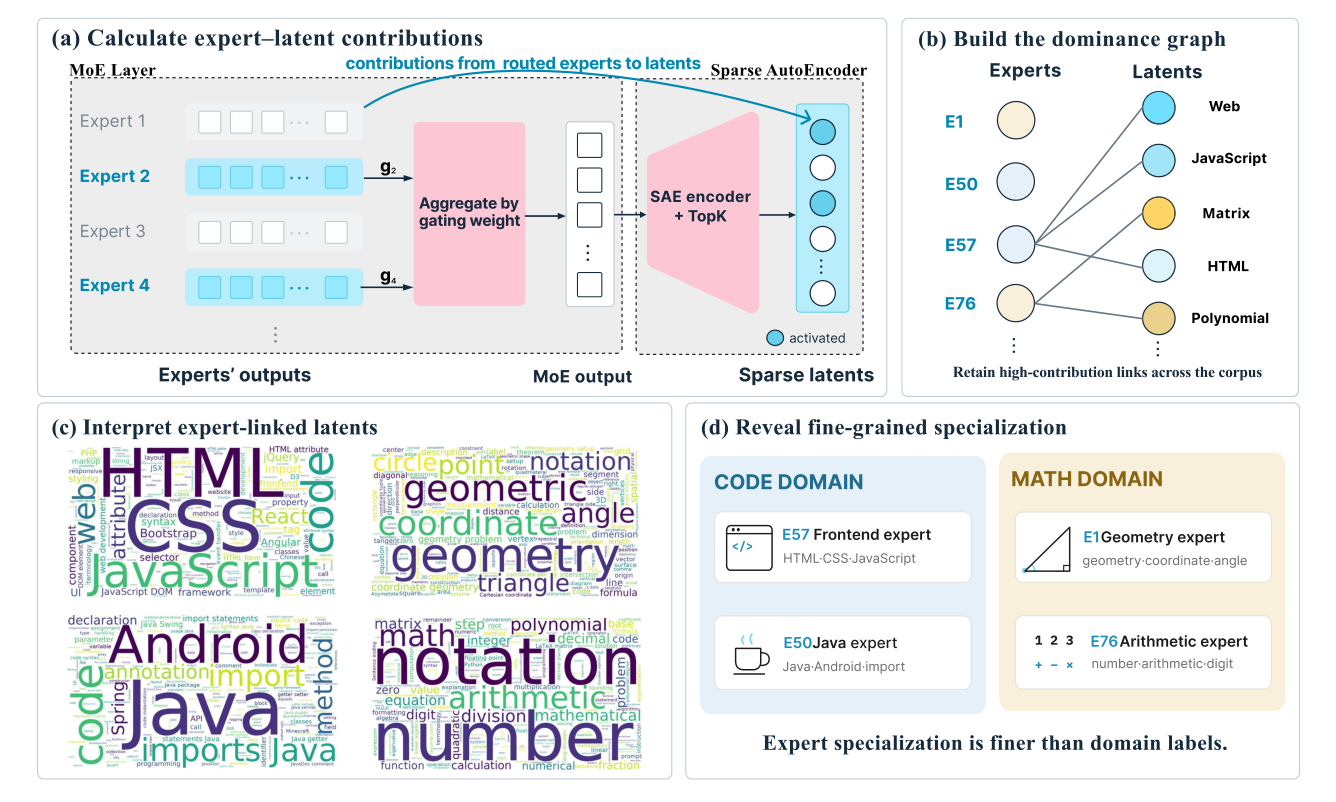
Figure 1 — 제안 방법론 전체 파이프라인과 핵심 발견(Java/Frontend, Geometry/Arithmetic expert 분리)을 보여주는 프레임워크 다이어그램
3. Method & Key Results (제안 방법론 및 핵심 결과)
방법론. 저자들은 MoE layer output에 TopK SAE를 학습하고, latent activation을 expert별 contribution으로 exact decomposition하여 각 expert의 dominant set을 구축합니다.
- 분석 대상: Qwen3-30B-A3B(48 layers, layer당 N = 128 experts, k = 8 activated, shared expert 없음)의 layer 4, 30, 46을 각각 shallow, mid-late, deep으로 선정했습니다.
- SAE 설정: layer별로 latent size 2²⁰의 SAE를 학습했습니다. 학습 데이터는 Olmo 3 corpus에서 가져온 약 3.2B tokens이며, κ는 1000에서 100으로 decay시켰습니다. FVU는 각각 12.6% / 25.1% / 7.6% 입니다.
- 통계 계산: training set과 겹치지 않는 1.5B-token validation set에서 contribution fraction을 계산합니다.
- Dominance graph 구축: 균등 분배 시 기준값인 1/N ≈ 0.008보다 훨씬 높은 τ = 0.2로 thresholding합니다.
- Expert 해석: 각 expert의 dominant set에서 최대 2000개 latent를 sampling합니다. GPT-5.5가 activating contexts와 logit effects를 바탕으로 각 latent를 해석하고, 그 결과로 expert label을 붙인 뒤 domain으로 grouping합니다.
핵심 결과.
- Contribution은 gating보다 훨씬 집중되어 있습니다 [Figure 2].
- Layer 30에서 rank 0~2의 gating은 0.231, 0.169, 0.137 로 완만하게 감소합니다.
- 반면 contribution은 0.512, 0.185, 0.115 로, top-1 expert 하나가 전체의 절반 이상을 차지합니다.
- rank 7에서는 contribution C̄₇ = 0.005, gating ḡ₇ = 0.074 입니다.
- ReLU truncation은 평균 2.09 / 1.29 / 1.64개 expert에만 발생하므로, 이 집중이 truncation artifact라고 보기 어렵습니다.
- Latent-side degree는 1~2에 집중됩니다.
- dominator가 정확히 1개인 latent는 57.4% / 62.1% / 56.7% 입니다.
- 1~2개까지 합하면 89.9% / 85.1% / 92.7% 입니다.
- degree 3 이상은 최대 3.7% 에 그칩니다.
- Expert-side에서는 dominance가 layer 전체에 고르게 퍼져 있습니다.
- 128개 expert 모두 비어 있지 않은 dominant set을 가집니다.
- top-10 expert가 보유한 edge 비중은 최대 30.1% 로, 소수의 hub expert가 dominance를 독점하지 않습니다.
- Dominant set 간 overlap은 소수의 pair에 몰려 있습니다.
- Jaccard similarity의 median은 약 10⁻⁴ 입니다.
- 공유하는 latent가 전혀 없는 pair가 37.5~40.5% 입니다.
- 상위 10% pair가 전체 intersection의 78.5~83.8% 를 차지합니다.
- expert dominant set의 평균 46~59% 는 해당 expert만 단독으로 dominate합니다.
- Domain보다 세밀한(fine-grained) specialization이 나타납니다 (layer 30) [Table 2].
- Code 내부에서 E50(Java/Android) 과 E57(Front-end web) 이 분리됩니다.
- Math 내부에서 E1(Geometry) 과 E76(Arithmetic/Polynomial) 이 분리됩니다.
- 각 expert의 theme share는 86.7% / 78.6% / 78.1% / 59.1% 입니다. 다른 expert에서 무작위로 뽑은 random baseline은 1.9~6.7% 에 불과합니다.
- Token 기반 word cloud와 비교하면 explanation 기반 해석이 더 많은 정보를 드러냅니다.
- Token 기반 word cloud는 function word가 지배적입니다. Expert 72의 경우 "algorithms/data structures" theme을 거의 드러내지 못합니다.
- Explanation 기반 word cloud는 exercise·health와 algorithm이라는 두 theme을 모두 드러냅니다.
- Domain 간 expert allocation은 불균등합니다.
- 128개 expert는 GPT-5.5에 의해 11개 domain으로 grouping되었습니다.
- Computing이 28개, Mathematics and reasoning이 20개로, 두 domain이 전체의 37.5% 를 차지합니다.
- Text form, language, entities and identifiers처럼 subject area가 아닌 domain도 합계 36개(28.1%) expert를 가집니다.
- Art는 128개 label 중 단 1개(expert 54)에만 등장합니다.
- Overlap이 큰 상위 20 pair 중 19개가 같은 domain에 속합니다. 무작위 pair 기준 비율은 12.8% 입니다.
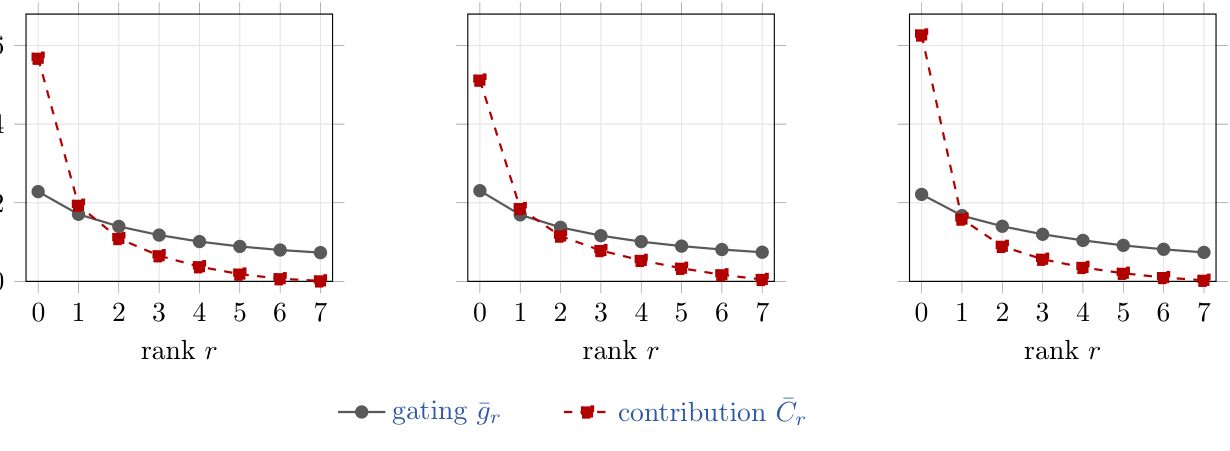
Figure 2 — Contribution이 gating보다 훨씬 집중되어 있음을 보여주는 핵심 정량 결과
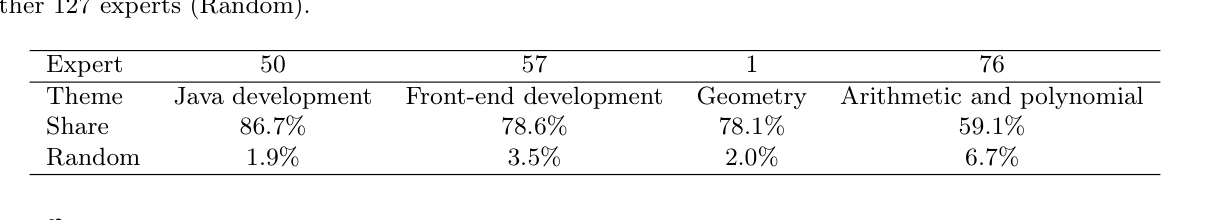
Table 2 — Domain보다 세밀한 expert specialization을 정량적으로 입증하는 결과
4. Conclusion & Impact (결론 및 시사점)
Qwen3-30B-A3B의 expert들은 실제로 division of labor를 하지만, 그 단위는 coarse domain이 아니라 feature-level의 fine-grained subfield입니다. Contribution 기준으로 보면 latent 대부분은 1~2개 expert에 의해 dominate되고, dominant set은 대체로 disjoint하며, overlap은 같은 domain의 소수 expert pair에 집중됩니다. 이 분석은 expert output과 layer output SAE만 있으면 되므로, output이 expert의 weighted sum인 모든 MoE layer에 적용할 수 있습니다.
연구의 시사점은 다음과 같습니다.
- 비교 분석 도구: routing objective나 load balancing loss가 division of labor를 어떻게 형성하는지 비교하는 instrument로 활용할 수 있습니다.
- Testable hypothesis 제공: expert pruning, merging, feature-level steering에 대해 "expert를 제거하거나 편집하면 주로 그 expert가 dominate하는 latent가 영향을 받는다"는 검증 가능한 가설을 제시합니다.
한계도 분명합니다.
- SAE의 reconstruction error(특히 layer 30의 FVU 25.1%)와 feature absorption 문제가 분석에 그대로 영향을 줍니다.
- 단일 모델만 분석했습니다.
- Qwen3의 pretraining data mixture가 공개되지 않아, domain 불균등이 training data 비율을 반영한다는 해석은 conjecture로 남습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] The Illusion of Specialization: Unveiling the Domain-Invariant 'Standing Committee' in Mixture-of-Experts Models
- [논문리뷰] Unstable Features, Reproducible Subspaces: Understanding Seed Dependence in Sparse Autoencoders
- [논문리뷰] Parts-of-Speech as Emergent Categories in SAE Latent Space
- [논문리뷰] WriteSAE: Sparse Autoencoders for Recurrent State
Review 의 다른글
- 이전글 [논문리뷰] Reducing Representational Interference in Retrieval Embeddings with Trainable Prefix Tokens
- 현재글 : [논문리뷰] SAE Interprets MoE: Sparse AutoEncoders Reveal That MoE Experts Exhibit Human-Interpretable Fine-Grained Specialization
- 다음글 [논문리뷰] SLA: Scaling Spatial-Language-Action Model via Continual Pre-training
댓글