[논문리뷰] SynthFaces: Balanced Large Scale Human Dataset
링크: 논문 PDF로 바로 열기
저자: Sergey Karpukhin, Denis Bobkov, Kirill Morozov, Aibek Alanov (FusionBrain Lab, HSE University, MSU)
1. Key Terms & Definitions (핵심 용어 및 정의)
- SynthFaces: 저자들이 공개한 합성 인물 데이터셋입니다. 약 15,000개 identity에 대해 Caption이 달린 고해상도 이미지 150,000장(identity당 약 10장)으로 구성됩니다. age, race, gender label이 균형을 이루도록 설계되었고, 이미지는 identity별로 묶여 있습니다(ID-grouped).
- ID-Flow: unit hypersphere 위에 놓인 ArcFace identity embedding의 분포를 학습하는 조건부 generative model입니다. 구에서의 Uniform prior와 실제 embedding 분포를 geodesic conditional flow로 잇는 Riemannian (Geodesic) Flow Matching 방식이며, 단순한 MLP에 skip-connection을 더한 구조를 사용합니다.
- ID-NonLeak (ID-NL): 생성된 identity가 학습에 쓰인 실제 identity와 얼마나 떨어져 있는지 재는 지표입니다. 가장 가까운 학습 샘플과의 평균 cosine distance로 계산하며, 값이 높을수록 실제 인물 정보가 덜 새어 나온다는 뜻입니다.
- SER (Skewed Error Ratio): global FMR을 고정한 operating point에서 그룹별 FNMR을 global FNMR로 나눈 값입니다. SER_max = 1.0이면 그룹 간 parity가 완벽하다는 뜻입니다.
- FairBench: 저자들이 만든 probe set으로, FairFace label의 모든 조합을 uniform하게 샘플링해 subgroup별 identity preservation 성능을 평가합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문은 인물 중심(human-centric) 데이터셋에 있는 demographic bias와 privacy 문제 때문에 generative model이 subgroup마다 성능 차이를 보인다는 점을 문제로 삼습니다. 이를 해결하기 위해 label이 균형을 이루는 합성 identity 데이터셋을 만드는 pipeline을 제안합니다. 저자들은 다음 세 가지 문제를 제기합니다.
- Label bias: FFHQ, SHHQ, EasyPortrait, CosmicMan-HQ 같은 기존 데이터셋은 age, race, gender 분포가 심하게 치우쳐 있습니다. StyleGAN, Arc2Face, PhotoMaker 같은 sampler도 이 skew를 그대로 물려받습니다.
- Subgroup별 성능 차이: 조건부 personalization 모델의 face similarity가 demographic 그룹마다 고르지 않습니다. 그런데 대부분의 모델은 평균 품질만 보고해 이 차이가 드러나지 않습니다.
- 실제 인물 사용 문제: 대규모 실제 데이터셋에는 동의하지 않은 사람이나 미성년자가 포함될 수 있습니다. 실제로 MS-Celeb-1M 등 일부 데이터셋은 공개가 철회되었습니다.
기존 합성 방식에도 한계가 있습니다. Arc2Face/Vec2Face는 실제 ArcFace embedding에 PCA perturbation을 가하므로 inference 단계에서도 실제 embedding이 필요하고, 실제 identity와의 분리를 명시적으로 보장하지 않습니다. HyperFace는 hypersphere를 직접 탐색하지만 생성된 identity가 여전히 demographic 불균형을 보입니다. 저자들은 Caption, 균형 잡힌 label, ID-grouped, Private, HQ라는 다섯 가지 속성을 모두 갖춘 데이터셋이 없다고 지적합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 3-stage pipeline으로 데이터셋을 구축합니다 [Figure 2].
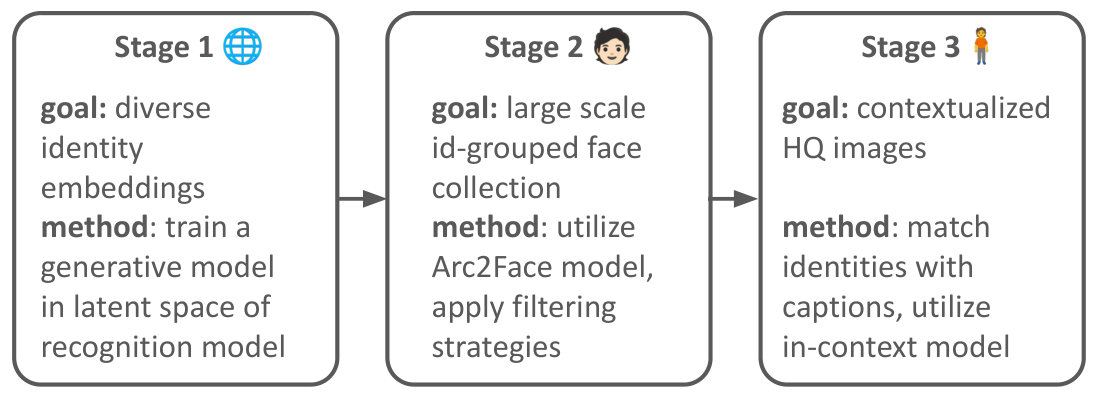
Figure 2 — 데이터셋 구축 파이프라인
Stage 1 (Identity sampling)
- 약 50k개의 중복 제거된 ArcFace embedding(CosmicMan-HQ, FFHQ, EasyPortrait에서 추출)으로 ID-Flow를 학습합니다.
- 구 위의 exp/log map이 명시적으로 정의되어 있으므로 simulation 없이 학습 target을 얻을 수 있습니다. 목적함수는 geodesic conditional flow matching loss($L_{GCFM}$)입니다.
- race, age, gender label을 조건으로 넣고, sampling 시에는 guidance scale 2.0의 Classifier-Free Guidance를 적용합니다 [Figure 3].
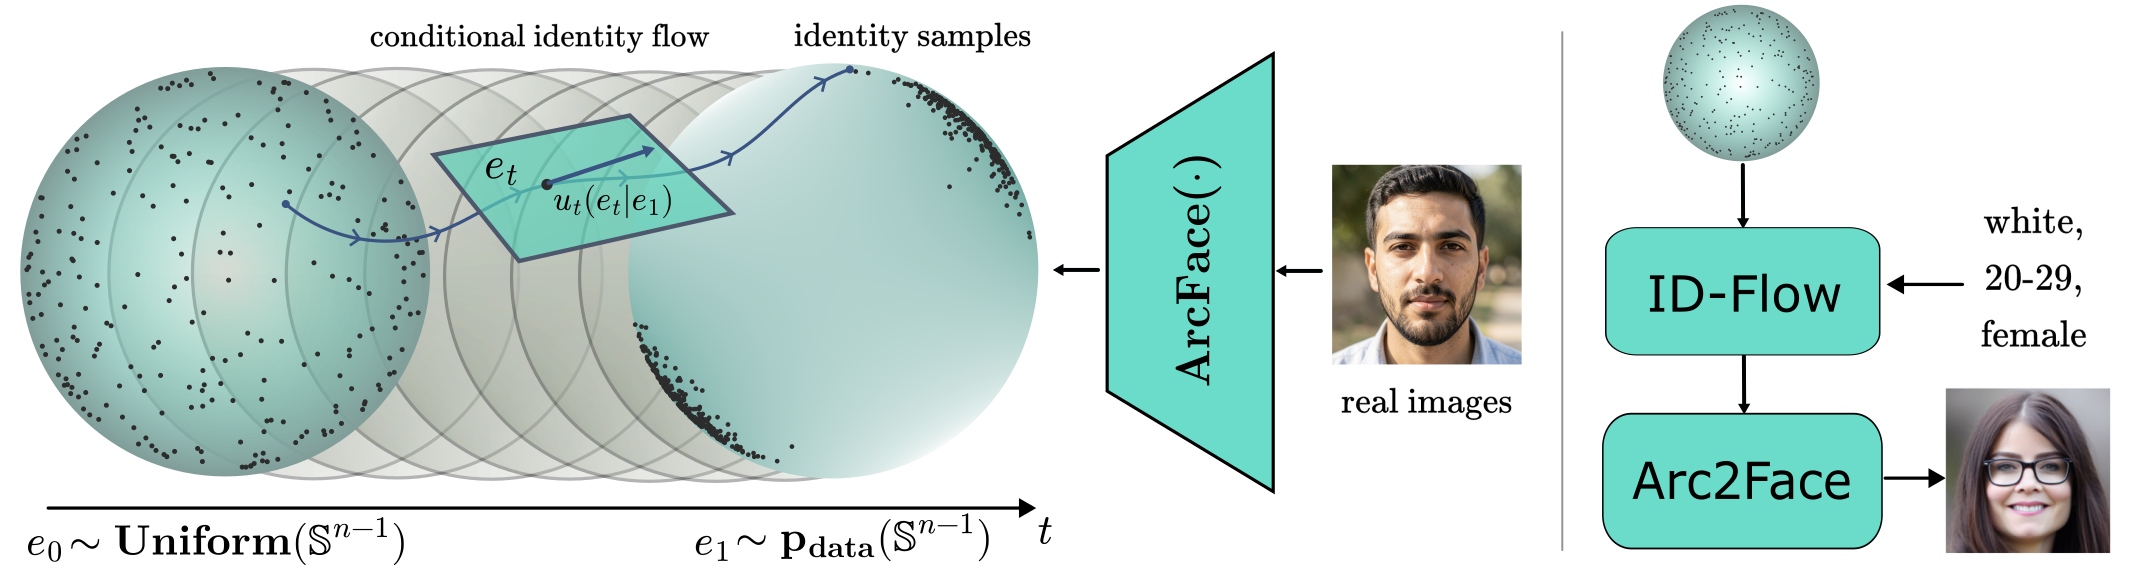
Figure 3 — ID-Flow 학습·추론 구조
Stage 2 (Face rendering 및 curation)
- 샘플링한 28k개 embedding을 Arc2Face로 얼굴 이미지로 만듭니다.
- 이후 세 단계로 걸러냅니다.
- entropy와 saturation 분포의 tail에 해당하는 약 3k장을 제거합니다.
- 여러 Qwen-VL 모델의 majority voting으로 label과 맞지 않거나 artifact가 있는 이미지를 제거합니다.
- 학습 데이터에서 드문 subgroup은 similarity threshold로 거릅니다.
- 이 과정을 거쳐 약 15k identity가 남습니다.
Stage 3 (Contextualization)
- 실제 데이터셋과 HumanCaption에서 모은 caption 가운데 얼굴 속성 묘사를 제거한 것을 label에 맞춰 배정합니다.
- InfiniteYou(realism/deblur LoRA 추가)와 Flux 2 Turbo로 각 identity를 다양한 맥락의 이미지로 생성합니다.
정량 결과
- Identity sampler 비교
- ID-Flow는 학습 기반 sampler 중 가장 좋은 FID-e(0.073), Recall(0.75), F1(0.48), ID-NL(0.741)을 기록했습니다. 이미지 FID는 39.9로 Arc2Face(37.3)와 비슷한 수준을 유지했습니다.
- Interpolation baseline은 FID가 더 낮지만 ID-NL이 0.43에 그쳐, 학습 데이터 identity가 샘플에 새어 나왔습니다.
- Label balance (uniform 분포와의 KL)
- SynthFaces는 0.048로, FFHQ(0.449)와 CosmicHQ(0.576)보다 훨씬 균형 잡혀 있습니다.
- Flux.2에 균형 prompt를 넣어 생성한 경우와 비교하면, Label KL은 0.037 vs 0.101(약 2.7배 차이), ID diversity는 0.751 vs 0.201(약 3.7배 차이)입니다.
- 이미지 품질
- ImageReward는 1.38(Cosmic-HQ는 −0.69), CLIP score는 33.04(Cosmic-HQ는 31.20)입니다.
- ID-preserving generation
- SD-1.5 + IP-Adapter-FaceID를 SynthFaces로 fine-tuning했고, 얼굴 크기가 hidden shortcut으로 학습되지 않도록 frozen ControlNet을 붙였습니다.
- FairBench ID 점수가 68.63 → 71.31로 올랐고, Context benchmark에서는 비슷한 수준(28.81 → 28.49)을 유지했습니다.
- 개선은 특정 그룹에 국한되지 않고 age·race 그룹 전반에서 나타나, 그룹 간 성능이 더 고르게 되었습니다 [Figure 8].
- Face Recognition fairness
- SynthFaces-500K(IResNet-100)는 5개 표준 benchmark에서 FPR 0.1% 기준 평균 racial SER_max 1.097을 기록했습니다. Vec2Face(1.531) 대비 약 40% 낮습니다.
- BFW에서는 Accuracy Disparity 0.043(Vec2Face 0.087, HyperFace 0.068), SER_max@0.1% 1.011로 parity에 거의 근접했습니다.
- 다만 표준 benchmark의 global accuracy는 baseline보다 낮을 수 있다고 저자들이 직접 밝히고 있습니다.
- Demographic VQA (LLaVA-1.5-7B + LoRA)
- SynthFaces-nonHQ는 평균 accuracy 0.797, 평균 disparity $\overline{\Delta}$ 0.138을 기록했습니다.
- 같은 이미지 스타일의 Vec2Face(0.559 / 0.263)와 비교하면 accuracy는 +23.8pp 높고 disparity는 0.125 낮습니다.
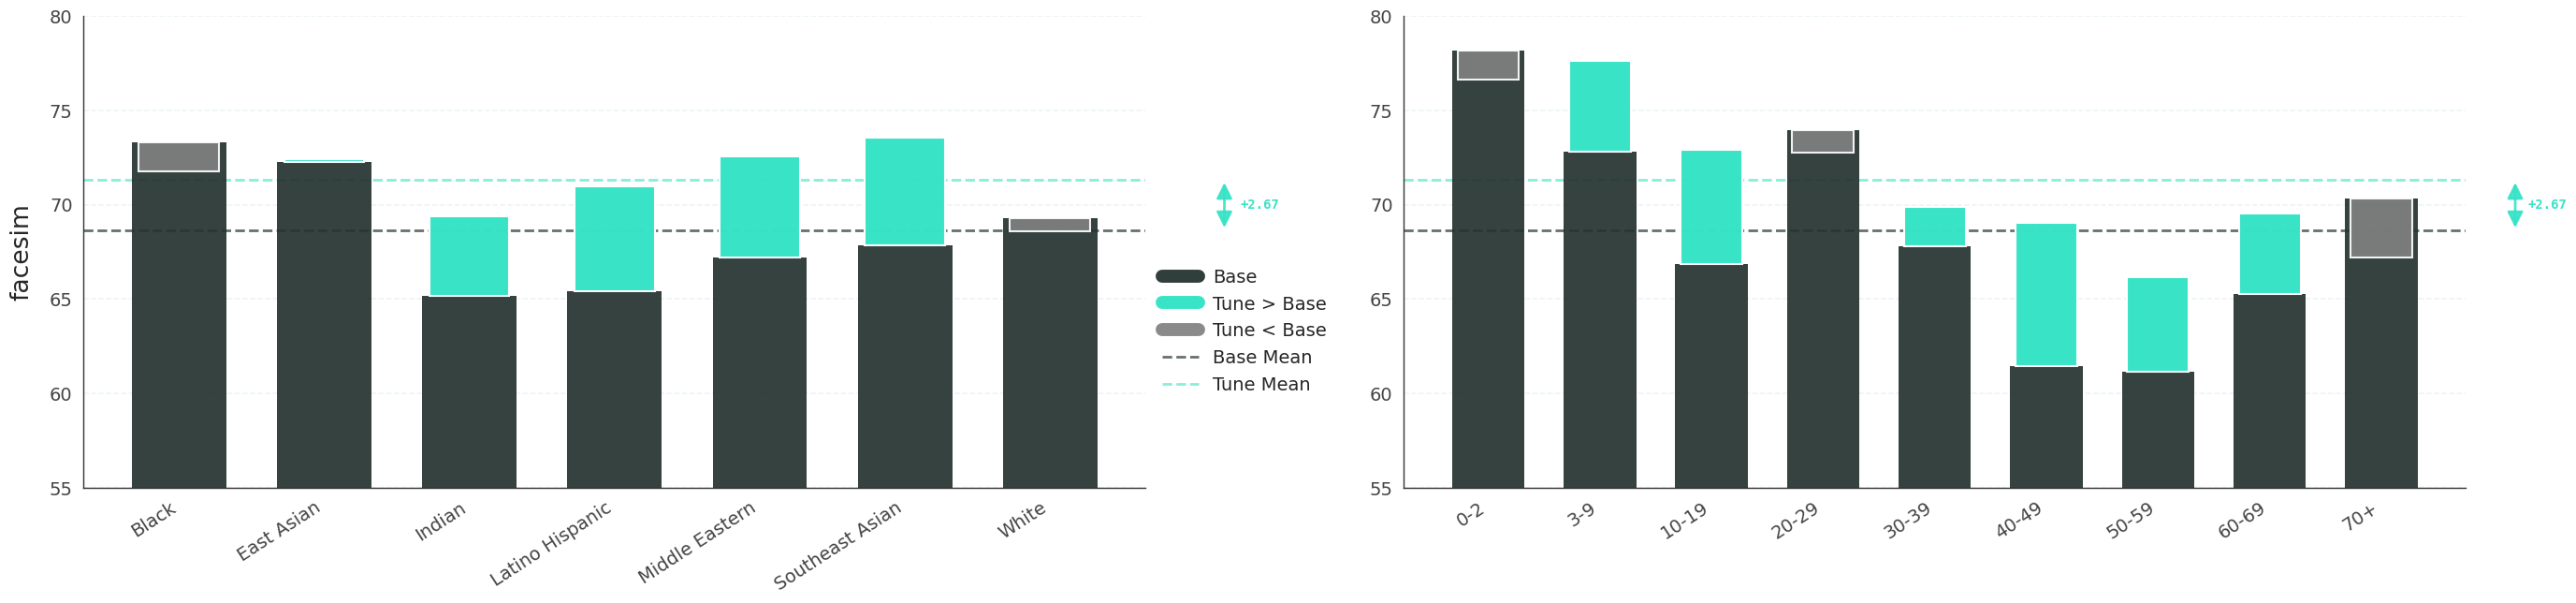
Figure 8 — 그룹별 얼굴 유사도 개선
4. Conclusion & Impact (결론 및 시사점)
이 논문은 ID-Flow로 identity 구성을 데이터 구축 단계에서 직접 제어하는 것이 공정한 human-centric model을 만드는 효과적인 수단임을 보였습니다. 그 결과물인 SynthFaces는 Caption과 ID-grouped 구조를 갖춘 균형 잡힌 대규모 합성 데이터셋입니다. 이 데이터로 학습한 모델은 personalized generation, Face Recognition, demographic VQA 세 가지 downstream task 모두에서 쓸 만한 성능을 유지하면서 subgroup parity를 개선했습니다.
시사점
- 모델 구조를 바꾸지 않고 데이터 단계에서 fairness를 다룰 수 있음을 보여 주며, 이 데이터셋은 재사용 가능한 자원으로 쓰일 수 있습니다.
- 실제 인물 이미지를 공개하지 않으므로 동의 문제로 데이터셋이 철회되는 상황에 대한 대안이 될 수 있습니다.
한계 (저자들이 직접 밝힌 내용)
- ID-Flow는 실제 ArcFace embedding으로 학습되므로 formal privacy guarantee는 주장하지 않습니다. 실제 identity와의 분리는 ID-NonLeak으로 경험적으로만 검증했습니다.
- Arc2Face와 Flux의 bias를 물려받을 수 있습니다.
- synthetic-to-real distribution gap이 있습니다.
- 향후 과제로 편향 가능성이 있는 face encoder 의존도를 줄이는 것과, 실제·합성 데이터를 섞은 hybrid balancing 전략을 제시했습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Poplar: A Scalable Pipeline for Human-Centric Image Dataset Synthesis
- [논문리뷰] Geometry-Aware Image Flow Matching
- [논문리뷰] WithEveryone: Unified Planning and Identity Grounding for Group Image Generation
- [논문리뷰] StyleID: A Perception-Aware Dataset and Metric for Stylization-Agnostic Facial Identity Recognition
Review 의 다른글
- 이전글 [논문리뷰] SwarmEvolve: Latent Agent Swarms for Evolutionary Discovery and Optimization
- 현재글 : [논문리뷰] SynthFaces: Balanced Large Scale Human Dataset
- 다음글 [논문리뷰] TailSteer: Trajectory-Tail Steering for Drift-Resistant Multi-turn Image Editing
댓글