[논문리뷰] SplatAnything: Gaussian Spacing Normalization for Feed-forward 3DGS across Arbitrary Scenes
링크: 논문 PDF로 바로 열기
저자: Hao Yu, Zhenwei Wang, Yongzhen Hu, Yuning Gong, Junta Wu, Xiaowei Zhou, Hujun Bao, Tengfei Wang, Chunchao Guo, Sida Peng (Zhejiang University, Tencent Hunyuan, Causa Robotics)
1. Key Terms & Definitions (핵심 용어 및 정의)
- Gaussian Spacing: Per-pixel Gaussian prediction에서는 이웃한 pixel을 back-projection한 점이 각각 Gaussian center가 됩니다. 이 center들 사이의 공간적 간격을 Gaussian Spacing이라고 부릅니다. Pinhole model과 locally constant-depth 가정을 두면 $d_i(\mathbf{u}) \approx D_i(\mathbf{u})/\sqrt{f_x f_y}$로 근사됩니다. Surface를 빈틈없이 덮으려면 Gaussian scale이 이 값과 비슷해야 합니다.
- RDNorm (Radial Distance Normalization): 복원된 3D point와 reference camera origin 사이의 평균 radial distance로 scene 전체를 global rescale하는 방식입니다. 기존 geometry foundation model과, 이를 기반으로 한 feed-forward 3DGS가 일반적으로 사용합니다.
- GSNorm (Gaussian Spacing Normalization): 이 논문이 제안하는 normalization입니다. 모든 valid pixel의 Gaussian Spacing을 구한 뒤 그 median $s_g$를 scene-level normalization factor로 삼고, geometry·depth·camera translation을 $s_g$로 나눕니다. 그 결과 대표 Gaussian Spacing은 1로 canonicalize되고, local spacing의 상대적 변화는 그대로 유지됩니다.
- GSHead / Gaussian Backbone: Gaussian Backbone은 WorldMirror 2.0의 geometry backbone에서 초기화한 뒤 fine-tune한 network입니다. GSHead는 처음부터 학습하는 lightweight head로, 각 pixel의 opacity, rotation, scale, SH coefficient를 예측합니다.
- Extrapolated Viewpoint: Input view와의 overlap이 낮은(0.2–0.6) target view를 말하며, 이 논문 benchmark가 특히 강조하는 평가 조건입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문이 다루는 핵심 문제는 RDNorm space에서 Gaussian attribute를 예측하면 Gaussian-scale supervision이 모호해진다는 점입니다. RDNorm은 global radial statistic만 canonicalize할 뿐 Gaussian Spacing을 직접 normalize하지 않습니다. 그래서 scene scale이나 camera configuration(focal length, resolution 등)이 달라지면, 시각적으로 비슷한 영역이라도 Gaussian Spacing이 크게 달라집니다 [Figure 2]. 저자들에 따르면 RDNorm을 적용한 뒤에도 scene category 간 median Gaussian Spacing이 최대 **4.5×**까지 차이가 납니다. 이 때문에 비슷한 local observation이 서로 다른 Gaussian-scale target에 대응하게 됩니다. Predictor가 작은 scale 쪽으로 치우치면 spacing이 큰 영역에서 hole이 생기고, 큰 scale 쪽으로 치우치면 촘촘하게 sampling된 영역에서 over-smoothing이 일어납니다 [Figure 7].
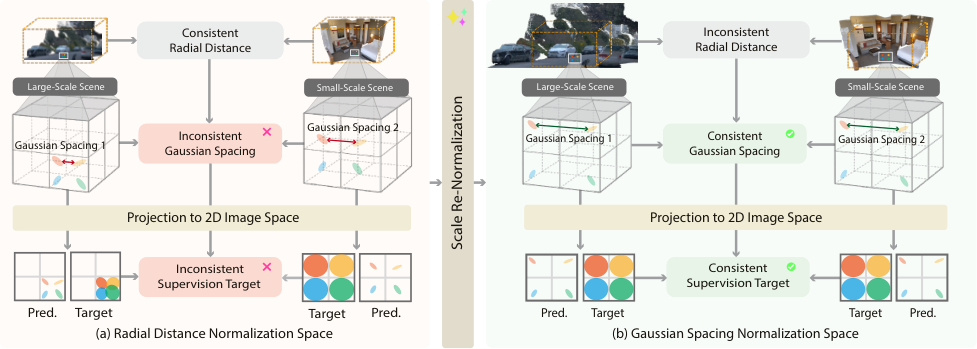
Figure 2 — RDNorm vs GSNorm
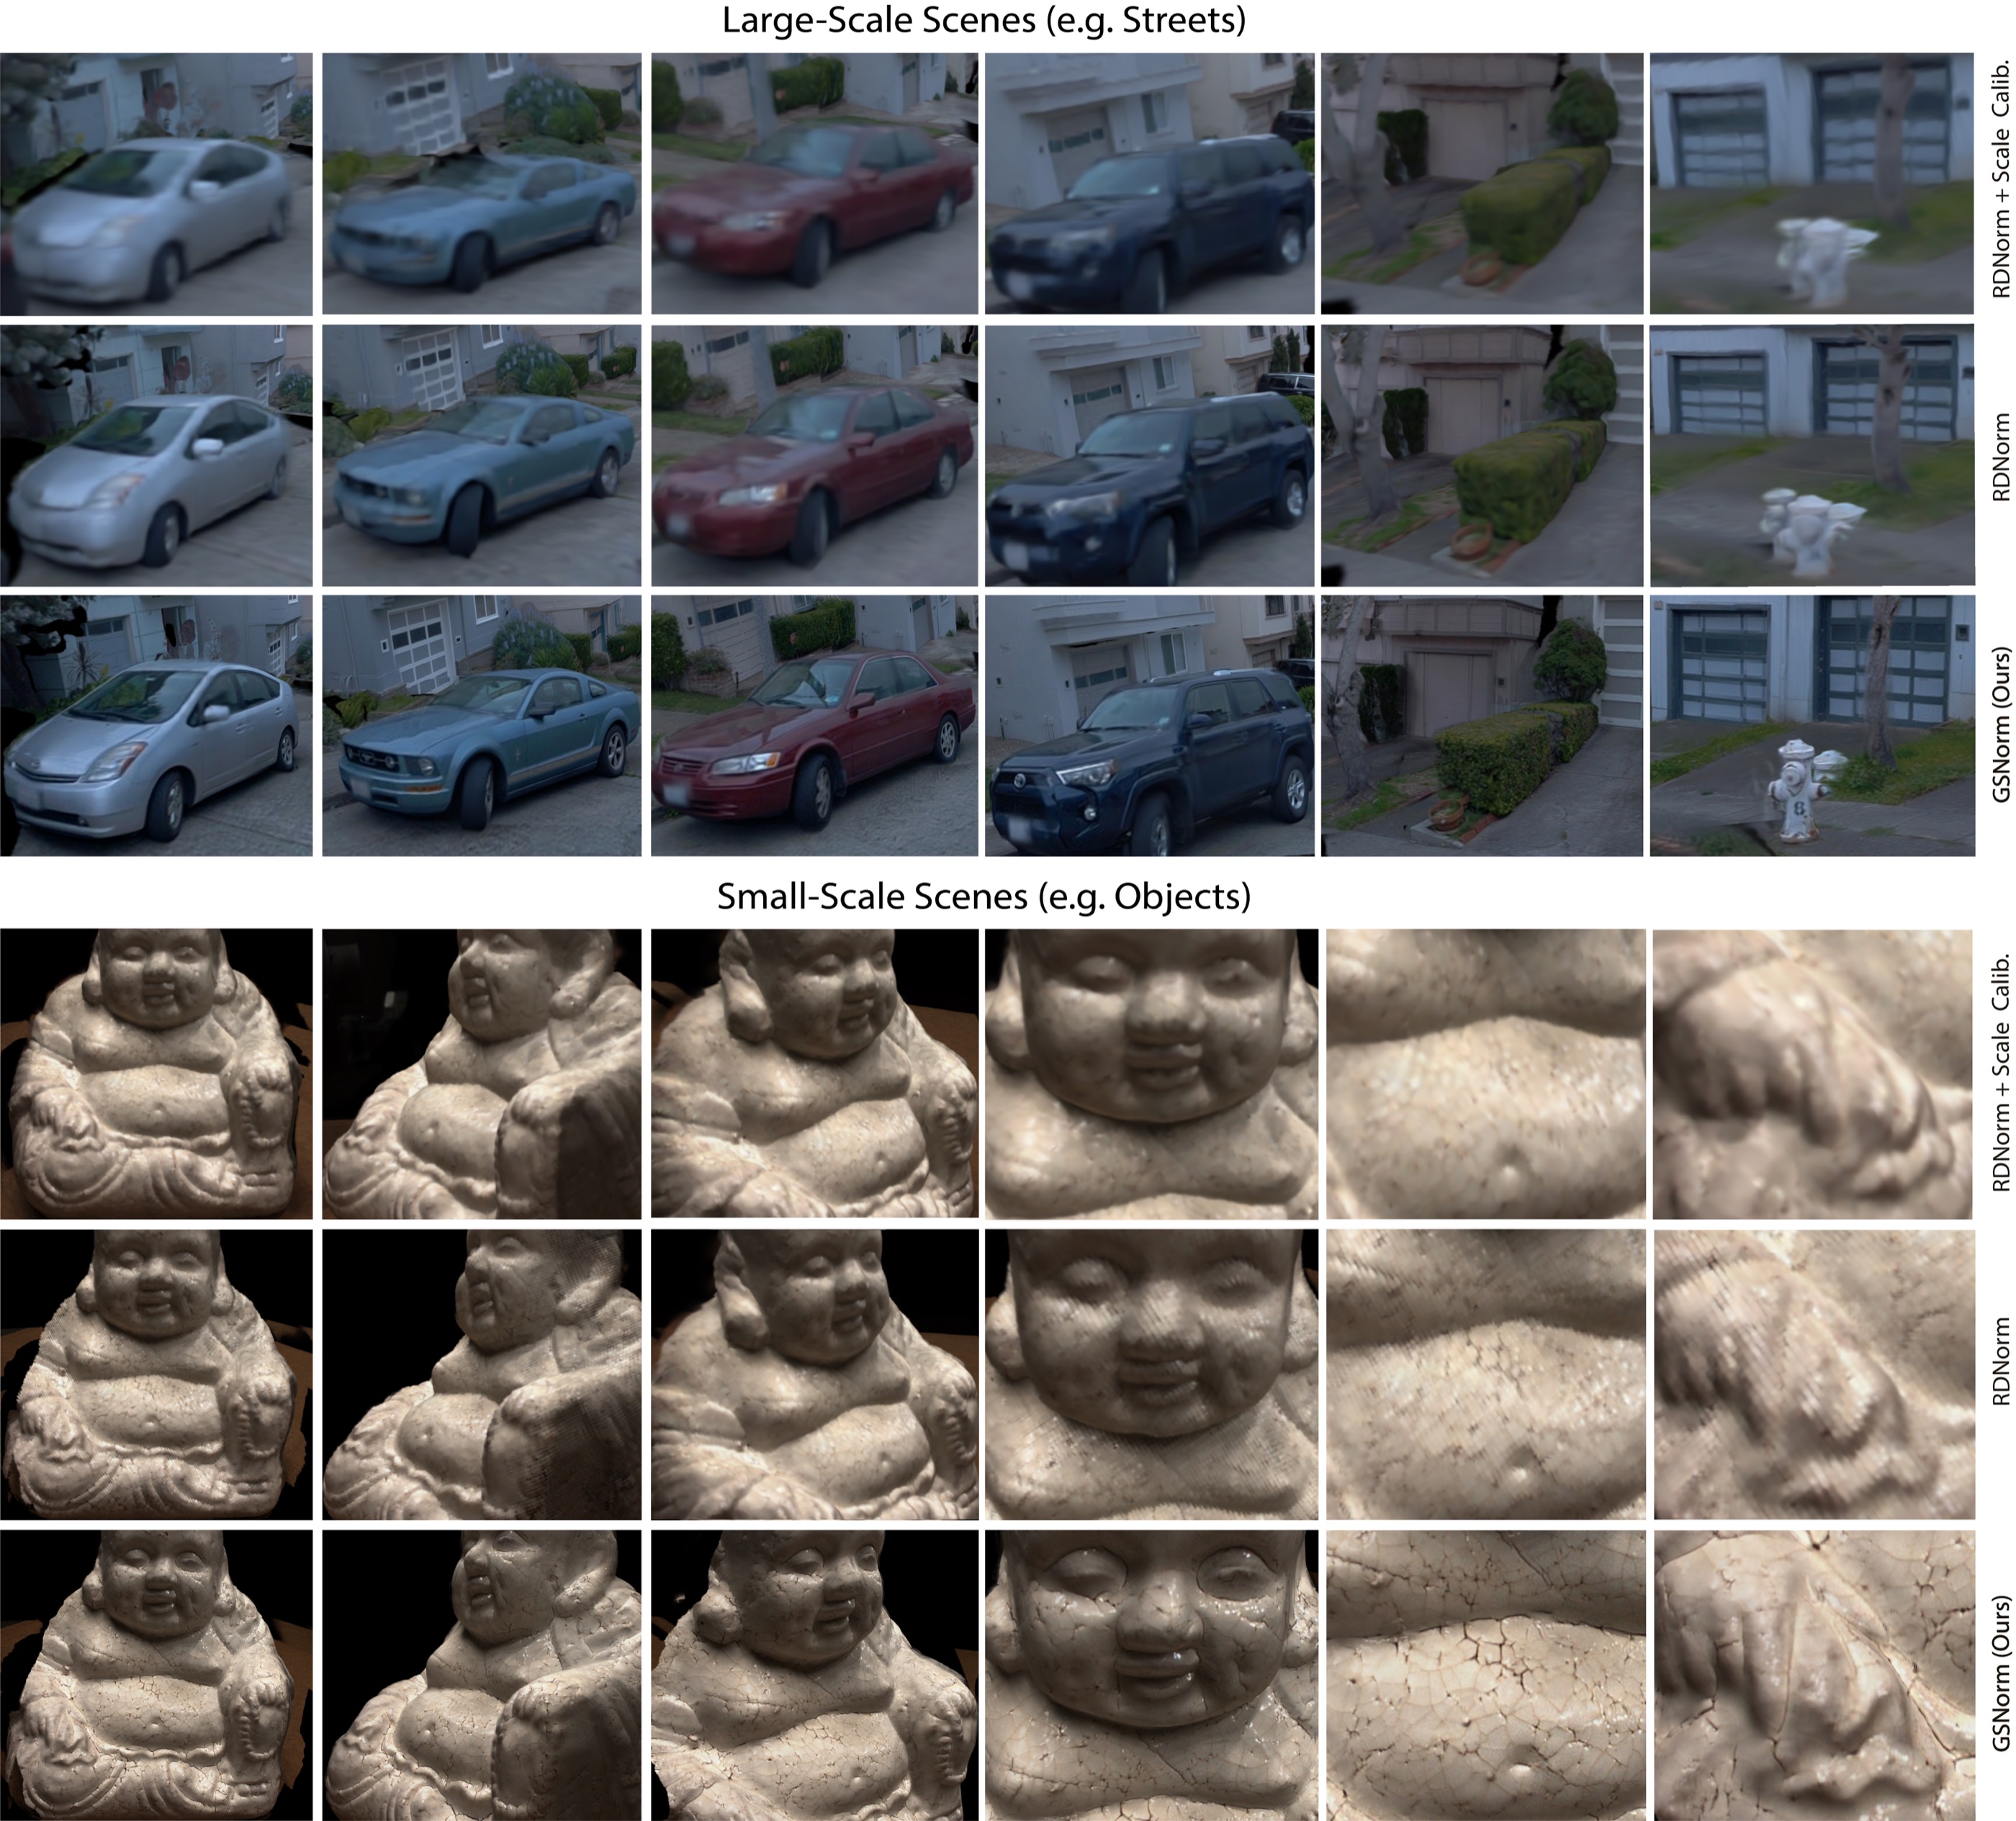
Figure 7 — GSNorm ablation
기존 접근의 한계는 크게 두 가지입니다.
- DA3-GS, Mirror2-GS, AnySplat 등 geometry foundation model 기반 방법은 backbone의 RDNorm space를 그대로 물려받습니다.
- pixelSplat, DepthSplat, ReSplat 등은 geometric accuracy가 부족해 큰 viewpoint extrapolation에서 성능이 떨어집니다.
여기에 더해, 기존 evaluation protocol은 학습 domain과 가까운 데이터와 interpolated view 위주라서 cross-scene generalization을 충분히 검증하기 어렵습니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 Gaussian prediction 이전 단계에서 coordinate space를 GSNorm으로 바꾸는 SplatAnything을 제안합니다 [Figure 3].
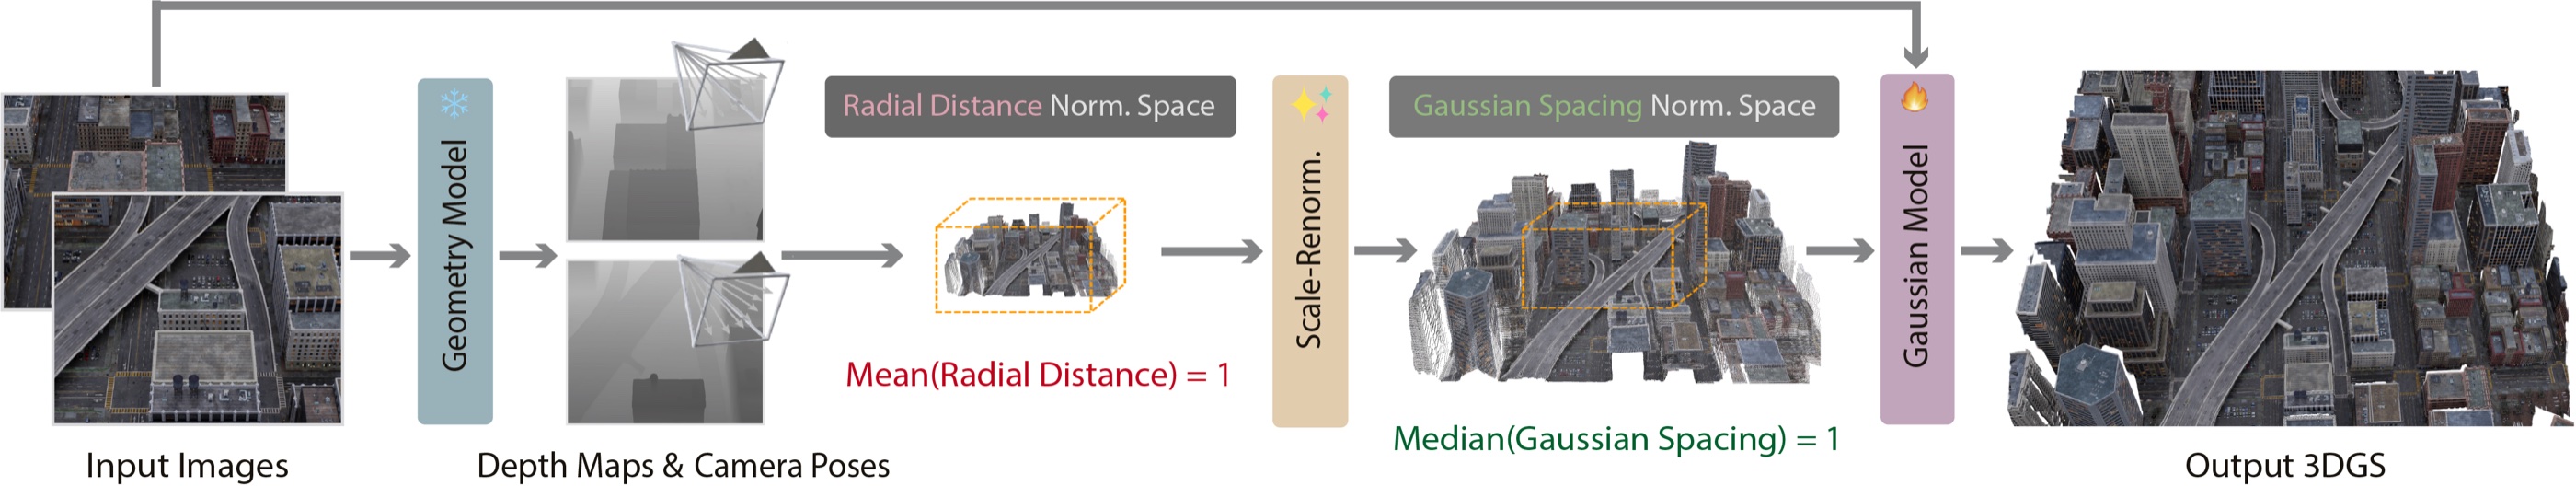
Figure 3 — 전체 아키텍처
파이프라인
- Frozen WorldMirror 2.0이 multi-view depth, intrinsics, camera pose를 추정합니다. Camera parameter 입력은 optional입니다.
- RDNorm space에 있는 depth와 translation을 $s_g = \mathrm{median}(D_i(\mathbf{u})/\sqrt{f_{x,i}f_{y,i}})$로 나눠 Gaussian-spacing-normalized space로 옮깁니다.
- Rescale된 depth를 unprojection하고, 각 pixel의 3D point를 Gaussian center로 사용합니다.
- 나머지 attribute는 Gaussian Backbone과 GSHead가 예측합니다.
Median은 positive scaling에 대해 equivariant하기 때문에 normalization factor를 closed-form으로 바로 구할 수 있습니다. Median을 쓰므로 outlier에도 robust합니다.
학습 설정
- Loss: MSE + LPIPS (λ=1:1)
- 규모: 64 NVIDIA H20 GPU, 20,000 iteration
- Input: 4–32 view, resolution은 504–1024 범위에서 동적으로 변경
Benchmark: 저자들은 다음 조건을 포함하는 cross-dataset benchmark를 새로 구축했습니다.
- Dataset 7종: ScanNet, NRGBD, DL3DV, Tanks & Temples, Mip-NeRF 360, ETH3D, DTU
- Input view 수: 1/4/8/16/32/64
- Input–target overlap 0.2–0.6의 extrapolated view
- Resolution 약 480p–1K
정량 결과 (4–64 view 평균, 지표는 DISTS / LPIPS이며 낮을수록 좋음)
- w/o Pose
- DTU: SplatAnything 0.229 / 0.483. 가장 강한 baseline들(Mirror2-GS DISTS 0.347, DA3-GS LPIPS 0.582) 대비 큰 차이로 앞섭니다.
- Tanks & Temples: 0.252 / 0.299로 Mirror2-GS(0.306 / 0.351)보다 우수합니다.
- w/ Pose (pose-conditioned)
- DTU: 0.184 / 0.364로 Mirror2-GS(0.315 / 0.532)보다 크게 개선됩니다.
- ETH3D: DISTS 0.133을 기록했습니다.
- 예외
- ETH3D LPIPS: w/o Pose에서 QuerySplat(0.031), YoNoSplat(0.033)이 Ours(0.049)보다 낮고, w/ Pose에서도 ReSplat(0.027)이 Ours(0.037)보다 낮습니다.
- Single-view 설정: ScanNet, NRGBD, Mip-NeRF 360에서는 SHARP가 더 좋은 수치를 보입니다.
- 따라서 "모든 설정에서 최고"가 아니라 대부분의 설정에서 최고 성능이라고 보는 것이 정확합니다.
Normalization-space ablation (동일 architecture·학습 조건)
- 8 view: GSNorm은 DISTS 0.196 / LPIPS 0.237로, RDNorm(0.223 / 0.272)을 일관되게 앞섭니다.
- 64 view: GSNorm 0.217 / 0.229, RDNorm 0.224 / 0.250입니다.
- RDNorm + Scale Calibration: 예측된 scale을 사후에 median spacing에 맞춰 rescale하는 방식인데, 오히려 RDNorm보다 더 나빴습니다(8 view 기준 0.252 / 0.308).
- 저자들은 이를 근거로, 사후 보정으로는 supervision ambiguity를 해결할 수 없고 prediction 이전에 space를 canonicalize해야 한다고 주장합니다 [Figure 7].
4. Conclusion & Impact (결론 및 시사점)
이 논문의 결론은, feed-forward 3DGS의 cross-scene generalization을 가로막는 주요 bottleneck이 RDNorm이 만드는 Gaussian-scale supervision ambiguity이며, GSNorm이라는 단순한 normalization 교체로 이를 상당 부분 완화할 수 있다는 것입니다. SplatAnything은 7개 dataset과 다양한 sparsity·extrapolation 조건에서 대부분 state-of-the-art 성능을 냈습니다. 특히 scene scale 변화가 큰 object-centric(DTU) 장면과 대규모 outdoor 장면에서 개선 폭이 큽니다.
시사점
- 추가 network나 loss 없이 normalization factor 하나만 바꾸면 되므로, geometry foundation model 위에 Gaussian head를 얹는 기존 pipeline 전반에 쉽게 적용할 수 있습니다.
- 새로 구축한 extrapolation 중심 benchmark는 향후 feed-forward 3DGS 평가 protocol의 기준으로 활용될 수 있습니다.
저자들이 밝힌 한계
- Geometry foundation model의 prior에 의존하므로, geometry를 안정적으로 복원하기 어려운 극도로 sparse한 input에서는 성능이 떨어질 수 있습니다.
- 관측되지 않은 영역에는 hole이 남습니다. 저자들은 이를 generative prior로 보완하는 방향을 후속 과제로 제시합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] InfiniSplat v2: Analyzing and Improving Feed-Forward 3DGS from Any Views
- [논문리뷰] 2Xplat: Two Experts Are Better Than One Generalist
- [논문리뷰] FineSplat: Fine Patches, Local Groups, Detailed Splats
- [논문리뷰] F4Splat: Feed-Forward Predictive Densification for Feed-Forward 3D Gaussian Splatting
- [논문리뷰] VolSplat: Rethinking Feed-Forward 3D Gaussian Splatting with Voxel-Aligned Prediction
Review 의 다른글
- 이전글 [논문리뷰] Sketchpad: certified exact arithmetic with a small vision-language model
- 현재글 : [논문리뷰] SplatAnything: Gaussian Spacing Normalization for Feed-forward 3DGS across Arbitrary Scenes
- 다음글 [논문리뷰] Static Recovery Is Not Dynamic Stability: Dynamics-Aware Benchmarking of Protein Motif Scaffolding
댓글