[논문리뷰] Actor, Judge, or Teacher? Understanding Decision Models in Long-Horizon Agents
링크: 논문 PDF로 바로 열기
저자: Haochen Liu, Qianhao Zhu, Zixuan Wang, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Decision Model: question과 context를 받아 자유 텍스트 대신 typed output을 반환하는 pretrained model이다. multiple-choice 질문이면 option 선택과 option별 probability를, yes/no 질문이면 [0,1] score를 낸다. 논문에서는 dedicated model인 JEV, Decider v1.2, GPT Decisions와, general LLM을 Prompting 또는 Constrained readout 방식으로 decision model처럼 쓴 3종을 함께 평가한다.
- Actor / Judge / Teacher: 같은 decision model을 쓰는 세 가지 Role이다. Actor는 다음 action을 직접 고른다. Judge는 이미 기록된 trajectory의 action을 채점한다. Teacher는 학습 중인 policy의 rollout action을 채점하고, 이 score를 GRPO의 step-level supervision으로 쓴다.
- Prefix vs. Hindsight: Judge에게 보여 주는 context의 범위다. Prefix는 해당 action까지의 trajectory만 보여 주고, Hindsight는 outcome label만 가린 채 전체 trajectory를 보여 준다.
- Value vs. Progress: Judge에게 던지는 질문의 종류다. Value는 "이 action 이후 task가 성공할 것인가"를, Progress는 "이 action이 goal 달성에 도움이 되었는가"를 묻는다.
- Milestone / No-op action: Milestone action은 subgoal 하나를 달성하는 action이고, No-op action은 environment와 observation을 바꾸지 못하는 action이다. Judge의 변별력을 측정하는 기준으로 쓰인다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문의 핵심 질문은 "Actor로서 성능이 낮은 decision model도 좋은 Teacher가 될 수 있는가, 그리고 어떤 query가 그것을 가능하게 하는가"이다. GRPO 같은 outcome reward 기반 학습에서는 trajectory 안의 모든 action이 같은 credit을 받는다. 반대로 step-level judgment를 얻으려면 environment마다 step label을 만들거나, action마다 LLM judge를 호출해야 해서 비용이 크다. 그런데 기존 연구는 decision model을 주로 Actor로만 평가했고, 이 역할에서 decision model은 prerequisite subgoal을 건너뛰거나 subgoal 순서를 틀리는 실패를 자주 보였다 [Figure 3]. 저자들은 Actor 성능만 보고 decision model의 쓸모를 판단하면 평가자 또는 supervisor로서의 가치를 놓친다고 보고, 세 Role을 같은 task 위에서 체계적으로 비교한다 [Figure 1].
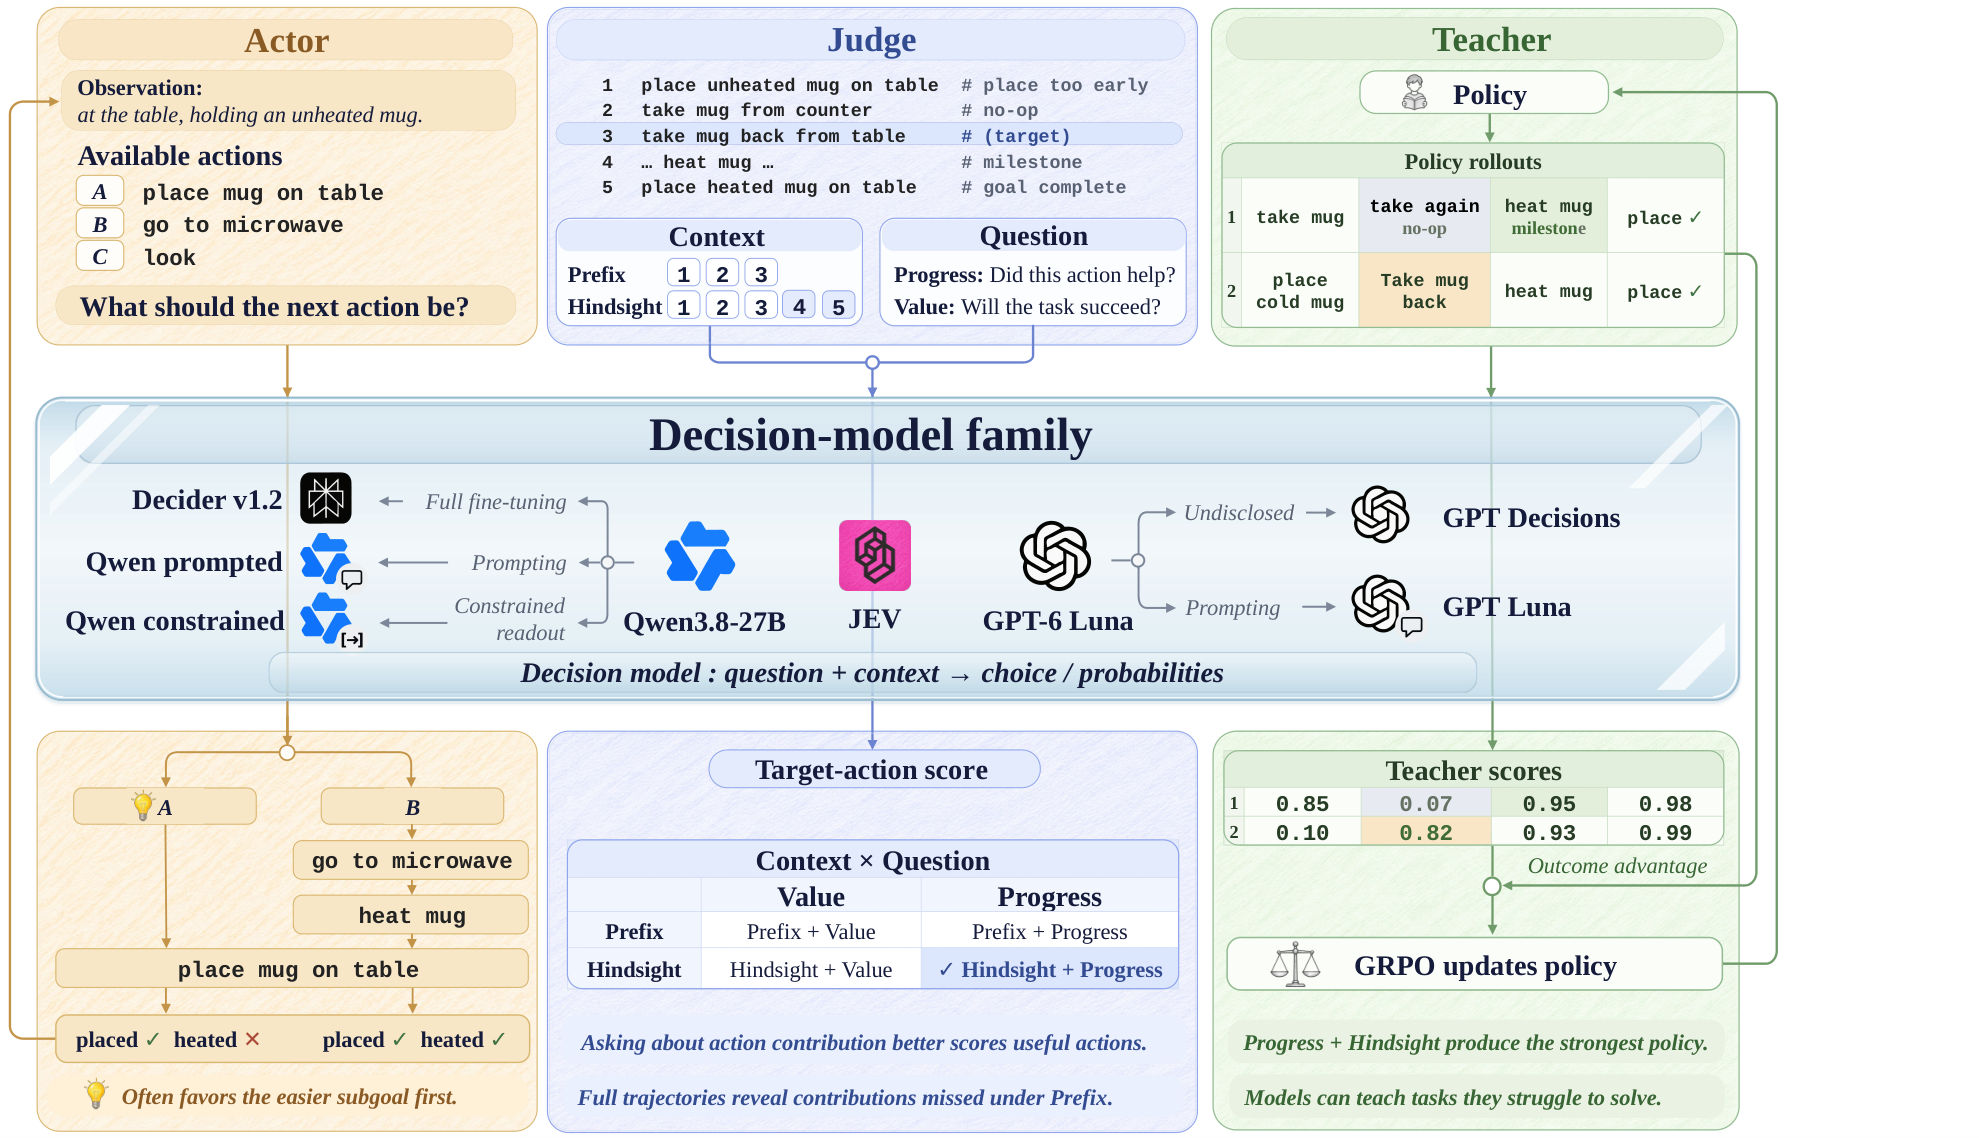
Figure 1 — 세 Role 개요
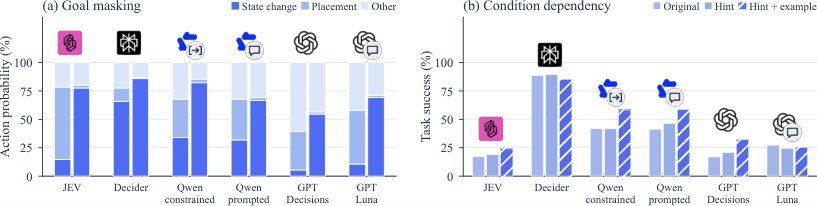
Figure 3 — Actor 실패 분석
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 하나의 decision model을 세 Role로 query하면서 한 번에 한 가지 factor(goal, question, context)만 바꾸는 controlled analysis framework를 제안한다 [Figure 1]. 실험 환경은 순서가 정해진 subgoal이 포함된 ALFWorld와 WebShop이다. ALFWorld에서는 순서 제약이 없는 Pick2 task와 순서 의존성이 있는 Clean/Heat/Cool task를 비교한다. Teacher Role에서는 rollout이 끝난 뒤 JEV가 각 action을 s_{i,t}=D(g,τ_i,t)로 채점한다. 이 score를 rollout group 안에서 mean-centering하고(std normalization은 하지 않음) λ=0.5 가중치로 GRPO outcome advantage에 더한다. Teacher는 학습 동안 고정되어 있고 test time에는 쓰이지 않는다.
- Actor 결과: 6개 모델 모두 dependency가 있는 task에서 성능이 크게 떨어진다. JEV의 성공률은 Pick2에서 70.8%지만, Clean/Heat/Cool 각 유형에서는 최대 18.8%에 그친다. 쉬운 subgoal을 goal에서 빼면 JEV가 required state change에 두는 probability가 14.6% → 77.6%로 오른다 [Figure 3]. 즉 모델은 필요한 단계를 알고 있지만, 쉬운 subgoal에 끌려가는 것이다. dependency hint를 추가해도 성공률 변화는 −2.8%~+5.2%에 불과했다.
- Judge 결과: Hindsight context를 주면 JEV의 평균 contribution score가 0.41 → 0.59로 오른다. 질문도 중요하다. Value 질문에서는 milestone, other, no-op action이 비슷한 score(0.632/0.604/0.577)를 받지만, Progress 질문에서는 0.659/0.440/0.298로 벌어진다. 같은 trajectory 안에서 milestone과 no-op의 score gap은 Progress가 0.36, Value가 0.05이고, Milestone Recall@R도 Progress가 8.0~16.0%p 높다 [Figure 5]. Disclosed base LLM이 있는 두 dedicated model(Decider v1.2, GPT Decisions)은 같은 질문을 받은 각자의 base LLM보다 더 정확하게 판단했고, score당 비용도 28~43% 낮았다.
- Teacher 결과: Hindsight + Progress 조합이 Qwen2.5-1.5B policy의 성공률을 가장 크게 올렸다. ALFWorld에서는 GRPO 대비 72.8% → 82.9%, WebShop에서는 56.8% → 71.4%다. 반면 Hindsight + Value는 ALFWorld에서 69.3%로 GRPO보다도 낮았다. 7B policy에서도 ALFWorld 77.6% → 83.8%, WebShop 66.1% → 73.6%로 개선이 이어졌다. 이렇게 학습한 1.5B policy는 GRPO로 학습한 7B policy를 두 environment 모두에서 넘어섰다. JEV 자신은 Actor로서 같은 ALFWorld task의 42.9%만 해결하는데도 이런 결과가 나왔다.
- Cost: 학습 run 하나당 query 비용은 22~30 USD 수준이다.
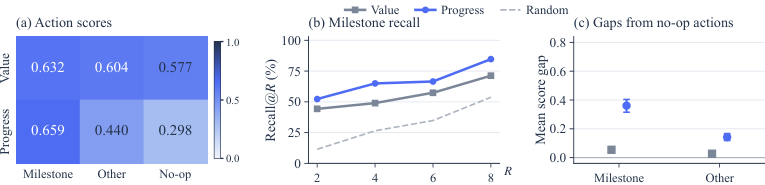
Figure 5 — Value vs Progress
4. Conclusion & Impact (결론 및 시사점)
이 논문은 Actor로서 성능이 낮은 decision model도 좋은 Teacher가 될 수 있다고 결론짓는다. 이유는 episode가 끝난 뒤 action을 judge하면, Actor가 미리 예측해야 했던 consequence를 직접 볼 수 있기 때문이다. 다만 이 이점은 outcome(Value)이 아니라 action별 기여(Progress)를 물을 때에만 나타나며, Actor가 가장 취약한 dependent subgoal task에서 가장 크게 나타난다.
실무적 시사점은 세 가지다.
- Supervisor 선택 기준: frozen judge를 고를 때는 acting ability가 아니라, 기록된 trajectory를 얼마나 잘 judge하는지로 평가해야 한다. 비싼 RL run 전에 이 방식으로 judge와 question 조합을 미리 걸러낼 수 있다.
- 저비용 step-level supervision: step label이나 별도로 학습한 critic 없이도 저렴한 step-level supervision을 얻을 수 있다. 이는 Process Reward Model과 credit assignment 연구에 실용적인 대안이 된다.
- 활용 방식: decision model은 prefix만 볼 수 있는 online action filtering보다, episode가 끝난 뒤 action을 채점하는 RL training 용도에 더 적합하다.
이 결과는 weak-to-strong generalization과도 맞닿아 있다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] JEV-as-a-Judge: Accept When Confident, Escalate When Unsure
- [논문리뷰] DRACO: Fine-Grained Credit Assignment with Dynamic Rubrics for Long-Horizon Agent Training
- [논문리뷰] Do We Need an LLM to Know Why Sources Conflict? Decision Models for Knowledge-Conflict Typing in RAG
- [논문리뷰] Turns Matter: Advancing Streaming Video RL via Turn-Level Credit
- [논문리뷰] Are Dense Rewards Worth Their Tokens in GRPO?
Review 의 다른글
- 이전글 [논문리뷰] A frontier machine intelligence for human neuroimaging
- 현재글 : [논문리뷰] Actor, Judge, or Teacher? Understanding Decision Models in Long-Horizon Agents
- 다음글 [논문리뷰] Agent-R^2: Scaling Agents for Realistic Productivity Work via Real-Source Data Synthesis
댓글