[논문리뷰] On the Design of Hyper-Connections: Simplification, Stability, and Scalability
링크: 논문 PDF로 바로 열기
저자: Xiangdong Zhang, Xiaohan Qin, Sunan Zou, et al. (Shanghai Jiao Tong University, Xiaohongshu Dots Studio, Peking University, Nanyang Technological University 등)
1. Key Terms & Definitions (핵심 용어 및 정의)
- Hyper-Connections (HC) / mHC: HC는 하나의 residual stream을 width가 C인 n개의 stream으로 확장한 구조입니다. 각 sublayer는 learned read gate(h^pre), write gate(h^post), residual mixing 행렬(H^res)로 정보를 route합니다. mHC(Manifold-Constrained HC)는 학습 안정성을 위해 Sinkhorn normalization으로 H^res를 doubly stochastic 행렬에 가깝게 제약한 변형입니다.
- identityHC: mHC에서 residual mixing을 identity(H^res = I)로 바꾼 변형입니다.
- SimpleHC: 이 논문이 제안하는 구조입니다. residual mixing을 없애고 learned read/write gate만 남깁니다. 업데이트 식은 X_{l+1} = X_l + h^post·o^T입니다. 여기에 Shared Memory Access라는 실행 방식을 결합합니다.
- Shared Memory Access: 연속된 K개 sublayer가 하나의 group-entry state X_L을 공유하는 실행 방식입니다. layer-specific gate는 이 공유 상태에서 한꺼번에 생성되고, read는 batch로 묶이며, write는 group 경계에서 한 번만 수행됩니다(deferred write).
- Scalar Corrections: mixing이 없으면 업데이트가 단순히 더해지는 additive 구조가 됩니다. 이 성질을 이용해, 앞선 sublayer 출력이 뒤 sublayer 입력에 기여하는 부분을 scalar 계수 d_{j,k} = (h̄_j^pre)^T h̄_k^post로 정확히 복원하는 기법입니다. 중간 nC 차원 state를 메모리에 만들 필요가 없습니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문의 핵심 문제는 HC 계열 구조의 구성 요소가 충분히 이해되지 않았고 training overhead가 크다는 점입니다. 이를 해결하기 위해 저자들은 더 단순하면서도 품질과 안정성을 유지하는 HC 설계를 찾습니다.
- 기존 방식의 overhead: mHC는 frontier 언어 모델에 채택되고 있지만, 효율적인 구현을 써도 vanilla residual 대비 End-to-End training time이 7%–27% 늘어납니다. 추가되는 FLOPs는 1% 미만인데도 그렇습니다.
- 원인은 memory traffic: 매 sublayer마다 n개 stream 전체(nC 원소)를 반복해서 read/write합니다. gate 생성, 입력 aggregation, 업데이트 전파를 위해서입니다. 이 비용은 FLOPs 지표에 잡히지 않습니다.
- 구성 요소의 역할이 불명확: read gate, write gate, residual mixing이 각각 품질에 얼마나 기여하는지 체계적으로 분석되지 않았습니다. 특히 Sinkhorn 제약이 실제로 얻는 이득도 검증되지 않았습니다.
- 연구 질문: 저자들은 "더 단순한 HC 설계로 실행 비용을 줄이면서 대규모에서 모델 품질과 training stability를 유지할 수 있는가?"를 묻습니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
SimpleHC는 두 가지 단순화를 결합합니다. 구조 측면에서는 residual mixing을 제거하고, 실행 측면에서는 Shared Memory Access를 도입합니다.
구성 요소 분석 (15B-A1B MoE)
- Learned read/write gating(mixing 없음)과 unconstrained mixing(gate 고정)은 각각 독립적으로 효과적인 그룹을 이룹니다. 어느 쪽이든 단독으로 mHC와 비슷한 성능을 냅니다.
- read/write gate만 학습: Avg 55.4
- fixed gate + unconstrained mixing: 56.0
- mHC: 55.0
- Sinkhorn 제약은 mixing의 이득을 상쇄합니다.
- unconstrained mixing: 56.2
- Sinkhorn: 55.0
- identity: 55.4
- 그런데도 unconstrained mixing을 택하지 않은 이유가 있습니다. residual 행렬 곱이 depth를 따라 누적되면서 신호가 증폭되거나 감쇠할 위험이 있기 때문입니다. 그래서 저자들은 learned read/write gate와 identity transition 조합을 minimal effective structure로 선택했습니다.
Shared Memory Access
- K=4 sublayer(Transformer block 2개)마다 group-entry state 하나에서 모든 layer-specific gate를 생성합니다.
- base read는 한 번의 scan으로 처리하고, 앞선 출력의 기여는 scalar corrections로 반영합니다.
- 업데이트는 group 경계에서 fused kernel 하나로 write-back합니다.
- 결과적으로 sublayer당 memory traffic이 fused mHC의 18C에서 9C로 절반이 됩니다. K=2, 4, 8, 16 중에서는 K=4일 때 traffic이 가장 낮습니다.
- 이 실행 방식은 같은 group-entry gate를 쓰는 순차 실행과 algebraically equivalent합니다.
- 구현에는 DeepGEMM과 Triton 기반 전용 kernel을 사용했습니다.
- forward: grouped read, fused correction
- backward: cross-sublayer gradient 재사용, token-packed Tensor Core reduction
Ablation 결과
- K=4에서 gate를 하나로 재사용하면 Avg가 55.0 → 53.5로 떨어집니다.
- scalar corrections를 제거하면 loss가 1.660 → 1.705로 크게 나빠집니다. 따라서 layer-specific gate와 corrections는 모두 필수입니다.
- sublayer마다 gate 패턴은 서로 다르지만, group-entry state로부터 충분히 예측할 수 있습니다. write gate 예측 MAE는 다음과 같습니다 [Figure 5].
- 학습한 predictor: 0.0103
- frozen teacher gate: 0.0504
- random gate: 0.4086
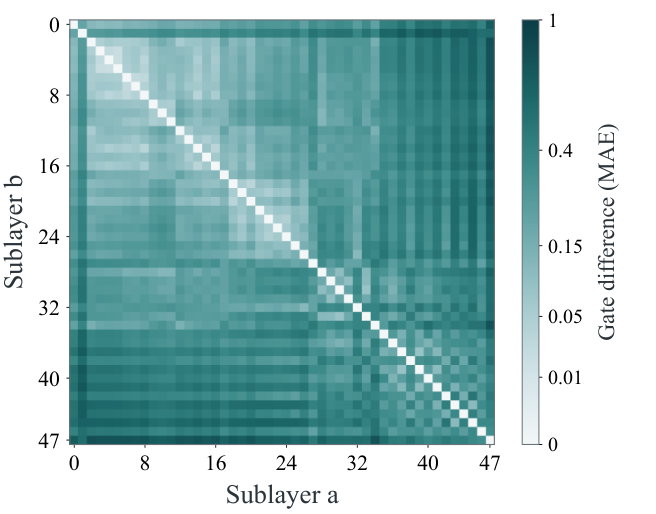
Figure 5 — Gate 변이 분석
대규모 결과 (30B-A2B MoE, 14개 benchmark)
- Loss는 1.561로 mHC, identityHC와 같습니다.
- 평균 점수는 SimpleHC 63.1로 mHC 62.9, identityHC 62.8과 비슷하거나 약간 높습니다.
- MATH(41.5 vs 38.4)와 C3(91.4 vs 89.6)에서는 우세하지만, HumanEval과 GSM8K에서는 뒤처집니다.
Efficiency
- 가장 큰 테스트 width(C=6144)에서 vanilla 대비 training overhead는 2.4%입니다. mHC와 identityHC는 약 7.0%입니다.
- 가장 작은 scale에서는 SimpleHC 6.3%, mHC 26.8%, identityHC 10.1%입니다.
- 또 다른 HC 변형인 xHC는 C=6144에서 27.7%입니다.
- backward를 위해 저장하는 activation storage는 mHC 대비 약 31% 줄어듭니다.
Stability
- 15B 표준 학습에서는 warmup 직후 gradient-norm 변동이 mHC와 identityHC보다 작습니다.
- 230B-A6B 모델을 기준 learning rate의 10배로 stress test한 결과는 다음과 같습니다 [Figure 6].
- mHC: 약 1.9×10^6 수준의 gradient spike 발생
- SimpleHC: bounded gradient norm 유지
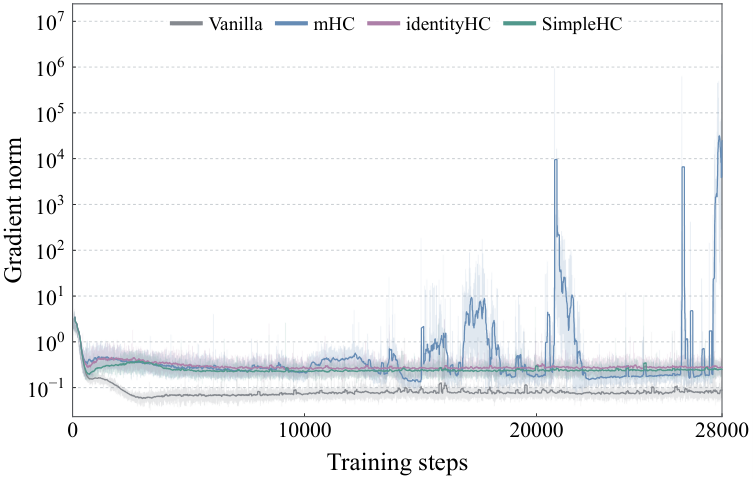
Figure 6 — Stress test 안정성
4. Conclusion & Impact (결론 및 시사점)
SimpleHC는 HC 구조와 실행을 모두 단순화하면서 mHC와 비슷한 품질을 유지하고, training overhead를 7.0%에서 2.4%로 줄였습니다. 저자들은 learned read/write gating을 HC의 minimal effective structure로 규정합니다. unconstrained mixing은 품질을 높이지만 signal propagation 위험이 따른다고 결론짓습니다. 15B와 30B MoE 규모에서 성능이 유지되었고, stress test에서도 안정적이었습니다.
산업계 시사점
- 대규모 LLM 학습에서 FLOPs보다 memory access가 실제 병목이 될 수 있음을 보여줍니다.
- 알고리즘 설계(additive 구조 + scalar corrections)와 kernel 설계를 함께 최적화하는 방향의 사례를 제시합니다.
학계 시사점
- mHC의 Sinkhorn 제약처럼 복잡도를 더하는 설계가 꼭 필요한지 다시 검토하게 만듭니다.
- foundation model 설계에서 simplicity를 추구할 근거를 제공합니다.
한계
- PyTorch 구현에서도 overhead가 가장 낮지만, 최대 효율을 내려면 전용 kernel을 직접 구현해야 해서 engineering 부담이 남습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
Review 의 다른글
- 이전글 [논문리뷰] Learning the Task or Learning the Verifier? Rethinking Criteria Exposure in Embodied Self-Improvement
- 현재글 : [논문리뷰] On the Design of Hyper-Connections: Simplification, Stability, and Scalability
- 다음글 [논문리뷰] Open Vision Banana: A Fully Open Recipe for Generative Visual Perception
댓글