[논문리뷰] Open Vision Banana: A Fully Open Recipe for Generative Visual Perception
링크: 논문 PDF로 바로 열기
저자: Arpit Jadon, Valentinos Pariza, Jona Ruthardt, et al. (Ryousuke Yamada, A. Sophia Koepke, Andrei Bursuc, Yuki M. Asano)
1. Key Terms & Definitions (핵심 용어 및 정의)
- Open Vision Banana (OVB): pretrained image generator를 여러 perception task를 처리하는 단일 모델로 바꾸기 위한 완전 공개 recipe이자 그 결과 모델군입니다. task-specific head 없이 input image와 instruction을 받아 RGB image를 생성합니다. 생성된 이미지는 deterministic readout을 거쳐 예측값으로 변환됩니다.
- RGB Task Modeling / Readout: 각 task의 annotation을 RGB target으로 바꾸는 encoder와, 생성된 이미지를 다시 예측값으로 되돌리는 decoder를 짝지은 구조입니다. 예를 들어 segmentation은 class–color legend를 쓰고, depth는 affine-invariant inverse depth를 grayscale로 표현하며, surface normal은 camera-space 벡터를 RGB channel에 대응시킵니다.
- Legend Ensembling: 학습이 필요 없는 test-time scaling 기법입니다. generation seed는 고정한 채 class–color legend만 바꿔 R번 segmentation을 수행하고, 결과를 per-pixel majority vote로 합칩니다.
- Color Binding Error: region 경계는 올바르게 그렸지만 prompt에서 지정하지 않은 색으로 칠해 class가 잘못 배정되는 오류입니다. 저자들은 이를 region segmentation error와 구분해 분석합니다.
- Zero-shot (ZS) / Non-zero-shot (NZS): ZS 모델은 평가 benchmark 데이터를 학습에 전혀 쓰지 않은 모델입니다. 다만 task 자체는 학습 중에 다룹니다. NZS 모델은 일부 평가 데이터셋의 training split까지 학습에 포함합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문이 다루는 핵심 문제는 Vision Banana가 보여준 "image generator가 곧 generalist perception model"이라는 paradigm을 공개 모델과 공개 데이터만으로 재현할 수 있는지, 그리고 그 성능을 결정하는 design choice가 무엇인지입니다. Vision Banana는 vision task를 conditional image editing으로 정의해 segmentation과 geometry 분야의 specialist에 필적하는 성능을 냈습니다. 그러나 base model(Nano Banana Pro), 데이터, 코드, 구현 세부가 모두 비공개라서 어떤 요소가 성능을 만들었는지 검증할 수 없습니다. 저자들은 color encoding, prompt design, parameter adaptation 범위, task balancing 같은 low-level 선택이 정확도를 크게 좌우한다고 봅니다. 또한 이 선택들은 서로 interaction이 있어서, 개별적으로는 도움이 되는 선택도 조합하면 오히려 성능을 떨어뜨릴 수 있다고 지적합니다. 이에 저자들은 체계적인 ablation(RQ 기반)을 통해 이 design space를 분석하는 open recipe를 제시합니다 [Figure 1].
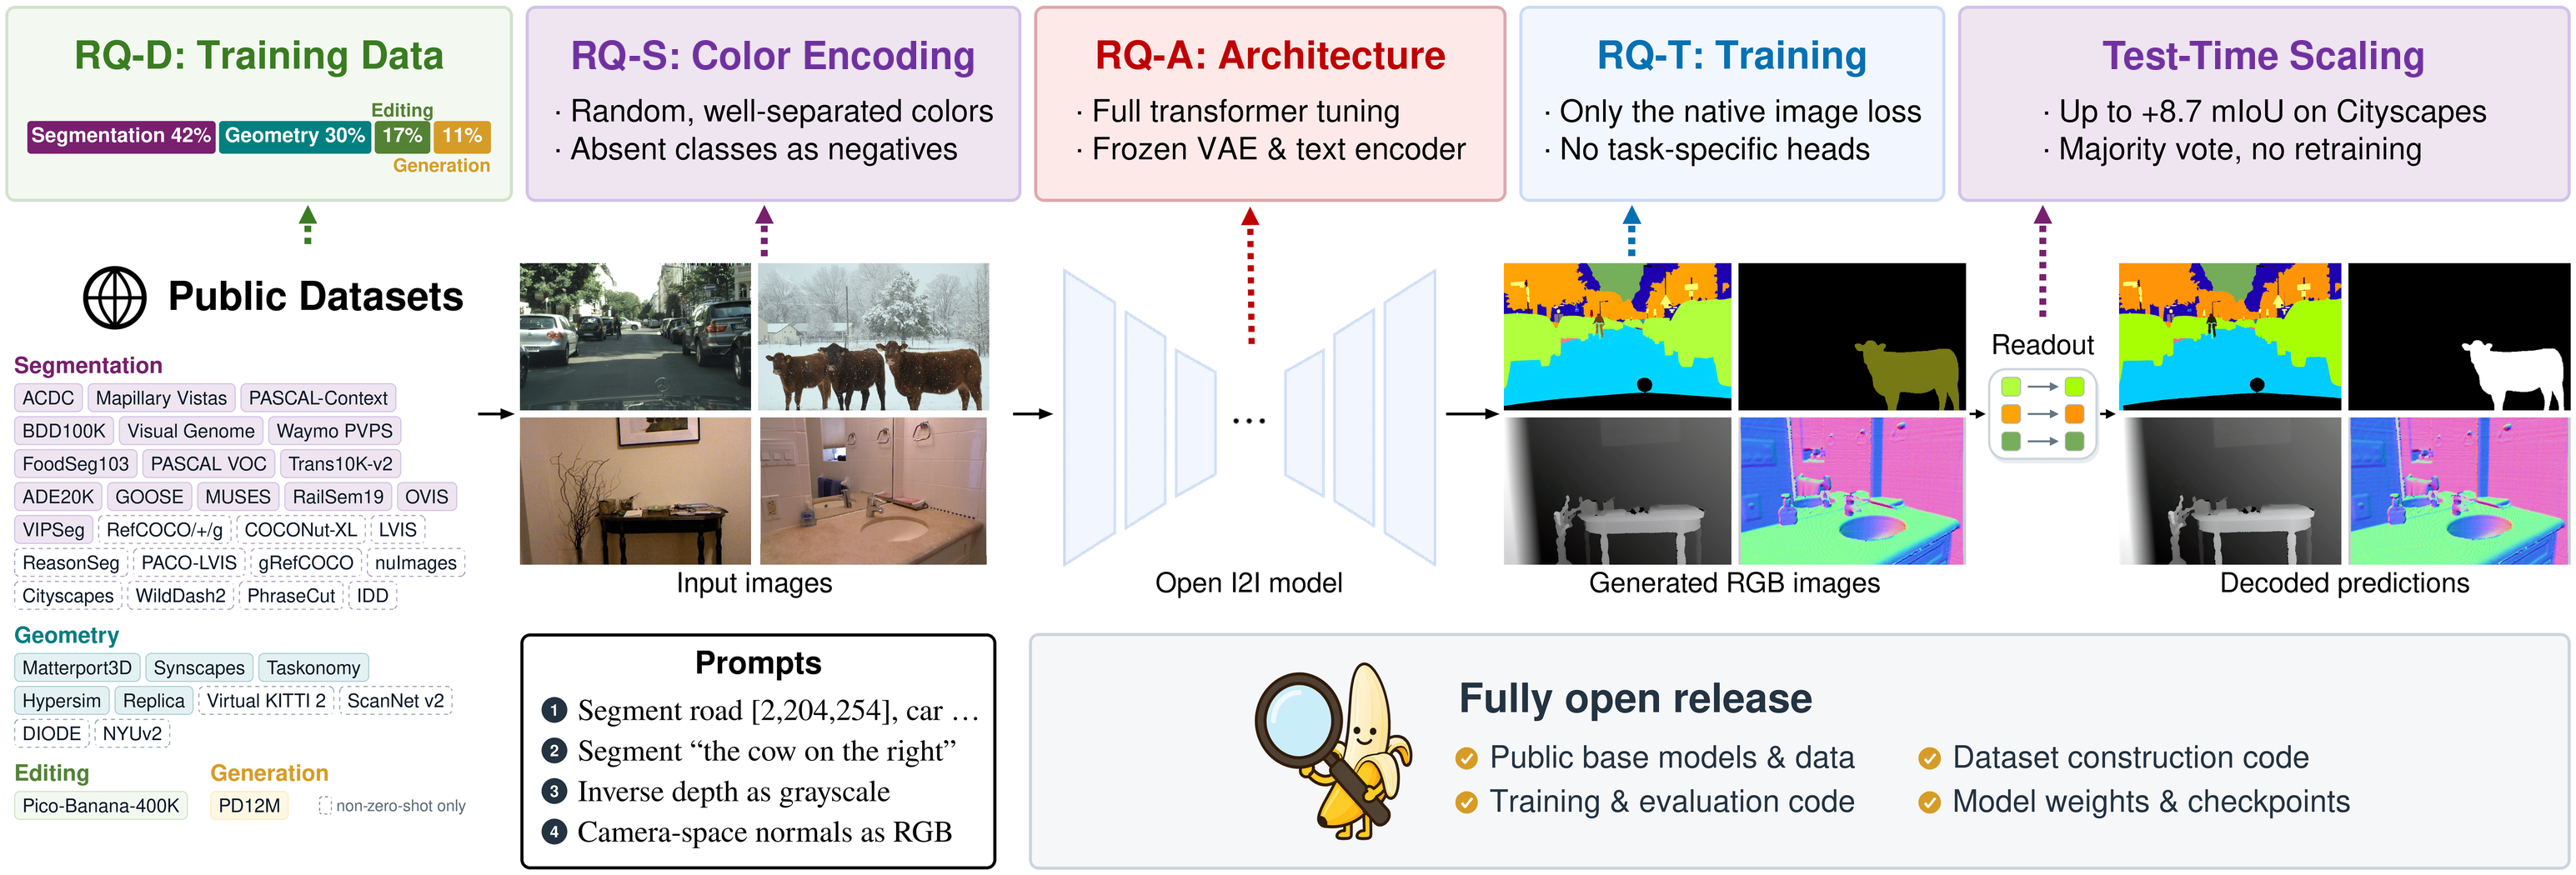
Figure 1 — OVB recipe 개요
3. Method & Key Results (제안 방법론 및 핵심 결과)
OVB는 open-weight 모델인 FLUX.2-Klein 4B/9B의 transformer parameter 전체를 fine-tuning하고 VAE와 text encoder는 freeze합니다. 학습에는 base generator의 rectified-flow objective를 그대로 쓰며, geometry의 invalid 영역만 validity mask로 loss에서 제외합니다 [Figure 1]. 학습 데이터는 공개 perception 데이터에 text-to-image, image-editing, identity-reconstruction replay data를 섞어 구성했습니다. ZS 모델은 2.1M pairs, NZS 모델은 3.8M pairs를 사용했고, 100K steps, batch size 192로 학습했습니다.
주요 design choice 분석 결과:
- Class–color mapping: fixed color로 학습하면 같은 protocol에서는 53.9 mIoU가 나오지만, 평가 시 색을 바꾸면 7.1로 붕괴합니다. 모델이 색과 class의 대응을 외워버린다는 뜻입니다. random color로 학습하면 이 붕괴를 피할 수 있습니다(51.0).
- Palette: 200색 palette 중 가장 잘 구분되는 Top 64 색을 쓴 설정이 평균 54.5 mIoU로 가장 좋았습니다.
- Adaptation scope: 마지막 4개 block만 tuning하면 Cityscapes가 4.5 mIoU에 그쳤고, full transformer를 tuning하면 26.0이었습니다(reduced setup 기준). LoRA는 semantic segmentation에서 full fine-tuning보다 약 12 mIoU 낮았습니다.
- Data mix: generation 데이터 15%, editing/identity 데이터 25% 비율이 depth, segmentation, editing 사이에서 가장 균형 잡힌 결과를 냈습니다.
Legend ensembling은 R개의 서로 다른 legend로 얻은 class map을 majority vote로 합칩니다 [Figure 4]. Cityscapes에서 ZS 9B 모델은 single pass 65.4 mIoU에서 20 passes 후 73.9 mIoU로 올라갔습니다. 반면 oracle relabeling 점수는 85.9 → 85.6으로 거의 변하지 않았습니다. 따라서 개선분의 대부분은 region 품질이 아니라 color binding error를 바로잡은 데서 나온다고 해석됩니다. 최대 개선 폭은 Cityscapes +8.7, COCO-Object +15.0 mIoU입니다.
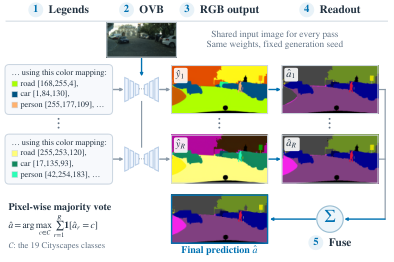
Figure 4 — Legend ensembling 과정
최종 성능:
- Semantic segmentation: ZS 9B가 Cityscapes에서 73.9 mIoU로 Vision Banana(69.9)와 SAM 3(65.2)를 넘었습니다. COCO-Object에서는 ZS 53.0, NZS 59.3으로 CorrCLIP(49.4) 등 비교 대상 specialist를 모두 앞섰습니다.
- Referring/Reasoning segmentation: RefCOCOg에서 NZS 9B가 69.2 cIoU(Vision Banana 73.8)를 기록했습니다. ReasonSeg에서는 NZS 4B와 Gemma4 조합이 74.6 gIoU(Vision Banana 79.3)를 기록해 두 benchmark 모두 Vision Banana와 5점 이내 차이입니다.
- Instance segmentation: SA-Co/Gold에서 ZS 9B가 37.4 cgF1로 Gemini 2.5의 약 3배 수준이지만, Vision Banana(47.5)와 SAM 3(54.1)보다는 여전히 낮습니다.
- Geometry: NYUv2 depth δ1은 ZS 9B 97.4%, NZS 9B 99.0%로 affine-invariant depth 분야의 SOTA 모델 Marigold V2(98.0)와 비슷한 수준입니다. 단, Vision Banana가 보고한 metric depth 수치와는 직접 비교할 수 없습니다. NYUv2 normal mean error는 NZS 9B 기준 **13.51°**입니다 [Figure 8].
- Generation retention: ImgEdit-Bench Basic 점수는 9B에서 거의 유지되었습니다(3.89 → 3.89). 다만 GenAI-Bench VQAScore는 4B에서 약 −0.05, 9B에서 약 −0.03 하락했습니다.
- Frozen feature 품질: OVB 9B가 COCO20k object discovery(56.3 vs. 54.8)와 SPair semantic correspondence(61.9 vs. 56.1)에서 DINOv3 7B를 넘었습니다.
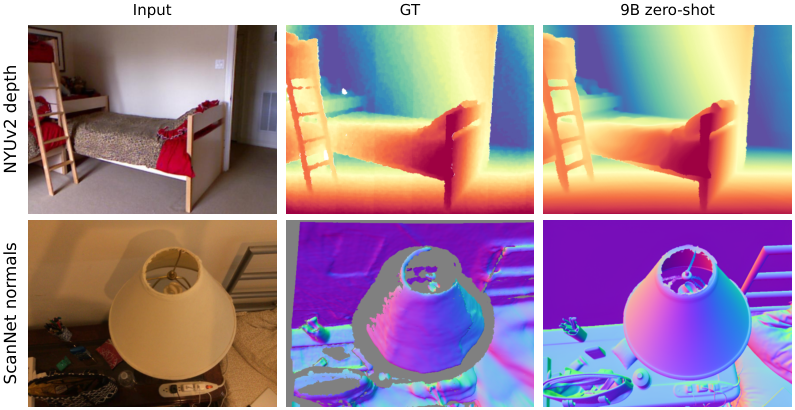
Figure 8 — Depth/Normal 예측 결과
4. Conclusion & Impact (결론 및 시사점)
OVB는 공개 image generator와 공개 데이터만으로 segmentation과 geometry를 하나로 처리하는 generative perception model을 만들 수 있음을 보여주었습니다. 동시에 editing 능력도 대체로 유지됩니다. 통제된 실험에서 효과가 확인된 선택은 randomized·well-separated palette, relative inverse depth, full transformer adaptation입니다. 아울러 perception 정확도와 generation 품질 사이에 trade-off가 있음도 확인되었습니다. 저자들이 밝힌 주요 한계는 open base model의 perception 능력이 proprietary generator(Nano Banana Pro)보다 약하다는 점입니다. 예를 들어 ReasonSeg raw query에서 fine-tuning 전 F2K4B Base는 18.5 gIoU에 그쳤습니다.
학계 측면에서는 data pipeline, training/evaluation code, 최종·중간·ablation checkpoint를 모두 공개해 generator 기반 perception 연구의 reproducibility baseline을 마련했다는 의의가 있습니다. 또한 legend ensembling은 재학습 없이 추론 연산량만 늘려 성능을 높이는 test-time scaling 방향을 perception 영역에 제시했습니다. pass 간 agreement를 per-pixel confidence로 활용할 수 있다는 점도 실용적입니다. agreement가 0.9 미만인 픽셀은 전체의 6%이지만 오류의 58%를 차지합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] From RGB Generation to Dense Field Readout: Pixel-Space Dense Prediction with Text-to-Image Models
- [논문리뷰] Lotus-2: Advancing Geometric Dense Prediction with Powerful Image Generative Model
- [논문리뷰] Video Generation Models are General-Purpose Vision Learners
- [논문리뷰] Video Generative Models as Geometry Learner
- [논문리뷰] TransNormal-2: Geometry-Grounded Rectified Flow with Edge-Aware Decoding for Precise Normal Estimation
Review 의 다른글
- 이전글 [논문리뷰] On the Design of Hyper-Connections: Simplification, Stability, and Scalability
- 현재글 : [논문리뷰] Open Vision Banana: A Fully Open Recipe for Generative Visual Perception
- 다음글 [논문리뷰] PhysLoop: Harnessing LLMs' Physics Awareness for Self-Improving Video Generation Models
댓글