[논문리뷰] Loopback Transformer: Towards a Unified View of Residual Looped Transformers
링크: 논문 PDF로 바로 열기
저자: Xuan Ouyang, Zefan Cai, Chenlong Zhang, Cheng Luo, Ke Wan, Junjie Hu
1. Key Terms & Definitions (핵심 용어 및 정의)
- Looped Transformer: 공유 블록 묶음(stack)을 여러 번 반복 적용해 parameter 수를 줄이는 Transformer입니다. 이 논문은 Huginn의 prefix–middle–coda layout을 따르며, 구조를 [PL → KL (×R) → CL]로 표기합니다. 여기서 P는 prefix block 수, K는 공유 block 수, R은 loop 반복 횟수, C는 coda block 수입니다. 저장되는 block은 P+K+C개이고, 실제로 실행되는 depth는 P+RK+C입니다.
- Depth Memory (Write–Transport–Read): Residual connection을 depth 방향의 memory로 보는 관점입니다. 각 block이 계산 결과를 memory에 write하고, 이 정보가 다음 layer로 transport되며, 이후 layer가 이를 read합니다. 저자들은 linear attention, RetNet, Mamba-2 같은 sequence 모델의 memory 규칙을 token 축이 아닌 depth 축에 적용합니다.
- Block Update (δ): block 출력에서 입력을 뺀 값, 즉 해당 block이 새로 더한 계산분입니다(δ_s = f_k(h_s) − h_s). Full block output에는 입력으로 들어온 기존 history가 섞여 있지만, block update는 새로 계산된 부분만 담습니다.
- Three Controls: 저자들이 분리해서 다루려는 세 가지 조절 요소입니다. 원래 입력의 반영 강도(input strength), update 전체에 주어지는 weight 합(total update weight), 그리고 그 합을 각 update에 나눠 주는 방식(allocation across updates)입니다.
- TPP (Tokens Per Parameter): 기준 모델 parameter 하나당 학습 token 수입니다. 이 논문의 주요 실험은 20 TPP 설정에서 진행되었습니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문은 Looped Transformer에서 반복 계산의 결과를 어떻게 저장하고 재사용하는지가 parameter sharing과는 별개의 설계 문제라고 보고, 이를 해결하려 합니다. Parameter sharing은 어떤 변환을 재사용할지만 정할 뿐, loop마다 나오는 update를 어떻게 저장하고 전달하고 읽을지는 정하지 않습니다.
기존 residual 설계는 독립적으로 조절할 수 있는 요소들을 서로 묶어 버린다는 한계가 있습니다.
- Full output 가중의 문제: full block output에 weight를 주면, 그 output에 섞여 있는 입력 history의 비중까지 함께 바뀝니다.
- Joint softmax 방식(AttnRes 등): 원래 입력과 저장된 update들이 하나의 고정된 total weight를 두고 경쟁합니다.
- Standard residual addition: 입력 계수는 고정되지만 모든 update의 weight가 1이므로, block을 반복 적용할수록 total update weight가 계속 커집니다.
Pre-Norm Transformer의 layer 사이, 그리고 looped Transformer의 loop 사이에서 representation이 매우 비슷하다는 관찰이 보고되어 왔습니다. 연속된 update가 공통 성분을 공유한다면, 단순 addition은 그 성분을 loop마다 반복해서 강화합니다. 또한 학습 때보다 loop를 더 돌리면 성능이 오히려 나빠지는 overthinking 문제도 있습니다. 저자들은 이러한 이유로 input strength, total update weight, allocation을 각각 따로 조절할 수 있는 새로운 residual 설계가 필요하다고 주장합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 세 가지 control을 분리하는 Loopback Transformer를 제안합니다 [Figure 3].
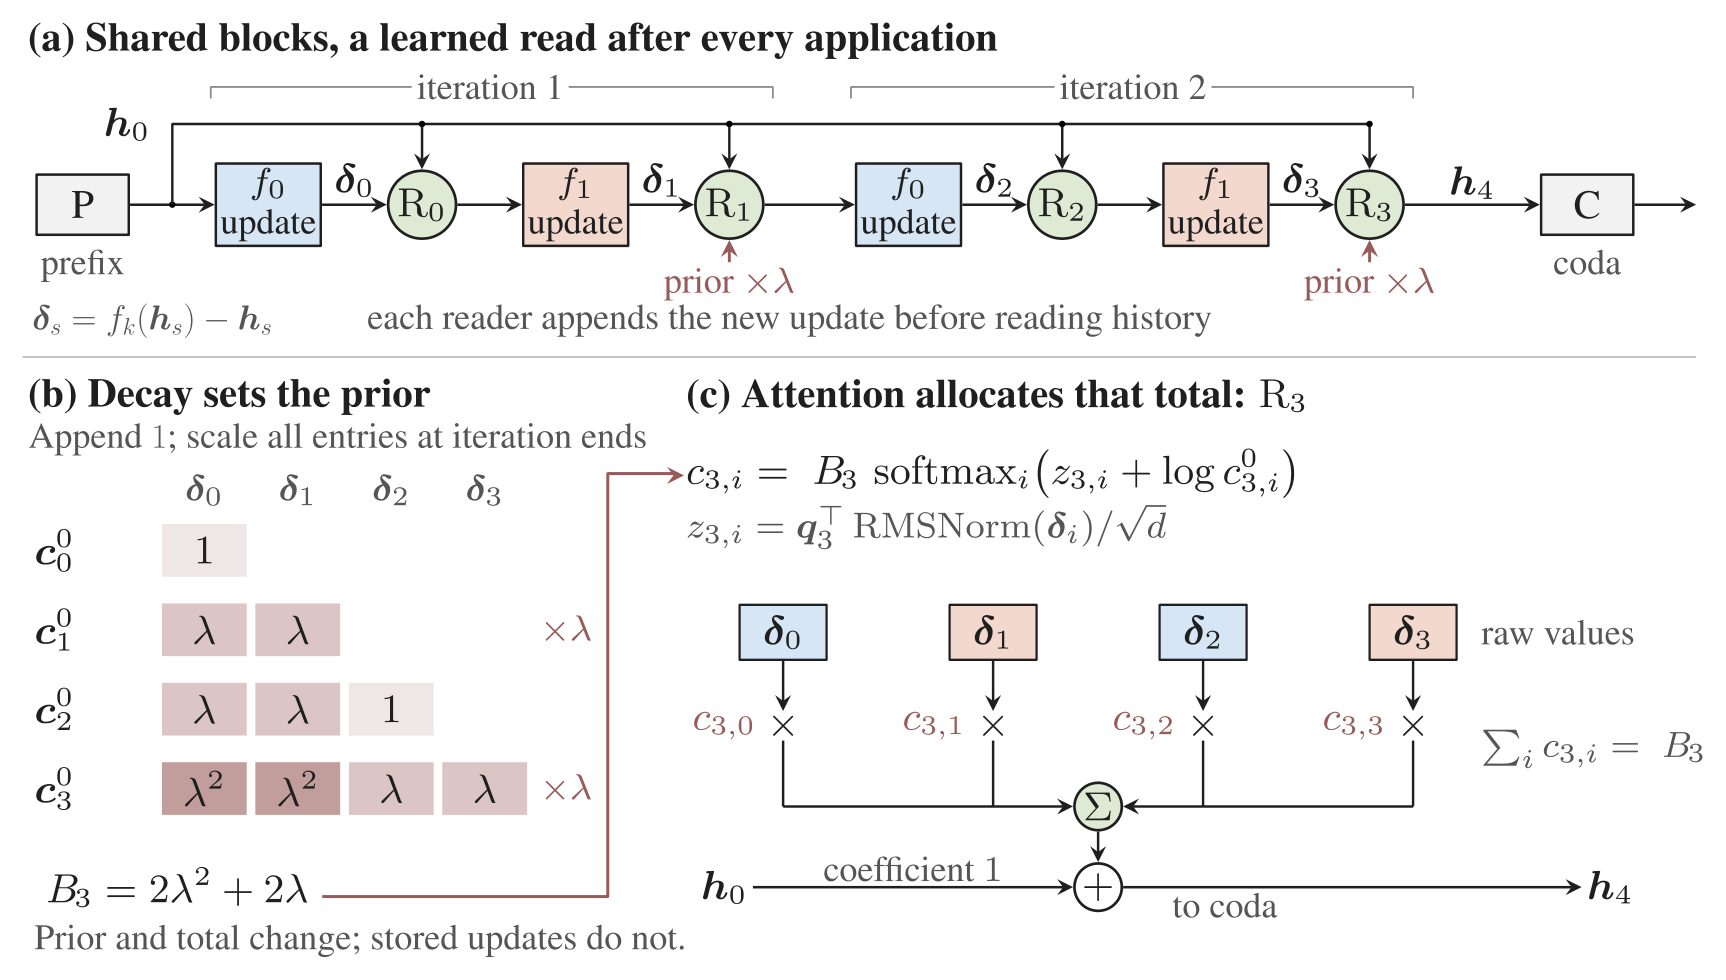
Figure 3 — Loopback 구조
- Update 저장 방식: full block output 대신 개별 block update를 저장합니다. 공유 stack의 입력 h₀는 별도 경로로 유지하며 계수를 1로 고정합니다. 따라서 모든 update가 0이 되면 stack은 그대로 h₀를 반환하므로, residual identity path가 보존됩니다.
- Geometric decay: 각 loop iteration이 끝날 때마다 기존 update의 계수에 λ(예: λ=1/4)를 곱합니다. 이렇게 하면 loop 반복 횟수가 늘어도 total update weight가 일정 범위를 넘지 않고, 최근 update에 더 큰 weight를 주는 recency prior 역할도 합니다.
- Softmax attention reader: application마다 학습되는 query vector q_s가 정규화된 update(key)에 점수를 매깁니다. decay로 정해진 baseline weight에 이 점수를 반영해 weight를 다시 나누되, 합계 B_s는 그대로 유지합니다. 그 결과 다음 state는 h_{s+1} = h₀ + Σ c_{s,i} δ_i 형태가 됩니다.
- Reader 설계: query·key·value projection이 없고, query를 0으로 초기화하면 decay만 적용한 reference와 같아집니다. 공유 block과 token 축 attention은 전혀 바꾸지 않고, residual 집계 방식만 바꿉니다.
주요 결과 (ClimbMix 데이터셋, 학습 token 수와 executed depth를 맞춘 비교):
- 191M / 374M / 778M: Loopback은 Standard Transformer parameter의 40.0% / 56.3% / 56.3%만 사용하면서, Standard와 7개 looped 설계(Plain Loop, mHC, HC, iHC, Hyperloop, MHAR, AttnRes)를 포함한 9개 설계 중 validation loss가 가장 낮습니다(예: 374M에서 2.4008, Standard는 2.4395). 13개 task 평균 정확도와 WikiText perplexity도 세 scale 모두에서 가장 좋습니다. 다만 개별 task 결과는 설계마다 엇갈립니다. 가장 가까운 baseline인 mHC보다 loss가 0.006 / 0.011 / 0.005 nats 낮습니다.
- 1.4B / 3B: Standard parameter의 68% / 75%만으로 validation loss와 13개 task 평균 정확도에서 모두 앞섭니다. WikiText perplexity는 1.4B에서 20.29 vs 21.09, 3B에서 16.74 vs 17.28입니다.
- Math/Code: GSM8K, MATH-500, HumanEval, MBPP의 reference-solution loss(정답 풀이에 대한 teacher-forced NLL)가 두 scale의 네 데이터셋 모두에서 더 낮습니다. 3B에서 5-shot word-problem 정확도는 2.6% → 6.4%로 올랐습니다.
- 추가 loop에 대한 Robustness: 재학습 없이 loop 횟수를 늘렸을 때 Loopback은 Plain Loop보다 성능 저하가 작았습니다. 191M에서 8회 visit 시 loss 증가는 0.060 vs 0.454, 1.4B에서는 0.028 vs 0.248입니다.
- Ablation:
- decay를 제거하면 loss가 0.0434 / 0.0337 nats(191M / 374M) 늘어나고, attention을 제거하면 0.0033 / 0.0028 nats 늘어납니다.
- 세 가지 initialization 방식(Gaussian, GPT-2 residual scaling, PyTorch default)과 두 scale을 조합한 6개 설정 모두에서 Standard와 Plain Loop보다 loss가 낮았고, 그중 5개 설정에서는 비교 대상 중 가장 낮았습니다.
4. Conclusion & Impact (결론 및 시사점)
이 논문은 Looped Transformer의 성능이 어떤 block을 공유하느냐만큼, 공유 계산의 결과를 어떻게 유지하고 재사용하느냐에 달려 있다는 결론을 내립니다. Loopback은 update를 따로 저장하고, geometric decay로 정한 weight를 합계를 유지한 채 attention으로 다시 나눈 뒤 원래 loop 입력에 더합니다. 이 방식으로 191M~3B 범위의 다섯 scale 모두에서 Standard Transformer parameter의 40–75%만 쓰면서 더 좋은 aggregate 성능을 냈습니다.
학술적으로는 residual 설계를 linear attention이나 recurrent memory와 같은 틀(write–transport–read)로 통합해 분석했다는 점이 의미 있습니다. 이를 통해 HC, mHC, AttnRes 같은 기존 설계가 세 가지 control을 각각 어떻게 제약하는지 비교할 수 있게 되었습니다. 실용적으로는 parameter 효율이 높은 LLM과 inference-time scaling 연구에 활용할 수 있는 단순한 residual adapter를 제시합니다.
저자들이 밝힌 한계도 있습니다.
- 실험은 ClimbMix pretraining에 한정되며, 대규모 비교는 각 설정당 단일 run입니다.
- 이력을 명시적으로 저장하므로 memory traffic과 activation이 늘어납니다. 따라서 parameter가 줄어도 latency나 peak memory가 반드시 줄어들지는 않습니다.
- 학습 때보다 loop를 더 돌려도 성능 저하는 작았지만, validation loss가 개선되지는 않았습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Scaling to Tens of Thousands of Test-Time Iterations with Loop-Native Attention Residuals
- [논문리뷰] Towards Looped Models Done Right, Part I: Topology, Input Injection, Recurrent-State Design
- [논문리뷰] Delta Attention Residuals
- [논문리뷰] DeepLoop: Depth Scaling for Looped Transformers
- [논문리뷰] Multi-Head Attention Residuals
Review 의 다른글
- 이전글 [논문리뷰] JVT: Just Video Transformer makes pixel-space video diffusion simple
- 현재글 : [논문리뷰] Loopback Transformer: Towards a Unified View of Residual Looped Transformers
- 다음글 [논문리뷰] LuthorSQL: A One-Pass Text-to-SQL Model as System 1 for a Slower LLM Agent
댓글