[논문리뷰] LuthorSQL: A One-Pass Text-to-SQL Model as System 1 for a Slower LLM Agent
링크: 논문 PDF로 바로 열기
저자: Ibrahim Memon, Armin Karamzade, M. Hanif Jhaveri, Roy Fox
1. Key Terms & Definitions (핵심 용어 및 정의)
- System 1 / System 2: Kahneman의 이중 처리 이론에서 가져온 구분입니다. System 1은 local GPU에서 실행되는 빠른 one-pass 7B 모델(LuthorSQL)이고, System 2는 tool을 사용하는 느린 frontier LLM agent(Claude Opus 5.5)입니다.
- Query Plan / Plan Grammar (v3): SQL의 surface syntax를 추상화한 bounded record입니다. projection(1–4개), aggregation, filter(0–4개), group by, order by, limit, set operation, derived table 등의 discrete slot으로 구성됩니다. BIRD dev gold query의 84.6%를 표현할 수 있습니다.
- VALHARD: 같은 frozen OmniSQL-7B backbone 위에 올린 두 번째 LoRA adapter 기반 validator입니다. 컴파일된 SQL 문자열을 읽고 scalar score를 출력하며, hard negative(near-miss wrong result group, synthetic perturbation)로 학습되었습니다.
- Validator Margin: VALHARD가 상위 두 result group(동일한 execution 결과를 내는 candidate 집합)에 매긴 score의 차이입니다. Cascade에서 routing confidence로 사용됩니다.
- Candidate Handoff: System 1이 만든 candidate 중 상위 8개 result group을 SQL, 결과 preview와 함께 agent prompt에 넣어 주는 방식입니다. Agent는 이 중 하나를 고르거나 직접 query를 작성합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문의 핵심 질문은 다음과 같습니다. 조직이 이미 보유한 local hardware에서 돌아가는 소형 모델이 frontier LLM agent의 API 비용을 accuracy 손실 없이 얼마나 줄일 수 있는가?
- 비용과 privacy 문제: Claude Opus 5.5 agent는 held-out BIRD 질문에서 77.26%를 기록하는 가장 정확한 축에 속하는 시스템입니다. 하지만 질문당 약 2센트가 들어, 하루 10,000개 질문이면 연간 $70,000 이상이 됩니다. 또한 모든 질문이 외부 API로 전송되므로 민감한 데이터가 노출됩니다.
- 기존 고성능 시스템의 Latency: 기존 고성능 시스템은 SQL을 token 단위로 autoregressive하게 생성하고, 여러 sample을 뽑아 voting이나 reranking을 거치므로 느립니다.
- 기존 cascade 연구의 한계: 선행 연구(Malekpour et al.)는 weak model이 만든 SQL의 품질을 fallback 이전에 판단할 수 없다는 이유로 text-to-SQL에 cascade를 쓸 수 없다고 주장했습니다.
- 평가 신뢰성 문제: LLM baseline이 공개 benchmark를 memorization했을 가능성이 있어, 평가 결과를 그대로 믿기 어렵습니다.
저자들은 single forward pass로 동작하는 slot-filling 모델과 trained validator margin을 결합해 이 문제들을 동시에 다루고자 합니다 [Figure 1].
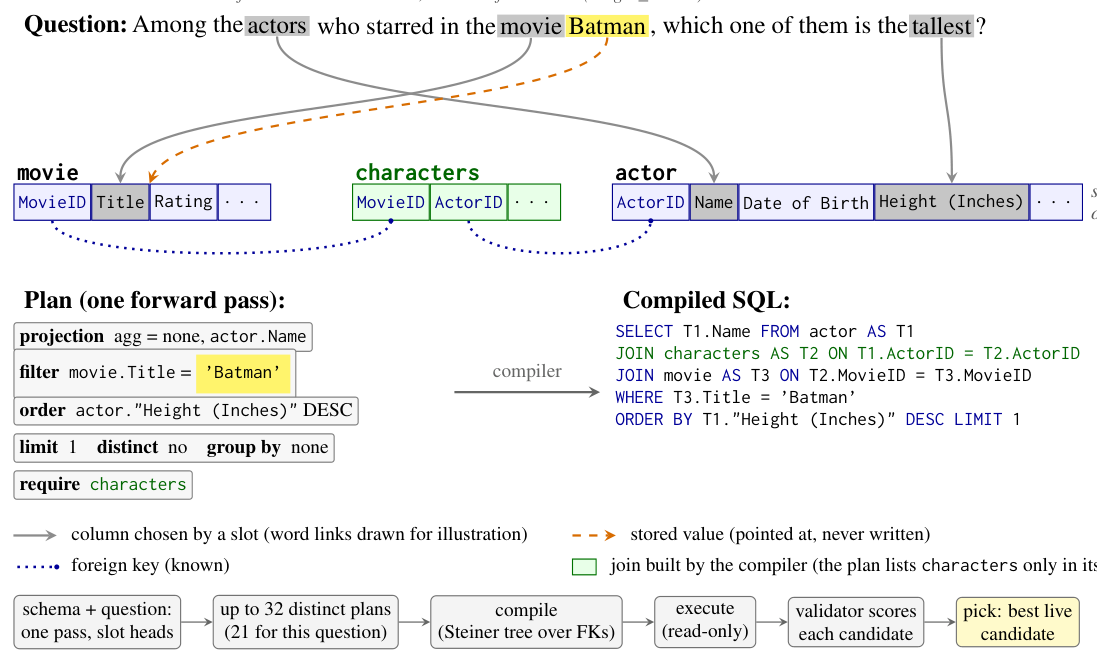
Figure 1 — 전체 System 1 파이프라인(slot filling → compile → execute → validator pick)을 보여주는 핵심 아키텍처 다이어그램
3. Method & Key Results (제안 방법론 및 핵심 결과)
LuthorSQL은 SQL을 직접 쓰지 않고 plan slot score를 한 번의 forward pass로 예측한 뒤, 이를 deterministic하게 컴파일·실행하고 validator로 고르는 구조입니다 [Figure 1].
방법론
- Backbone과 slot head: OmniSQL-7B에 LoRA adapter를 붙이고, schema, 질문, evidence, slot별 learned token을 한 시퀀스로 encoding합니다. 이후 pointer, choice, pairwise, value head가 모든 slot을 병렬로 scoring합니다.
- Value 처리: Filter value는 생성하지 않습니다. DB 값, 질문에서 파싱한 literal, 저차원 column 값으로 구성된 후보 집합 L(q, D)를 가리키기만 하므로 literal hallucination이 원천적으로 차단됩니다.
- Join 생성: Compiler가 foreign-key graph 위의 minimum-cost Steiner tree로 join을 자동 구성합니다.
- Candidate 생성: Plan score가 slot별로 additive하게 분해되므로, best-first lazy k-best enumeration으로 최대 k=32개의 distinct candidate를 추가 backbone 호출 없이 얻습니다.
- 선택: 각 candidate를 3초 timeout으로 read-only 실행하고, VALHARD가 가장 높은 점수를 준 live candidate를 선택합니다.
- Confidence cascade: Validator margin이 t=3.0 미만이면 질문을 Opus agent로 보냅니다(handoff). 이 threshold는 사전에 정한 규칙(accuracy − cost 최대화)으로 선택했습니다.
System 1 단독 결과
- BIRD hidden test set에서 68.03% EX(Soft F1 69.26%, R-VES 65.17%)를 기록했습니다. Single-adapter 변형은 68.19%로, 32B Arctic-ExCoT의 leaderboard 점수와 같습니다.
- 단, test 점수가 BIRD dev 점수(59.39%)보다 8.64 points 높으며, 저자들은 이 차이를 설명하지 못한다고 밝힙니다.
- 단일 H100에서 median latency는 0.84 s, 비용은 1,000 query당 $0.64입니다. Greedy plan만 쓰면 0.13 s에 49.12%이고, k=32와 VALHARD를 더하면 +9.93 points가 오릅니다.
- 8-bit quantization으로 약 9 GB(Apple M3 laptop)에서도 GPU와 동등한 accuracy를 보였습니다(159 vs. 158 correct).
- 재학습 없이 sqlglot으로 transpile했을 때 Snowflake, BigQuery, MySQL, PostgreSQL, DuckDB에서 57.1–59.3%를 기록했습니다. 이는 SQLite의 60.17% 대비 3.1 points 이내입니다.
Cascade 결과 (pre-registered) [Table 2]
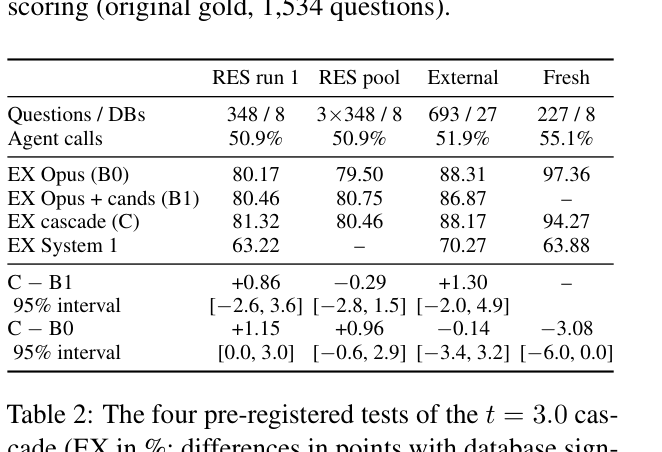
Table 2 — RESERVED, External, Fresh set에서 cascade와 Opus baseline의 accuracy 및 agent call 비율을 비교하는 핵심 결과 테이블
- RESERVED (348 질문, 3회 pooled): 약 49.1%를 local에서 처리했고, Opus with candidates 대비 비용을 34.3% 절감했습니다. Accuracy 차이는 −0.29 points로 유의하지 않았습니다.
- 다만 첫 번째 registered run은 사전에 정한 기준(cost 30%, time 25%, accuracy lower bound −2.5 points)을 근소하게 통과하지 못했습니다.
- KaggleDBQA + Spider-Realistic (693 질문): Opus with candidates 대비 31.7%, Opus alone 대비 16.2% 비용을 절감했습니다.
- Post-cutoff fresh set (227 질문): Cascade는 94.27%, Opus alone은 97.36%였습니다(3.08-point gap, 유의하지 않음).
- Plain Messages API 조건: fresh set에서 33.3% 비용 절감과 동등한 accuracy(95.15% vs. 95.59%)를 보였습니다 [Figure 2].
- Routing 기준 비교: Margin routing은 vote-agreement, question-length, random routing보다 일관되게 우수했습니다(85.57 vs. 81.82 / 80.81 / 78.89).
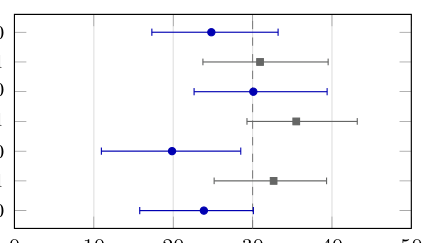
Figure 2 — Held-out test별 cascade의 비용 절감률과 95% 신뢰구간을 시각화한 핵심 결과 그래프
Contamination 분석
- Schema 없이 질문과 DB 이름만 주었을 때, Opus는 gold query의 48–92%를 verbatim으로 재현했습니다.
- 그러나 schema를 전부 renaming한 조건(72.88% vs. 72.32%)과 post-cutoff DB 조건에서도 tool-assisted accuracy는 유지되었습니다.
4. Conclusion & Impact (결론 및 시사점)
LuthorSQL은 one-pass slot-filling 7B 모델이 frontier LLM agent의 fast gate 역할을 할 수 있음을 보여줍니다. 질문의 약 절반을 local에서 처리하면서, 사전 등록된 held-out benchmark에서 API 비용을 16–34% 줄였고, 그 과정에서 유의한 accuracy 손실은 관찰되지 않았습니다.
산업적으로 이 결과는 privacy와 비용이 중요한 기업 환경에서 실용적 의미가 있습니다. 하나의 local checkpoint가 여러 SQL engine에 그대로 적용되고, 질문의 상당 부분이 외부로 나가지 않기 때문입니다.
학술적으로는 세 가지 기여가 있습니다.
- Trained validator margin이 text-to-SQL cascade의 신뢰할 만한 routing signal이 될 수 있음을 실증해, "cascade 불가" 주장에 반례를 제시했습니다.
- Pre-registration을 포함한 엄격한 평가 프로토콜을 제시했습니다.
- LLM baseline에 대한 memorization probe를 표준 절차로 권고합니다.
다만 다음과 같은 한계가 있습니다.
- Grammar coverage가 84.6%에 그칩니다.
- Held-out test set의 규모가 작습니다.
- BIRD dev에서는 t=3.0 threshold로 2.93 points 손실이 발생했습니다.
- DECISION split의 out-of-grammar 질문을 gold 정보로 routing했습니다.
후속 과제로는 hidden test set에서의 cascade 평가와 out-of-grammar detector 개발이 남아 있습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
Review 의 다른글
- 이전글 [논문리뷰] Loopback Transformer: Towards a Unified View of Residual Looped Transformers
- 현재글 : [논문리뷰] LuthorSQL: A One-Pass Text-to-SQL Model as System 1 for a Slower LLM Agent
- 다음글 [논문리뷰] MEM-SQL: Memory-Empowered Text-to-SQL
댓글