[논문리뷰] Re-Search: Dissecting LLM Ideation Through a Two-Player Questioning Game
링크: 논문 PDF로 바로 열기
저자: Muhan Gao, Hangxiao Zhu, Xinqi Su, Yu Zhang, Daniel Khashabi, Kuan-Hao Huang (Texas A&M University, Johns Hopkins University)
1. Key Terms & Definitions (핵심 용어 및 정의)
- Re-Search: Twenty Questions 게임을 research ideation에 맞게 바꾼 two-player questioning game입니다. 모델은 published paper의 research problem만 보고 yes-or-no 질문을 던져 논문의 core idea를 다시 찾아내야 합니다.
- Inquisitor / Answerer / Judges: 게임에 참여하는 세 역할입니다. Inquisitor는 problem만 보고 최대 100개 질문을 던지고, 10개 질문마다 idea card를 작성합니다. Answerer(Gemma-4-31B)는 full paper를 읽고 각 질문에 Yes/No/Unknown으로 답합니다. Judges는 세 개의 LLM으로 구성되며 idea card를 평가합니다.
- Recovery Score: 각 idea card가 hidden solution을 얼마나 복원했는지 세 judge(Gemma-4-31B, Qwen3.6, GPT-OSS-120B)가 1–10점으로 매긴 점수의 평균입니다.
- Survey (C_full / C_decoy / C_dummy / C_none): hypothesis space를 외부에서 제공하는 overview입니다. 5–7개 dimension마다 4–6개 candidate approach를 나열합니다. C_full은 core idea를 포함하고, C_decoy는 그 항목 하나를 그럴듯한 decoy로 바꾼 버전입니다. C_dummy는 논문을 가리키는 다른 항목까지 바꾼 버전이고, C_none은 survey 없이 진행하는 조건입니다.
- Top-level Branches (B_top): 게임 trace를 tree로 변환했을 때 research problem 바로 아래에서 시작된 질문 수입니다. 이 값으로 search breadth를 측정하고 over-exploitation과 over-exploration 패턴을 구분합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문은 기존 evaluation이 LLM research ideation의 iterative search process를 보여주지 못한다는 문제를 다룹니다. 그래서 ideation을 execution과 분리해 단계별로 관찰할 수 있는 testbed를 제안합니다.
기존 benchmark의 한계는 두 가지입니다.
- Ideation benchmark: IdeaBench, MLR-Bench 등은 one-shot proposal을 LLM judge로 평가하므로 feedback에 따라 idea가 어떻게 변하는지 보지 못합니다.
- End-to-End benchmark: iterative search를 포함하지만 coding, debugging, experimentation과 얽혀 있습니다. 그래서 실패가 ideation 때문인지 execution 때문인지 구분하기 어렵습니다.
기존 Twenty Questions 계열 연구(MediQ 등)에서는 target이 작은 candidate set 안에 있습니다. 반면 research ideation에서는 모델이 candidate 자체를 생성해야 합니다. 저자들은 LLM이 아이디어 공간을 어떻게 탐색하는지, 그리고 무엇이 진전을 막는지 진단할 수 있는 controlled setting이 필요하다고 주장합니다 [Figure 1].
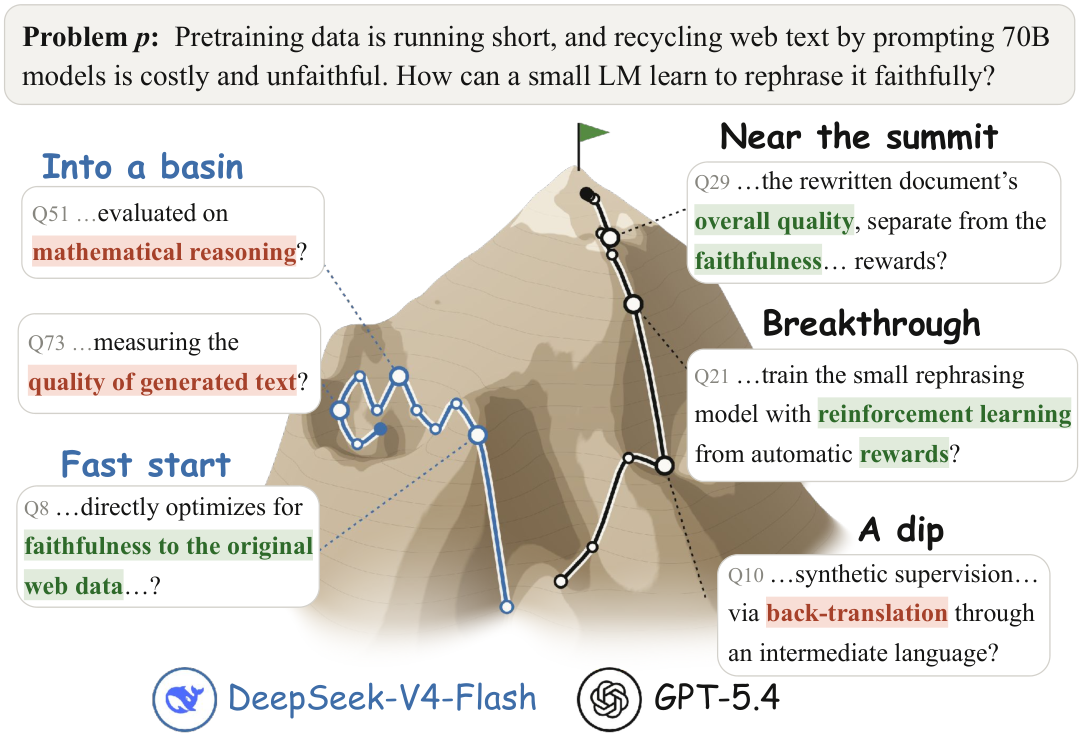
Figure 1 — Re-Search 게임 예시
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 ICML 2026 논문 200편으로 Re-Search를 구성하고, 통제된 intervention으로 ideation의 bottleneck을 진단했습니다. 결론은 bottleneck이 judgment가 아니라 generation이라는 것입니다.
설정
- 대상 논문은 method 중심이고 review score가 높으며, 2025년 8월 31일 이후 공개되어 모든 모델의 knowledge cutoff보다 늦은 논문만 골랐습니다. 이를 통해 contamination 위험을 줄였습니다.
- GLM-5.2가 각 논문에서 research problem과 solution을 각각 4개 field로 추출했습니다. 사람이 100편을 검수한 결과 93%가 정확했습니다.
- 정보 이론적으로 Yes/No/Unknown 세 가지 답에서 얻는 정보량은 T번 질문 기준 최대 T·log₂3 bits로 제한됩니다.
- LLM judge 사이의 pairwise Spearman correlation은 0.85–0.88입니다. 사람 평가(Fleiss' κ 0.83)와는 91.2% 일치했습니다.
- 평가 대상은 Gemma-4-31B, GPT-OSS-120B, DeepSeek-V4-Flash, Qwen3.6-35B-A3B, Claude Sonnet 4.5, GPT-5.4 등 6개 모델이며, 논문마다 3게임씩 진행했습니다.
핵심 결과
- Early stall
- 질문 1–10에서 점수가 +1.3~+3.2로 가장 크게 오르고, 질문 11–30에서는 +0.2~+0.8에 그칩니다.
- 질문 31–100 구간에서는 세 모델이 거의 정체하고, 두 모델(Gemma, Sonnet)은 천천히 오릅니다. GPT-5.4만 꾸준히 개선됩니다 [Figure 1].
- Prefix-fork 실험에서 질문 k 시점의 점수와 최종 점수의 correlation은 k=10에서 r=0.76–0.87, k=30에서 r=0.87–0.92였습니다. 초반 질문이 결과를 대부분 결정한다는 뜻입니다.
- Knowledge는 gap의 주원인이 아님
- 100편 subset에서 GPT-5.4는 GPT-OSS-120B보다 2.54점 높았습니다.
- 두 모델 모두 core idea를 사전에 나열할 수 있었던 24편에서도 차이는 2.28점이었습니다. 지식이 메운 gap은 약 10%에 불과합니다.
- 약한 모델도 좋은 질문을 고를 수 있음
- 네 모델이 매 라운드 질문을 제안하고 한 모델이 그중 하나를 고르게 했습니다. 30문항 후 모든 selector가 5.19–5.34점으로 비슷했고, 약한 모델은 단독 대비 +1.04~+1.09점 올랐습니다.
- 이 향상은 GPT-5.4 질문을 그대로 베낀 결과가 아닙니다. GPT-OSS-120B는 자기 제안을 30%, GPT-5.4 제안을 34% 선택했습니다 [Figure 5].
- 같은 모델로 best-of-4를 뽑으면 4.57점, pool에서 random pick을 하면 4.43점으로 모두 multi-model pool(5.20점)보다 낮았습니다. Candidate의 다양성과 selection이 모두 필요하지만, 더 부족한 쪽은 generation입니다.
- Survey로 hypothesis space 확장
- C_full은 최종 점수를 최대 1.25점 올렸고, C_decoy 조건에서 점수가 낮은 모델일수록 이득이 컸습니다(r=−0.74).
- Survey에 후보가 20–42개 있었지만, 모델들은 named idea를 median 3–6개 질문 안에 물었습니다.
- Search tree 분석 (1,200개 tree)
- DeepSeek, Qwen은 5.2–5.5개 branch에 머무는 over-exploitation 패턴을 보였습니다. 이 두 모델의 질문 중 23%는 같은 방향 안에서 변형만 나열하는 질문이었습니다.
- GPT-OSS는 13.7개 branch를 여는 over-exploration 패턴을 보였습니다.
- 강한 모델들은 7.2–8.2개로 균형을 유지했습니다. Branch 수와 최종 점수는 inverted-U 관계이며, 정점은 약 8.3개 branch입니다.
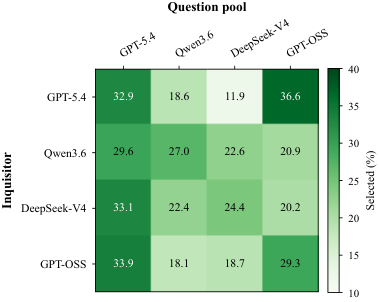
Figure 5 — 질문 선택 비율 히트맵
4. Conclusion & Impact (결론 및 시사점)
이 논문의 결론은 LLM ideation의 bottleneck이 knowledge나 judgment보다 generation에 있다는 것입니다. 대부분의 모델은 약 30문항 이후 plateau에 머뭅니다. 하지만 외부 candidate(다른 모델의 질문, survey)가 주어지면 약한 모델도 이를 알아보고 활용해 최강 모델과의 gap을 상당 부분 좁힙니다.
Autoresearch system 설계에 대한 시사점은 다음과 같습니다.
- 단일 모델의 generation 능력을 높이는 것보다 외부에서 idea와 질문을 공급해 search를 풍부하게 만드는 편이 더 효과적일 수 있습니다. 예로 multi-model candidate pool이나 literature 기반 survey가 있습니다.
- 초반 탐색 품질과 exploration–exploitation 균형이 결과를 크게 좌우하므로, 이를 직접 다루는 설계가 필요합니다.
저자가 밝힌 한계
- ML 논문(ICML 2026)만 사용했고, 다른 분야에서는 검증하지 않았습니다.
- Recovery score와 search tree 모두 LLM이 산출했습니다.
- Contamination을 피하기 위해 최신 모델은 평가에서 제외했습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
Review 의 다른글
- 이전글 [논문리뷰] Parsed, Plausible, Wrong: Output Format Controls Silent Errors in Small-Model Semantic Parsing
- 현재글 : [논문리뷰] Re-Search: Dissecting LLM Ideation Through a Two-Player Questioning Game
- 다음글 [논문리뷰] Restoring Diversity in Distilled Image and Video Generators by Probing Activations
댓글