[논문리뷰] Reflection Anchors for Propagation-Aware Visual Retention in Long-Chain Multimodal Reasoning
링크: 논문 PDF로 바로 열기
저자: Xuan Gong, Hanbo Huang, Hao Zheng, Yiran Zhang, Wenbin Dai, Weishu Zhao, Shiyu Liang (Shanghai Jiao Tong University, Lanzhou University)
1. Key Terms & Definitions (핵심 용어 및 정의)
- Visual Forgetting: LVLM이 긴 CoT를 생성하는 동안 이미지 의존성이 점점 줄어드는 현상이다. 이 경우 뒤쪽 reasoning step은 이미지보다 textual prefix를 주로 따르게 된다.
- Marginal Downstream Visual Gain (Δt): step t에서 next-token distribution을 한 번만 reshape하고 이후에는 native decoder로 rollback했을 때 늘어나는 conditional mutual information I(V; Y≥t | h̃t)의 양이다. 현재 token의 일시적인 visual evidence가 아니라 미래 continuation까지 이어지는 visual influence를 측정한다.
- Reflection Anchor: native policy의 token entropy가 상위 ρ(기본 20%)에 드는 decoding position이다. 경험적으로 "examine", "reconsider", "actually", "instead"처럼 다음 reasoning operation을 고르는 procedural token에 많이 몰려 있다.
- Chain Mask: anchor t_k에서 (i) visual token, (ii) 앞선 anchor {t1,…,t_{k−1}}에 대한 attention을 차단한다. 나머지 textual attention은 그대로 두어 vision-reduced reference distribution을 만든다.
- RAPO (Reflection-Anchor Policy Optimization): GRPO 기반 RL 알고리즘이다. reflection anchor에서만 policy gradient를 적용하고, 여기에 branching-room-weighted chain-masked finite-window KL surrogate를 더해 downstream visual dependence를 강화한다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문의 핵심 질문은 "sparse step에서 native decoding만 최소한으로 reshape해서 미래 reasoning의 visual dependence를 유지할 수 있는가"이다. Long CoT는 LVLM의 reasoning 성능을 높이지만, 생성이 길어질수록 visual information이 희미해지는 visual forgetting이 long-horizon multimodal reasoning을 제한한다.
기존 연구는 크게 두 방향으로 나뉜다.
- Visual restoration 계열(ICoT, MINT-CoT, TVC, v1, Reflection-V 등): inference 중에 vision을 다시 주입한다. 그 대가로 추가 supervision, intervention rule, architecture 변경, inference-time computation이 필요하다.
- Policy optimization 계열(PAPO, VPPO, VL-Rethinker 등): test-time interface는 깔끔하다. 하지만 reward가 grounding을 implicit하게 유도할 뿐이어서, visual forgetting이 어디서 일어나는지, local correction이 이후 reasoning으로 어떻게 propagation되는지는 다루지 않는다.
즉 기존 방법들은 "어디에 개입할지"를 perception heuristic에 의존하고, "어떻게 visual influence를 전파할지"에 대한 원리적인 gain 분석이 없다. 저자들은 이를 information-theoretic 관점에서 sparse instance-level policy reshaping 문제로 정식화한다. 목적은 budget |A| ≤ ρT와 local KL radius ε 제약 아래에서 Σ Δt(π)를 최대화하는 것이다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 one-step intervention의 downstream visual gain에 대한 lower bound를 유도하고, 이를 바탕으로 RAPO를 설계했다 [Figure 1].
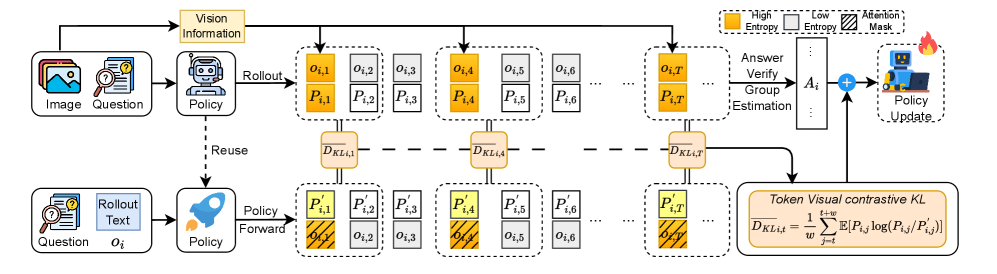
Figure 1 — RAPO 전체 개요
이론적 근거
- 최적 gain Δt*는 Ω(√ε · E[(e^{H(m_t,V)} − 2)₊ · √D_KL(p_t,V ‖ p_M,t))])를 만족한다.
- 이 bound에서 두 가지 요인이 나온다.
- local branching room: token entropy로 측정된다.
- downstream visual propagation potential: vision-marginalized reference와의 suffix divergence로 측정된다.
구현 방식
- 정확한 oracle 계산은 불가능하므로, 두 항목을 각각 근사한다.
- Anchor 선택: native-prefix entropy의 Top-ρ로 anchor를 고른다. single forward pass로 계산할 수 있다.
- Suffix divergence: Chain mask 기반 reference와 window 길이 w의 finite-window KL로 대체한다 [Figure 3].
- 최종 objective는 anchor 위치에서만 GRPO clipped surrogate를 적용한다. 여기에 γ·ω^br·√(D̄_KL) 항을 더한다. ω^br = max(e^H − 2, 0)는 branching-room weight이다.
- Masked reference와 ω^br에는 stop-gradient를 적용한다. inference 시에는 decoder를 전혀 수정하지 않는다.
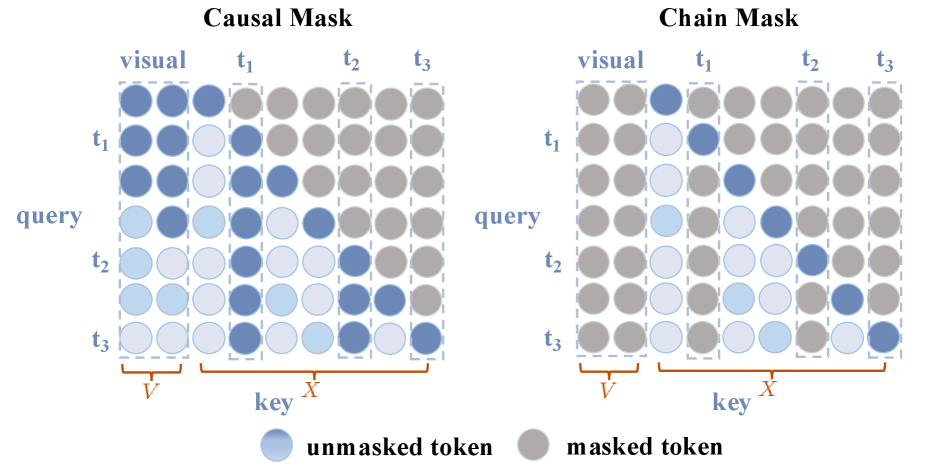
Figure 3 — Chain mask 구조
실험 설정
- 학습 데이터는 ViRL dataset이다.
- 기본 hyperparameter는 γ=0.01, top 20% entropy anchor이다.
- 평가는 6개 benchmark(MathVision, MathVerse, EMMA, LogicVista, MMMU-Pro, RealWorldQA)에서 mean@8 accuracy로 측정했다.
주요 결과
- Qwen3-VL-8B-Instruct: RAPO_G 평균 55.11(+5.55)로 GRPO 53.38, PAPO 53.50, VPPO 53.85보다 높다.
- Qwen3-VL-2B-Instruct: RAPO 43.01(+5.85)로 GRPO 40.79, VPPO 40.90보다 높다. GRPO를 120 step으로 늘린 compute-matched 설정(41.45)보다도 높다.
- Qwen2.5-VL-7B: RAPO_D 41.65로 VL-Rethinker 40.96, MM-Eureka 39.99보다 높다.
- Qwen2-VL-7B: RAPO_D 37.09로 TVC 29.94, MINT-CoT 27.32를 크게 앞선다.
Mechanism 분석
- Token-wise contrastive KL은 correct trajectory와 incorrect trajectory를 구분한다. 반면 visual attention은 두 경우를 구분하지 못한다. RAPO는 GRPO보다 late-stage KL을 더 높게 유지한다 [Figure 5].
- 학습 후 top 20% entropy token의 평균 contrastive KL은 0.30 → 0.55로 올랐다. bottom 20%는 0.06 → 0.05로 오히려 조금 줄었다.
- Chain mask 대신 image-level masking을 쓰면 평균 점수가 43.01 → 40.43으로 떨어진다.
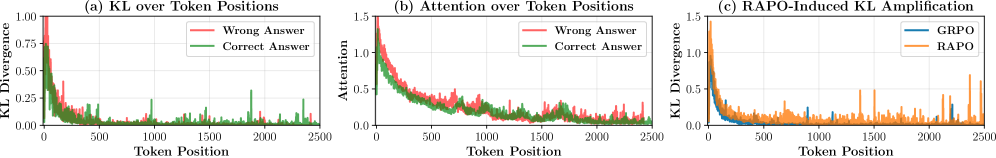
Figure 5 — Trajectory KL 분석
Ablation 및 Robustness
- Window 길이: w=3이 가장 좋다. 더 큰 window(w≥5)는 noise를 유발한다.
- γ: γ=0.1에서는 학습이 collapse한다.
- Qwen3-VL-2B-Thinking(약 6k token CoT): RAPO 45.30으로 GRPO 42.88보다 높다.
- Gemma3-4B-IT: RAPO 30.30으로 GRPO 29.77보다 높다.
4. Conclusion & Impact (결론 및 시사점)
이 논문은 long-chain multimodal reasoning의 visual retention을 selective policy reshaping 문제로 정식화했다. 그리고 "uncertainty로 intervention 위치를 고르고, propagation으로 intervention을 학습한다"는 원리를 RAPO로 구현해 여러 LVLM backbone에서 일관된 성능 향상을 보였다.
기여는 세 가지로 정리된다.
- 이론: information-theoretic lower bound로 개입 지점 선택에 원리적인 근거를 제공했다.
- 효율: inference-time 추가 연산이나 architecture 변경이 필요 없다.
- 분석: attention이 아니라 contrastive KL이 visual dependence를 더 정확히 진단하는 지표임을 보였다.
학계에서는 RLVR 계열 multimodal 학습에서 token-level credit assignment와 visual grounding을 연결하는 새로운 관점을 제시한다. 산업적으로는 기존 GRPO/DAPO pipeline에 쉽게 붙일 수 있는 plug-in 형태의 개선이라는 점에서 실용성이 높다. 다만 이론적 bound는 scoring rule이 아니라 design principle로만 쓰였고, entropy 기반 anchor는 downstream visual gain을 정확히 순위화하지 않는다는 점은 저자들도 인정하고 있다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Rethinking Token-Level Policy Optimization for Multimodal Chain-of-Thought
- [논문리뷰] Look Light, Think Heavy: What Multimodal Chain-of-Thought Reasoning Can and Cannot Do
- [논문리뷰] Faithful GRPO: Improving Visual Spatial Reasoning in Multimodal Language Models via Constrained Policy Optimization
- [논문리뷰] FIPO: Eliciting Deep Reasoning with Future-KL Influenced Policy Optimization
- [논문리뷰] A Conditional No-Hair Theorem for Transformers: How Language Models Forget Their Prompt
Review 의 다른글
- 이전글 [논문리뷰] PaperCritic: Training AI Reviewers to Assess the Soundness of Papers
- 현재글 : [논문리뷰] Reflection Anchors for Propagation-Aware Visual Retention in Long-Chain Multimodal Reasoning
- 다음글 [논문리뷰] SALA: Semantically Aligned Latent Actions Enable Dual-Axis Scaling of Embodied Foundation Models
댓글