[논문리뷰] Beyond Answering: Learning to Speak First and Act in Streaming Video
링크: 논문 PDF로 바로 열기
저자: Shuhan Li, Huankang Guan, Xintong Guo, et al. (Huawei Research, HKUST, CUHK MMLab)
1. Key Terms & Definitions (핵심 용어 및 정의)
- MIC (Model-Initiated Conversation): 사용자 query가 없어도 모델이 계속 들어오는 visual stream과 이전 대화 context를 바탕으로 이야기할 만한 topic을 찾아내고, 적절한 시점에 먼저 말을 거는 기능입니다. AURA 2.0의 핵심 contribution입니다.
- SATC (Stream-Aware Tool Calling): 현재의 visual context와 대화 context를 바탕으로 external tool(예: WebSearch, get_city_weather)을 언제 호출할지, 어떤 tool을 쓸지, 어떤 argument를 넣을지 결정합니다. 반환된 결과는 이어지는 응답에 반영됩니다.
- IVG (Interactive Visual Grounding): 사용자가 video frame에 표시한 object를 모델이 인식하고, 모델도 응답 안에서 frame-aligned bounding box(
[x1,y1,x2,y2])를 출력하는 양방향 grounding 기능입니다. - LHIM (Long-Horizon Interaction Memory): 30초 active visual window를 벗어난 영상을 별도의 summarization MLLM으로 event 단위 textual QA 쌍으로 압축합니다. 이 기록은 시간이 지나면서 level-1 → level-2 → level-3로 점점 더 거칠게 병합되는 hierarchical memory입니다.
- Response-control tokens (
<|silent|>/<|respond|>): 모델은 1초 단위의 video chunk마다 침묵(<|silent|>)할지 응답(<|respond|>+ 텍스트 또는 tool call)할지를 이 token으로 결정합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문은 기존 streaming VideoLLM이 user-driven interaction에 머물러 있다는 한계를 해결하려 합니다. 영상 속 event가 대화할 만한 계기를 제공하더라도, 기존 모델은 사용자가 묻지 않으면 침묵합니다.
- 기존 접근의 범위: AURA, MMDuet2, JoyAI-VL-Interaction, MOSS-VL-Realtime 같은 기존 모델은 주로 "언제 응답할지"를 학습합니다. 응답은 여전히 사용자 질문, standing instruction, 사전에 정의된 monitoring rule을 조건으로 합니다.
- MIC가 없음: 저자들이 아는 한, 사전 요청 없이 open-ended 대화를 먼저 시작하도록 학습된 모델은 없습니다.
- 추가로 필요한 능력: 모델 자체 지식을 넘어서는 질문에 답하기 위한 tool use가 필요합니다. 또한 대화 속 지시 대상을 특정 object나 region에 연결하는 grounding이 필요합니다.
- 장기 context 유지: 긴 stream에서 visual context를 계속 늘리지 않고도 context continuity를 유지할 수단이 필요합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
AURA 2.0은 AURA의 streaming architecture를 계승하고, MIC·SATC·IVG와 LHIM을 하나의 chunk-wise interaction format 안에 통합합니다 [Figure 2].
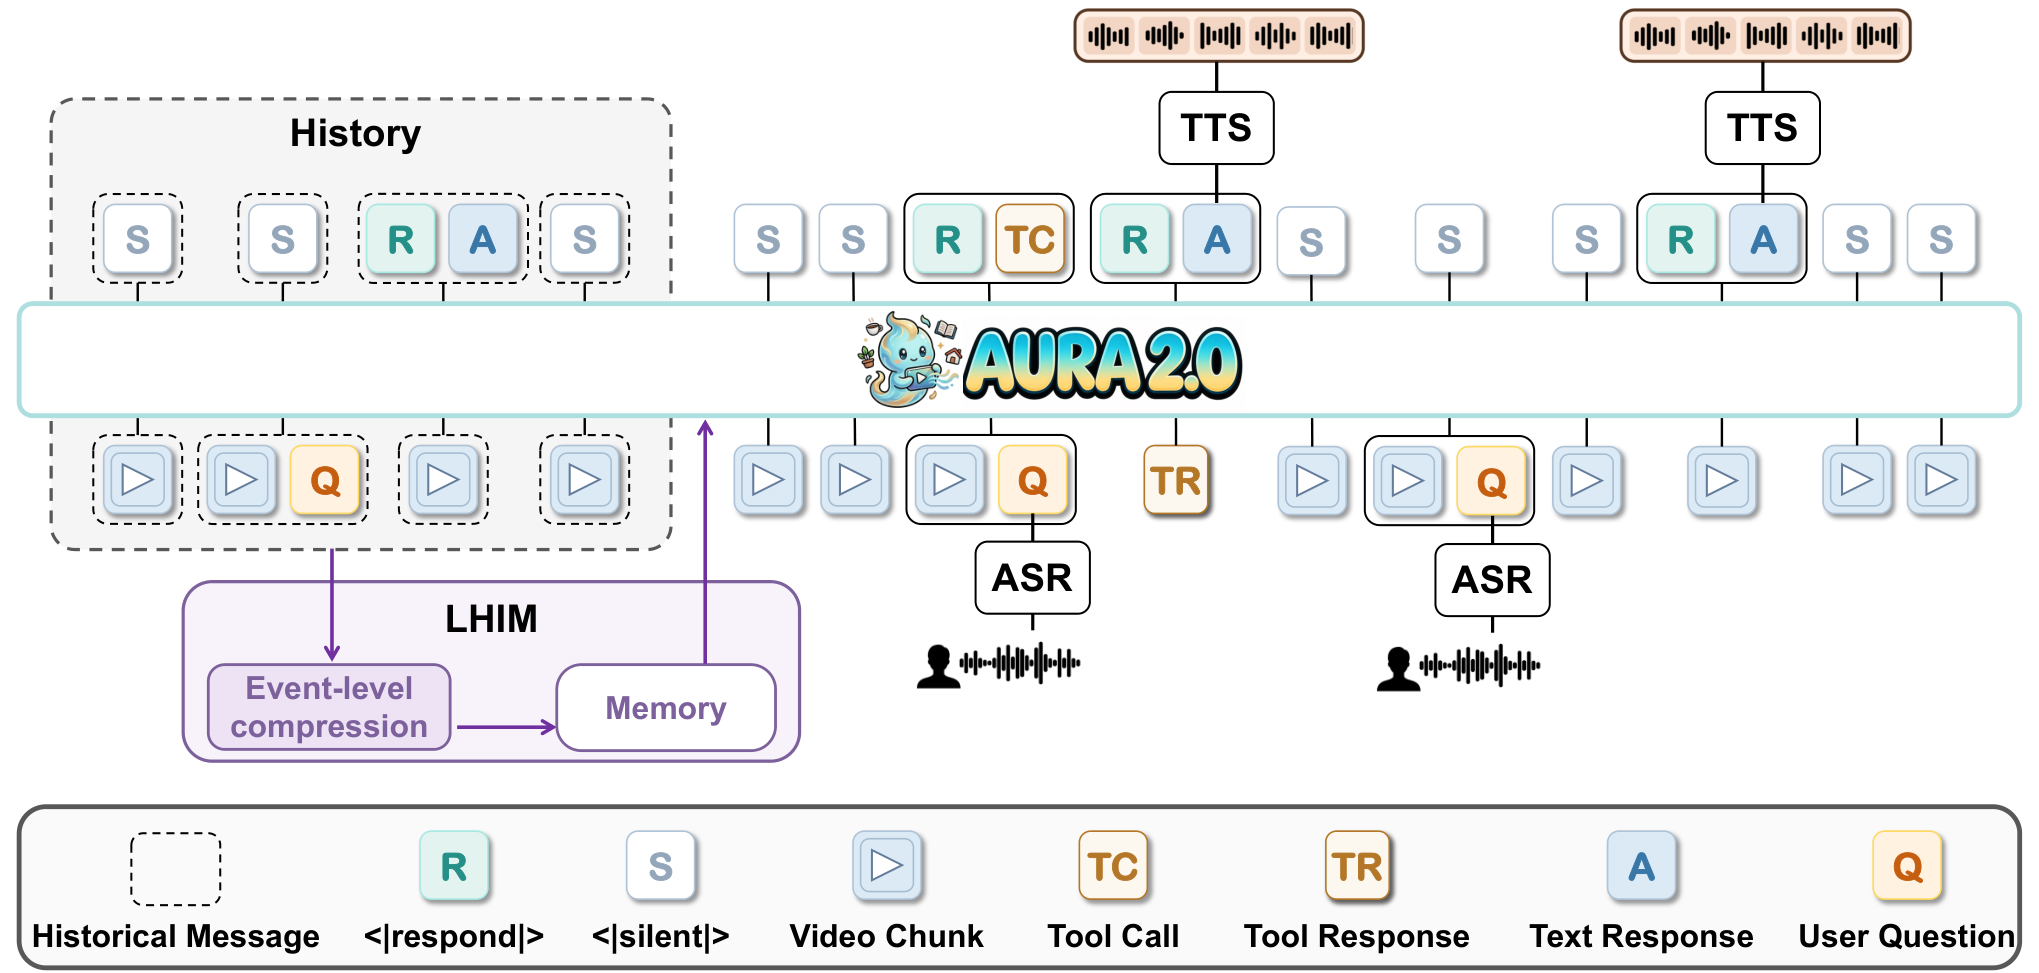
Figure 2 — AURA 2.0 전체 구조
방법론
- Interaction format: 모델은 매 video chunk마다
<|silent|>또는<|respond|>를 출력합니다. tool call과 bounding box도 같은 response content 형식으로 표현되므로, 하나의 response-control mechanism이 모든 행동을 제어합니다. - Data pipeline: MLLM 기반 synthesis와 sample-level verification을 거쳐 dataset을 구축했습니다 [Figure 3].
- 규모: 484,459 samples, 11.43B tokens, 약 5,400시간 영상, 40M frames
- 구성: MIC 11.8%, IVG 9.8%, SATC 5.3%
- IVG 데이터는 MeViS, Refer-YouTube-VOS 등 약 55,000개 trajectory로 만들었습니다.
- Training: Qwen3.5-9B에서 초기화한 뒤 three-stage curriculum으로 학습합니다.
- Stage 1: 기본 streaming QA와 SATC
- Stage 2: MIC와 IVG 추가, 앞 단계 데이터 replay
- Stage 3: 여러 capability를 결합한 데이터
- Response-control objective: 학습 데이터에서 silent target 비율이 94% 이상으로 매우 불균형합니다. 이를 완화하기 위해 control token에는 class-balanced normalization + focal weighting을 적용하고, 나머지 token에는 일반 cross-entropy를 씁니다.
- Serving: vLLM-Omni 기반입니다. 다음 세 가지 optimization을 적용했습니다.
- Session history caching과 prefix caching
- Silent input/output fast path
- Sentence-level TTS handoff
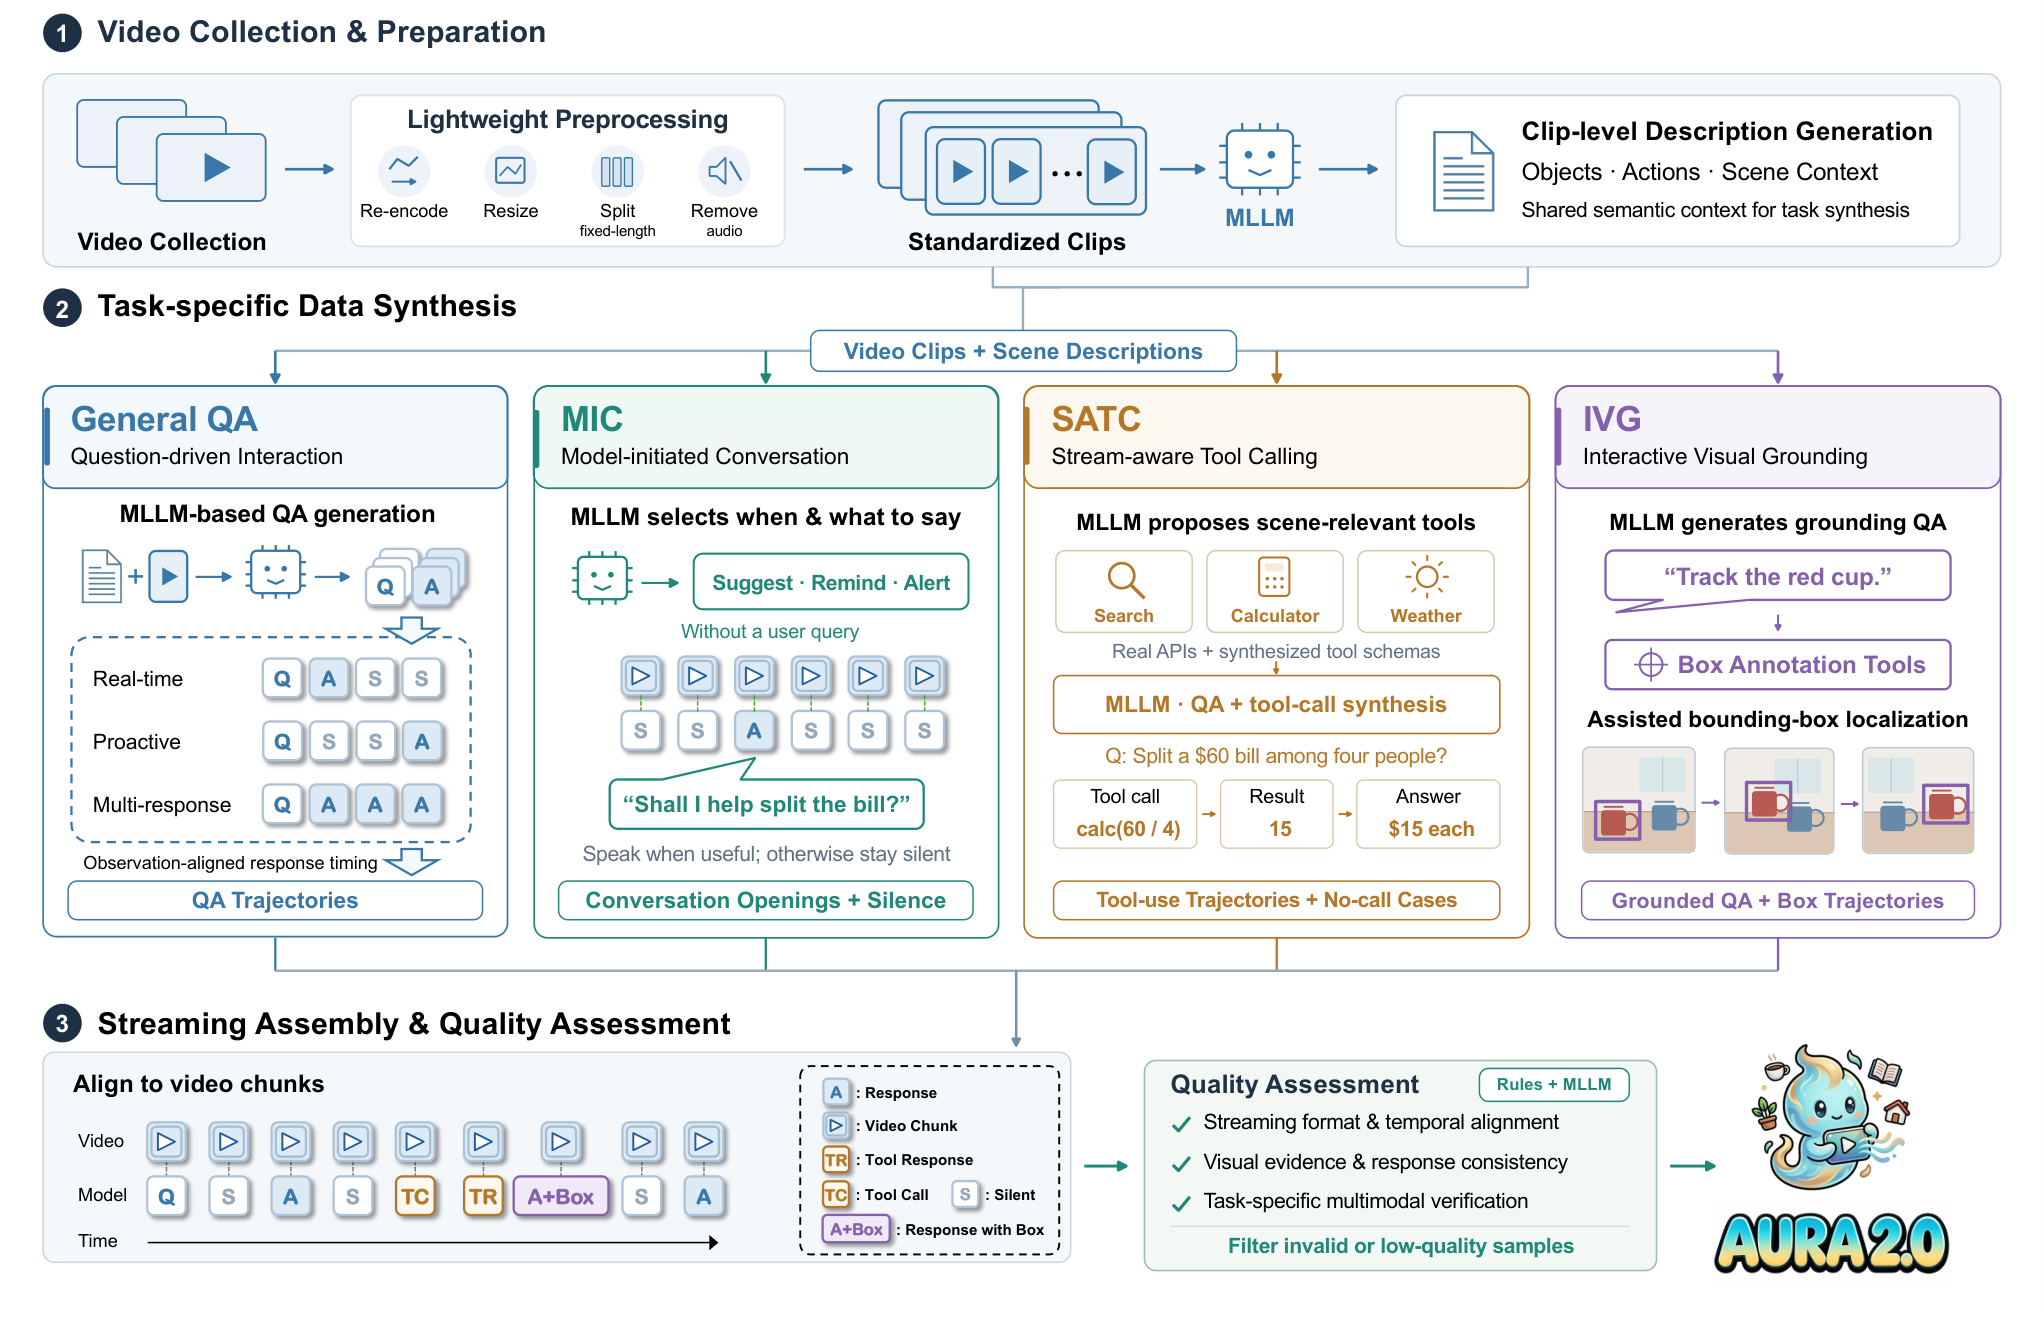
Figure 3 — 데이터 구축 파이프라인
핵심 결과
- PhoStream: Overall 65.69로 가장 높은 점수를 기록했고, 가장 강한 proprietary baseline인 Doubao-Seed-1.8보다 9.54점 높습니다.
- Forward score 56.22로 MOSS-VL-Realtime보다 37.95점 높습니다.
- Early Response rate는 1.30%로 가장 낮습니다. 다만 No Response rate가 23.90%로 남아 있어 응답 누락은 한계로 남습니다.
- ProactiveVideoQA (PAUC, ω=0.5): WEB/EGO/TV/VAD에서 58.8/53.1/49.3/41.8을 기록했습니다.
- 네 category 모두에서 JoyAI-VL-Interaction보다 높습니다.
- WEB·EGO·VAD에서 MOSS-VL-Realtime(TV 50.2)보다 높습니다.
- StreamArena: Proactive Interaction이 AURA의 3.7%에서 12.8%로 올랐습니다. Tool score는 18.5%로 MiniCPM-o 4.5(17.1%)보다 높습니다.
- IPIBench: Proactive Task Management 평균이 24.99%로, proprietary model을 포함한 전체 모델 중 가장 높습니다.
- MIC-Bench (internal): 기능 작동 사례는 [Figure 5]에서 볼 수 있습니다.
- Visual-Dialogue Context: trigger rate 80.0%, quality 4.10/5
- Visual-Only Context: trigger rate 96.0%, quality 3.62/5
- SATC (internal): tool을 켜면 accuracy가 35.9% → 48.5%로 +12.6%p 상승합니다.
- IVG (COCO 50장): backbone Qwen3.5-9B와 비교한 결과는 다음과 같습니다.
- mIoU: 0.635 → 0.906
- Accuracy: 76.0% → 94.0%
- Latency: 단일 session에서 TTFT 157ms, TTFP 344ms입니다. 16개 동시 session에서도 TTFP는 약 0.6s입니다. 세 가지 optimization을 합치면 TTFP가 54.6% 줄어듭니다.
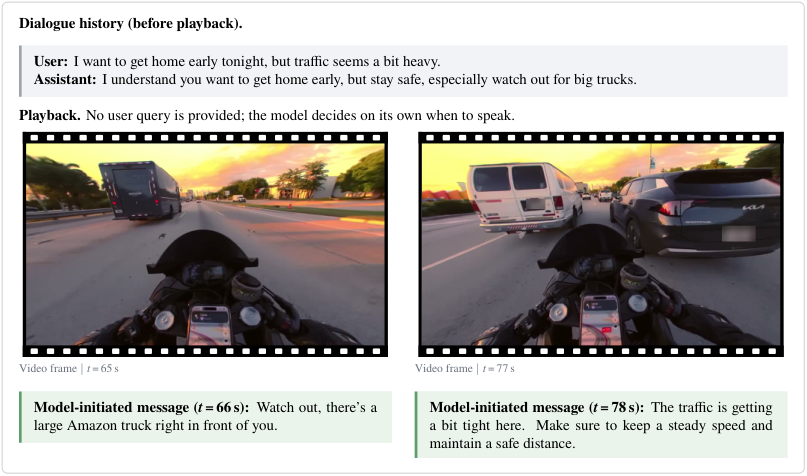
Figure 5 — MIC 대화 사례
4. Conclusion & Impact (결론 및 시사점)
AURA 2.0은 streaming VideoLLM을 "답하는 모델"에서 "먼저 말하고 행동하는 assistant"로 확장했습니다. 이를 위해 MIC, SATC, IVG, LHIM을 하나의 framework로 통합했습니다. 네 개의 public streaming benchmark에서 open-source streaming model 중 선도적인 성능을 보였고, 특히 response timing(Early Response 억제)에서 강점을 보였습니다.
한계
- MIC의 유용성은 topic, timing, 발화 빈도에 대한 개인 선호에 따라 달라지는 주관적인 문제입니다.
- MIC 평가는 25개 영상 규모의 internal benchmark에서만 이루어졌습니다.
- 현재 시스템은 cascaded ASR–VideoLLM–TTS pipeline입니다.
시사점
- 학계에는 proactive conversation initiation이라는 새로운 연구·평가 축을 제시합니다.
- 산업계에는 실시간 AR/모바일 assistant에서 low-latency로 배포할 수 있는 설계 방향을 보여줍니다.
- 저자들은 향후 omni-modal, full-duplex 모델로 확장할 계획을 밝혔습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] AURA: Always-On Understanding and Real-Time Assistance via Video Streams
- [논문리뷰] JoyAI-VL-Interaction: Real-Time Vision-Language Interaction Intelligence
- [논문리뷰] OneStreamer: Unifying Perception, Memory, and Proactive Response in Streaming Video Interaction
- [논문리뷰] StreamArena: Toward Continuous, Interactive, and Long-Horizon Agentic Streaming Video Understanding
- [논문리뷰] Vinci2: Providing Proactive Assistance in Continuous Egocentric Videos
Review 의 다른글
- 이전글 [논문리뷰] AuXSpec: Learning to Autoformalize Program Specifications via Executable Postconditions
- 현재글 : [논문리뷰] Beyond Answering: Learning to Speak First and Act in Streaming Video
- 다음글 [논문리뷰] Breath-Dx: A Time Series Classification Benchmark for Disease Screening with eNose
댓글