[논문리뷰] MillBill: A Machining Agent with Geometric Feedback
링크: 논문 PDF로 바로 열기
저자: Gennadii Savrasov, Artem Slavin, Soslan Kabisov, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Geometric Harness: Toolpath 생성(FreeCAD CAM), material-removal simulation, surface-deviation 측정을 맡는 알고리즘 기반 실행·검증 모듈입니다. LLM은 coordinates, offsets, swept volume을 직접 계산하지 않고, 이 계산은 모두 harness가 처리합니다.
- Code-writing Frontier Agent: 논문의 주요 baseline입니다. Frontier LLM이 STEP 파일을 읽고 Python으로 geometry·toolpath 코드를 직접 작성·실행해 G-code를 출력합니다.
- Reach-aware Setup Planning: Visibility만 보지 않고, cutter의 usable length와 holder overhang까지 고려해 실제로 도달 가능한(reachable) 영역을 기준으로 indexed three-axis setup(6개 축 방향 ±x, ±y, ±z)을 greedy 방식으로 고르는 기법입니다.
- Acc_τ: 시뮬레이션으로 가공된 workpiece에서 target surface 면적 가운데 tolerance τ 안에 드는 비율입니다. 표면 법선 방향으로 probe해서 excess(남은 재료)도 gouge(과절삭)도 없는 점의 면적 가중 비율로 계산합니다.
- AAGNet: B-rep의 geometric attributed adjacency graph에서 face 단위 machining feature를 semantic segmentation과 instance segmentation으로 나누는 GNN입니다. MFInstSeg의 24개 class로 학습되었습니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문이 다루는 문제는 CAD(B-rep) 모델에서 CNC G-code를 만드는 과정에서, 기존 LLM 기반 접근이 geometry를 검증하지 않거나 정밀한 수치 계산까지 LLM에게 맡긴다는 점입니다. LLM process planner(CAPP-GPT, ARKNESS, Design-to-Plan)는 operation sequence와 cutting parameter만 내놓고 toolpath 단계 전에 멈추므로, 계획이 실제 part에 대해 실행·검증되지 않습니다. 반대로 LLM이 G-code나 geometry 코드를 직접 쓰는 방식(GLLM, code-writing frontier agent 등)에서는 숫자 하나만 틀려도 프로그램은 돌아가지만 엉뚱한 part가 가공됩니다. 저자들은 code-writing agent의 오류가 주로 ±x/±y setup의 좌표 변환과 tool offset에서 생긴다고 분석했습니다. CNCGEN은 대규모 machining training set이 필요하고 코드도 공개되지 않았습니다. 그래서 저자들은 machining decision(process knowledge)과 geometric execution(정밀 계산)을 서로 다른 메커니즘으로 분리해야 한다고 주장합니다. 또한 수치 계산 부담을 덜어 주면 locally hosted mid-sized open model만으로 충분하다고 보고, 이 경우 proprietary part를 외부로 보낼 필요가 없다는 점도 동기로 듭니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들이 제안하는 MillBill에서는 LLM이 machining decision만 내리고, geometric harness가 이를 실행·시뮬레이션·검증한 뒤 feedback을 돌려줍니다 [Figure 1]. 파이프라인은 다음과 같습니다.
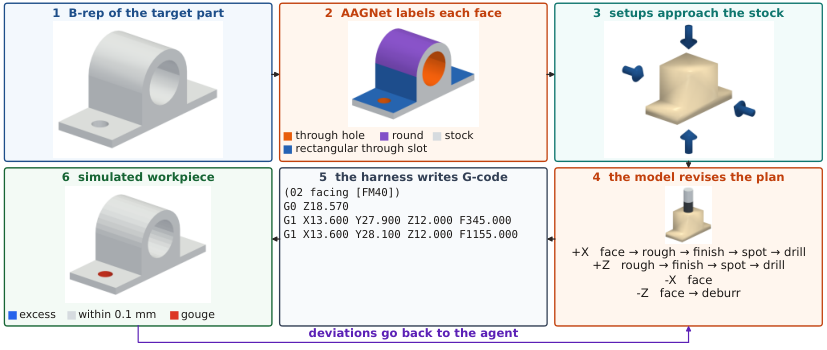
Figure 1 — MillBill 전체 구조
- (1) Feature recognition: AAGNet으로 face별 feature class를 예측하고, hole 직경, pocket 깊이, 최소 corner radius 같은 치수는 FreeCAD에서 B-rep을 기준으로 직접 측정합니다.
- (2) Reach-aware setup planning: 제거 대상 volume(Stock \ Part)을 voxel로 나눈 뒤, 남아 있는 (holder overhang, reach) pair마다 height-map dilation을 한 번씩 수행해 tool library 전체의 도달 가능성을 판정합니다. 이렇게 하면 깊고 좁아서 보이기는 하지만 닿지 않는 영역을 걸러낼 수 있습니다.
- (3) LLM 의사결정: Knowledge retrieval → Process sequence → Tool & cutting parameter의 3단계 ReAct agent가 standard-practice reference plan을 수정합니다. 선택한 tool은 library에 존재해야 하고, speed와 feed는 machine limit 안으로 clamp됩니다. 기준 cutting data는 Kienzle force model로 계산합니다.
- (4) Toolpath & G-code: FreeCAD CAM과 height map 기반 roughing/finishing으로 toolpath를 만들고, dexel 기반 gouge check를 거칩니다.
- (5) Exact simulation: workpiece를 discretize하지 않습니다. 대신 analytically swept cutter를 기준으로 query point를 정확히 판정하고, Acc_τ를 계산합니다.
- (6) Refinement: 오차를 feature와 operation 단위로 귀속시킵니다. harness가 rest finishing 같은 자동 보정을 먼저 적용하고, 남은 결함은 LLM에 되돌려 fixed action space 안에서 수정하게 합니다. build는 최대 3회까지 반복하며, 그중 best build를 유지합니다.
주요 정량 결과 (GrabCAD에서 뽑은 100개 part, τ = 0.1 mm):
- Qwen3.8-27B(FP8, 로컬 H100 4장)를 쓴 MillBill의 Acc_τ는 97.4%입니다. GPT-6 Astra code-writing agent는 94.3%, Claude Opus 5.5 agent는 83.0%, CNC-Net은 42.3%였습니다.
- Gouge 면적은 MillBill 0.54%로, best baseline의 1.50%보다 작습니다. Excess 면적도 2.1%로 GPT-6 Astra의 4.2%보다 작습니다.
- 같은 Qwen3.8-27B를 code-writing agent로 쓰면 7.9%(82/100 part만 채점 가능)에 그칩니다. 이는 가공하지 않은 stock 상태(10.6%)보다도 낮습니다. 성능 향상이 모델 자체보다 아키텍처 분리에서 나온다는 뜻입니다.
- Ablation에서 LLM 없이 reference plan만 실행해도 97.0%가 나왔습니다. 성능 대부분이 harness에서 나온다는 의미입니다. LLM을 넣으면 +0.35 pp(95% CI [0.09, 0.68]) 오르고 gouge는 0.77% → 0.54%로 줄어듭니다. 다만 저자들에 따르면 gouge 감소는 single-setup part 10개에서 나왔고, multi-setup part 90개에서는 차이가 없었습니다(0.46% vs 0.45%).
- Setup을 +z 단일 setup으로 고정하면 Acc_τ가 66.4%로 떨어집니다. Reach-aware setup planning이 핵심 요소임을 보여 줍니다.
- Build budget을 1회 → 2회 → 3회로 늘리면 Acc_τ는 95.6% → 97.2% → 97.4%로 오릅니다.
- Tolerance를 0.2 mm와 0.5 mm로 완화하면 MillBill이 계속 앞섭니다(98.0%/98.1% vs 95.3%/95.6%). 반면 0.05 mm에서는 GPT-6 Astra가 근소하게 앞섭니다(90.2% vs 89.3%).
- 정성 비교에서도 baseline은 넓은 excess를 남기거나 cylindrical boss를 gouge했고, MillBill은 좁은 영역에만 잔여 오차를 남겼습니다 [Figure 3].
- part당 평균 소요 시간은 16.1분입니다. 이 중 CAM 생성과 그 검사에 12.1분, planning에 1.4분이 듭니다.
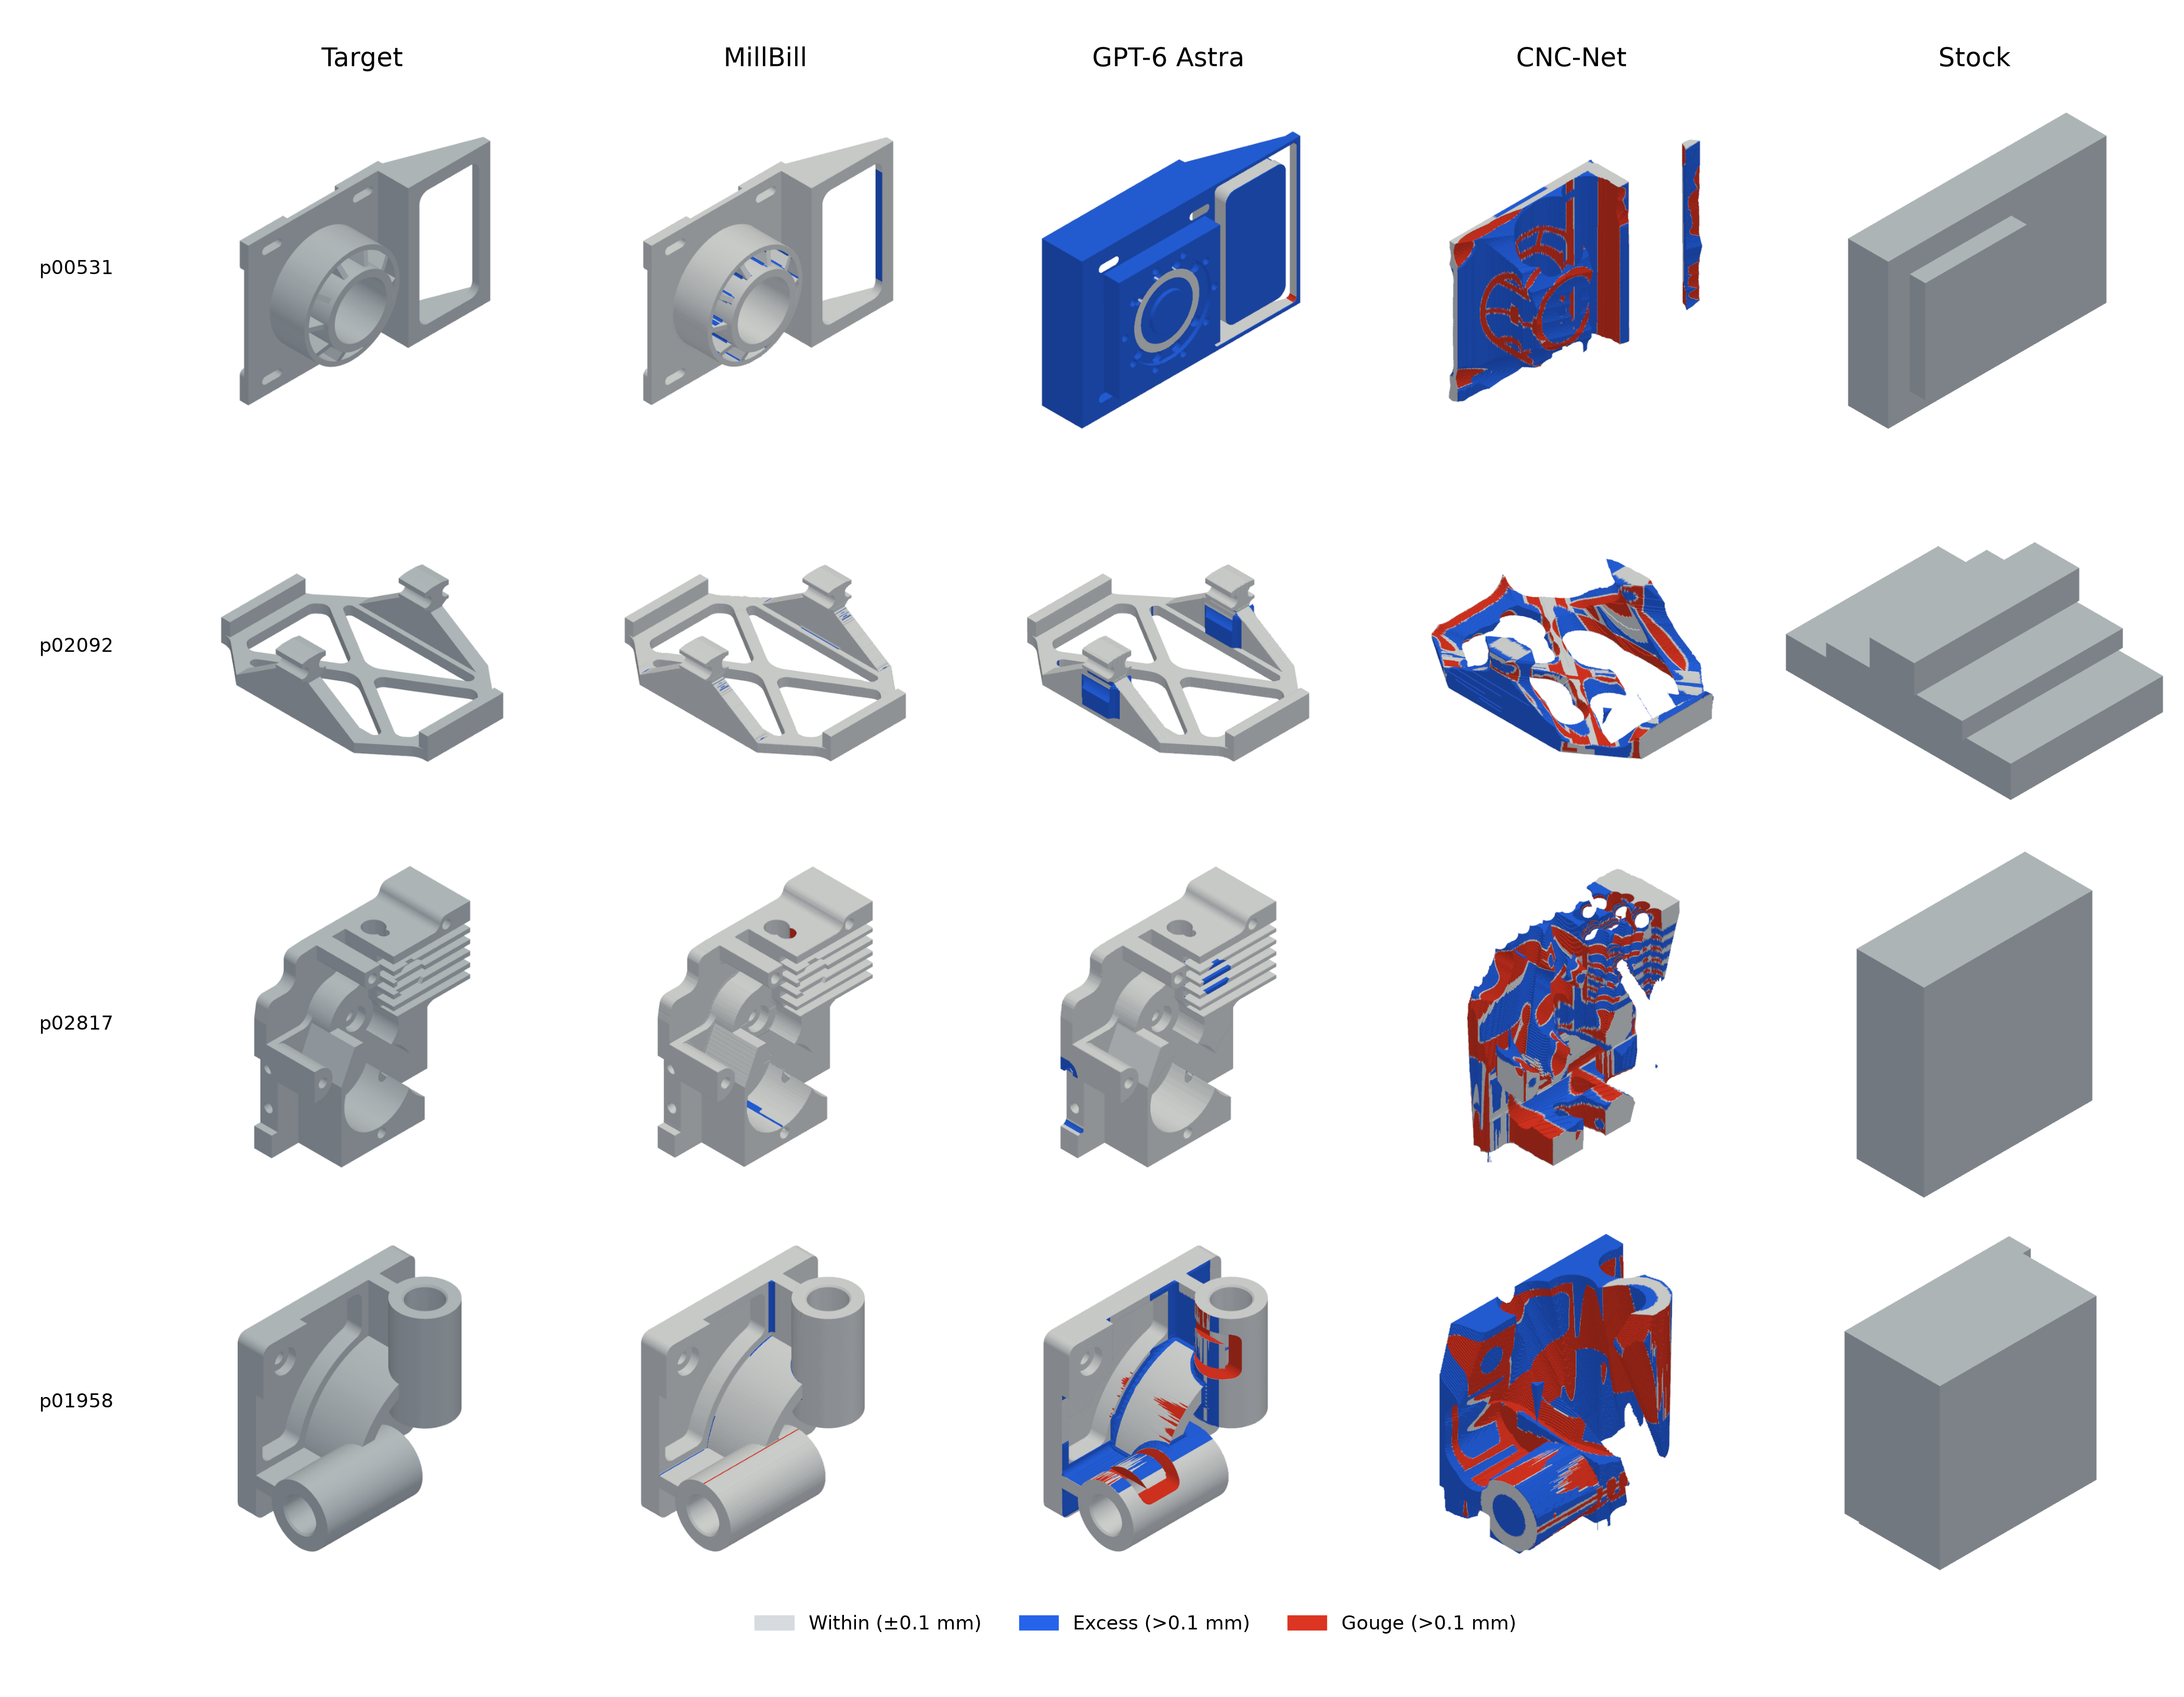
Figure 3 — 시뮬레이션 가공 비교
4. Conclusion & Impact (결론 및 시사점)
MillBill은 machining decision과 geometric execution을 분리하는 방식으로, 27B open model만으로도 frontier model 기반 code-writing agent보다 높은 가공 정확도(97.4% vs 94.3%)를 냈습니다. 다만 성능 대부분은 geometric harness에서 나오고, LLM이 더한 기여는 0.35 pp 수준으로 작습니다. 저자들은 4,294개 GrabCAD part와 milling stock을 짝지은 open benchmark를 공개했고, 어떤 planner의 G-code든 시뮬레이션으로 채점할 수 있는 평가 프로토콜도 함께 제시했습니다.
한계도 분명합니다.
- 6개 주축 방향의 indexed three-axis 가공만 지원합니다.
- Workholding, fixture 충돌, machine travel은 모델링하지 않습니다.
- Tool deflection, vibration, wear는 시뮬레이션에 반영되지 않습니다.
- Thread는 계획만 하고 검증하지 않습니다.
- 평가는 단일 library의 part 100개에 대해 method와 part별로 1회씩만 실행했습니다.
산업적으로는 proprietary CAD 데이터를 외부 API로 보내지 않고 로컬 모델로 CAM을 자동화할 수 있다는 가능성을 보여 줍니다. 더 일반적으로는 LLM agent 설계에서 "모델이 정밀 수치 계산을 직접 하게 하기보다 검증 가능한 도구에 위임하라"는 원칙을 뒷받침하는 사례입니다. 저자들이 밝힌 후속 과제는 five-axis setup, workholding, thread와 surface finish 검증입니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
Review 의 다른글
- 이전글 [논문리뷰] MedJev: A System One Vision-Language Decision Model for Fast and Effective Medical Image Understanding
- 현재글 : [논문리뷰] MillBill: A Machining Agent with Geometric Feedback
- 다음글 [논문리뷰] Multi-Branch Transformer
댓글