[논문리뷰] AuK Technical Report: An Open-Source Foundational Model for Speech Generation and Editing
링크: 논문 PDF로 바로 열기
I have successfully browsed the paper. Now I will extract the information and construct the summary following the given constraints.
Authors: Ziyang Ma, Zhikang Niu, Wenming Tu, Tianrui Wang, Ruiqi Yan, Junxi Liu, Yanru Huo, Nickk Huang, Yang Liu, Qicong Xie, Zeyu Xie, Hui Wang, Haitao Li, Zixuan Jiang, Yalin Li, Jie Fang, Yifan Duan, Zeyue Tian, Guangzheng Li, Haina Zhu, Shuyi Wang, Jinwen Wang, Mingyu Cui, Tian Tan, Auden, Sen Liang, Steve Yves, Shan Yang, Liefeng Bo, Zilong Zheng, Kai Yu, Eng-Siong Chng, Xie Chen
I need to shorten this list for the metadata. The instruction says "제1저자, 제2저자, et al.". So I will use "Ziyang Ma, Zhikang Niu, et al.".
Keywords: From the abstract and introduction, I can infer keywords like Foundational Model, Speech Generation, Speech Editing, Multimodal Language Model (MLLM), Variational Autoencoder (VAE), Rectified Flow Transformer, Instruction-Guided, Open-Source. I will select 5-8 standard academic terms.
Figures to select:
- Figure 1: Performance comparison with SOTA models across speech generation, editing, enhancement and separation. (This is a summary figure, good candidate)
image_url:https://arxiv.org/html/2609.08936v1/fig/FIG_ALL.pngcaption_kr: "다양한 작업에 대한 성능 비교"
- Figure 2: Versatile speech generation and editing capabilities of AuK. (This shows the capabilities, good candidate)
image_url:https://arxiv.org/html/2609.08936v1/fig/capability.pngcaption_kr: "AuK의 다목적 기능"
- Figure 4: Architecture of AuK. (This shows the model design, very good candidate)
image_url:https://arxiv.org/html/2609.08936v1/model.pngcaption_kr: "AuK 모델 아키텍처"
I will now proceed with drafting the summary.
Part 1: Summary Body
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- Foundational Model: 광범위한 Downstream Task를 처리하기 위해 대량의 비정형 데이터로 Pre-train된 대규모 모델로, 본 논문에서는 Speech Generation 및 Editing Task를 통합적으로 수행한다.
- MLLM (Multimodal Large Language Model): Textual Instruction과 Audio Context를 Jointly Processing하여 Semantic Condition을 생성하는 모델로, AuK의 Conditioning Stream 중 하나를 담당한다.
- VAE (Variational Autoencoder): Audio를 Latent Space로 Encoding하고 Waveform을 Reconstruction하는 데 사용되는 모델로, Reference Audio Conditioning 및 Acoustic Latent Space를 제공한다.
- Rectified Flow Transformer: Noise에서 Target Latent로 직접 이동하는 Vector Field를 학습하는 Generative Model의 Backbone으로, Dual-Stream MMDiT 및 Single-Stream DiT Block으로 구성되어 Speech Generation 및 Editing을 수행한다.
- Classifier-Free Guidance (CFG): Inference 시 Unconditional Model과 Conditional Model의 Output을 보간하여 Sampling Quality를 향상시키는 기법이다. AuK-Flash는 Inference Cost 절감을 위해 CFG 없이 4-Step Inference를 수행한다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 기존의 Speech Generation 및 Editing 시스템들은 Zero-shot Voice Cloning, Instruction-controlled Synthesis, Flexible Speech Editing 등 다양한 기능을 제공하지만, 각각의 기능이 Task-specific 모델로 분리되어 사용자 경험의 단편화와 중복된 모델링 노력을 초래한다. 이러한 기존 연구의 한계점은 출력 제약의 근본적인 차이, Conditioning Interface의 다양성, 그리고 Supervision 및 Evaluation의 이질성이라는 세 가지 주요 도전 과제로 인해 통합 모델 개발이 어려웠다. 예를 들어, Generation은 새로운 Speech를 생성하는 반면 Content Editing은 선택된 영역만 변경해야 하며, Paralinguistic 및 Acoustic Editing은 Linguistic Content를 보존해야 하는 등 Task별로 Output Constraints가 상이하다. 또한, 일부 Task는 Text만으로 충분하지만 다른 Task는 Instruction과 Source 또는 Reference Audio를 Jointly Reasoning해야 한다. 이러한 문제들을 해결하기 위해 본 논문은 Free-form Instruction을 해석하고 요청된 Speech를 생성할 수 있는 통합 모델의 필요성을 강조한다.
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 본 논문은 Speech Generation 및 Editing을 통합하는 Open-source Foundational Model인 AuK를 제안한다. AuK는 Natural-language Instruction과 Audio Context를 공통 Interface로 사용하여 광범위한 Capability Set을 지원하며, 약 30.3억 개의 Instruction–Audio Instance와 195만 시간의 Effective Supervision 데이터로 학습된다. 모델 아키텍처는 MLLM (Multimodal Large Language Model) Semantic Encoder, Speech, General Audio, Music에 대해 Jointly Train된 AuK-VAE (Variational Autoencoder), 그리고 Hybrid Rectified-Flow Transformer로 구성된다. MLLM은 Text 단독 또는 Text와 Reference Audio를 Jointly Encode하여 Semantic Condition을 생성하며, AuK-VAE는 Acoustic Latent Space를 제공한다. Transformer Backbone은 Dual-Stream MMDiT Block과 Single-Stream DiT Block을 사용하여 Semantic 및 Acoustic Stream 간의 정보를 교환하고 Target Latent의 Flow Velocity를 예측한다 [Figure 4, cite: 1].
훈련은 Generation-only Warm-up으로 시작하여 Joint Generation–Editing Pre-training으로 진행되며, 이후 Human-feedback Preference Optimization for Editing 및 Reward-based Reinforcement Learning for Generation이라는 보완적인 Post-training 전략을 적용한다. Inference Cost를 줄이기 위해 Consistency Initialization 및 Task-routed Decoupled DMD를 통해 모델을 Distill하여 AuK-Flash를 생성한다. AuK-Flash는 Classifier-Free Guidance 없이 4-step Inference를 수행하며, Full Model 대비 4.5배의 Wall-clock Speedup을 달성한다 [Table 2, cite: 1].
실험 결과, AuK는 Zero-shot 및 Instruction-controlled Speech Generation에서 WER (Word Error Rate) 2.65% (AuK) 및 SIM (Speaker Similarity) 0.795 (AuK)를 기록하며 SOTA (State-of-the-Art) 성능을 달성했다 [Table 3, cite: 1]. 특히, Seed-TTS-Eval 벤치마크에서 기존 최고 Baseline인 Qwen3-TTS의 WER 3.07%를 2.65%로 감소시켰고, Seed-TTS의 SIM 0.778을 0.795로 향상시켰다. 일반 Instruction-guided Editing Task에서는 MMAE-Speech 벤치마크에서 IFR (Instruction Following Rate) 48.23%, CR (Consistency Rate) 88.11%를 달성했으며, AuK-Flash는 EMR (Exact Match Rate) 13.85%로 가장 높은 점수를 기록했다 [Table 3, cite: 1]. Speech Enhancement 및 Separation Task에서는 DNS Challenge에서 WER 2.66%로 가장 낮은 Error Rate를 보였고, SIM은 0.99를 달성하며 경쟁적인 성능을 유지했다 [Table 3, cite: 1]. AuK-VAE는 Speech, General Audio, Music 세 가지 도메인 모두에서 PESQ, STOI, Mel Dist, STFT Metrics에서 최상의 Reconstruction Quality를 보여주었다 [Table 4, cite: 1].
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 Speech Generation 및 Editing을 위한 Open-source Foundational Model인 AuK를 성공적으로 제안하였다. 이 모델은 Natural-language Instruction과 Audio Context를 기반으로 다양한 Speech Task를 통합적으로 처리하며, 광범위한 데이터셋과 다단계 훈련 전략을 통해 높은 성능을 달성했다. 특히, AuK는 Zero-shot 및 Instruction-controlled Speech Generation, 그리고 Instruction-guided Editing 벤치마크에서 SOTA 성능을 입증했으며, Signal-level Restoration Task에서도 경쟁력을 유지한다. Inference Speed를 향상시킨 AuK-Flash는 Full Model 대비 4.5배 빠른 4-step Inference를 지원하며, 광범위한 Generation 및 Editing Capability를 유지한다. 이러한 연구는 Speech Technology 분야에서 Unified Model의 가능성을 보여주며, Cross-utterance, Cross-task, Cross-lingual Transfer와 같은 Emergent Capability를 통해 범용 오디오 AI 시스템 개발에 중요한 시사점을 제공한다. 하지만, Free-form Instruction에 대한 Native Understanding과 Compositional Generalization은 여전히 개선이 필요한 영역으로, 향후 연구에서는 Prompt Enhancer에 대한 의존도를 줄이는 방향으로 발전해야 할 것이다. 본 연구는 Source Code와 Model Weights를 공개하여 학계 및 산업계의 추가 연구와 발전을 장려한다.
Figure 1 — 다양한 작업에 대한 성능 비교
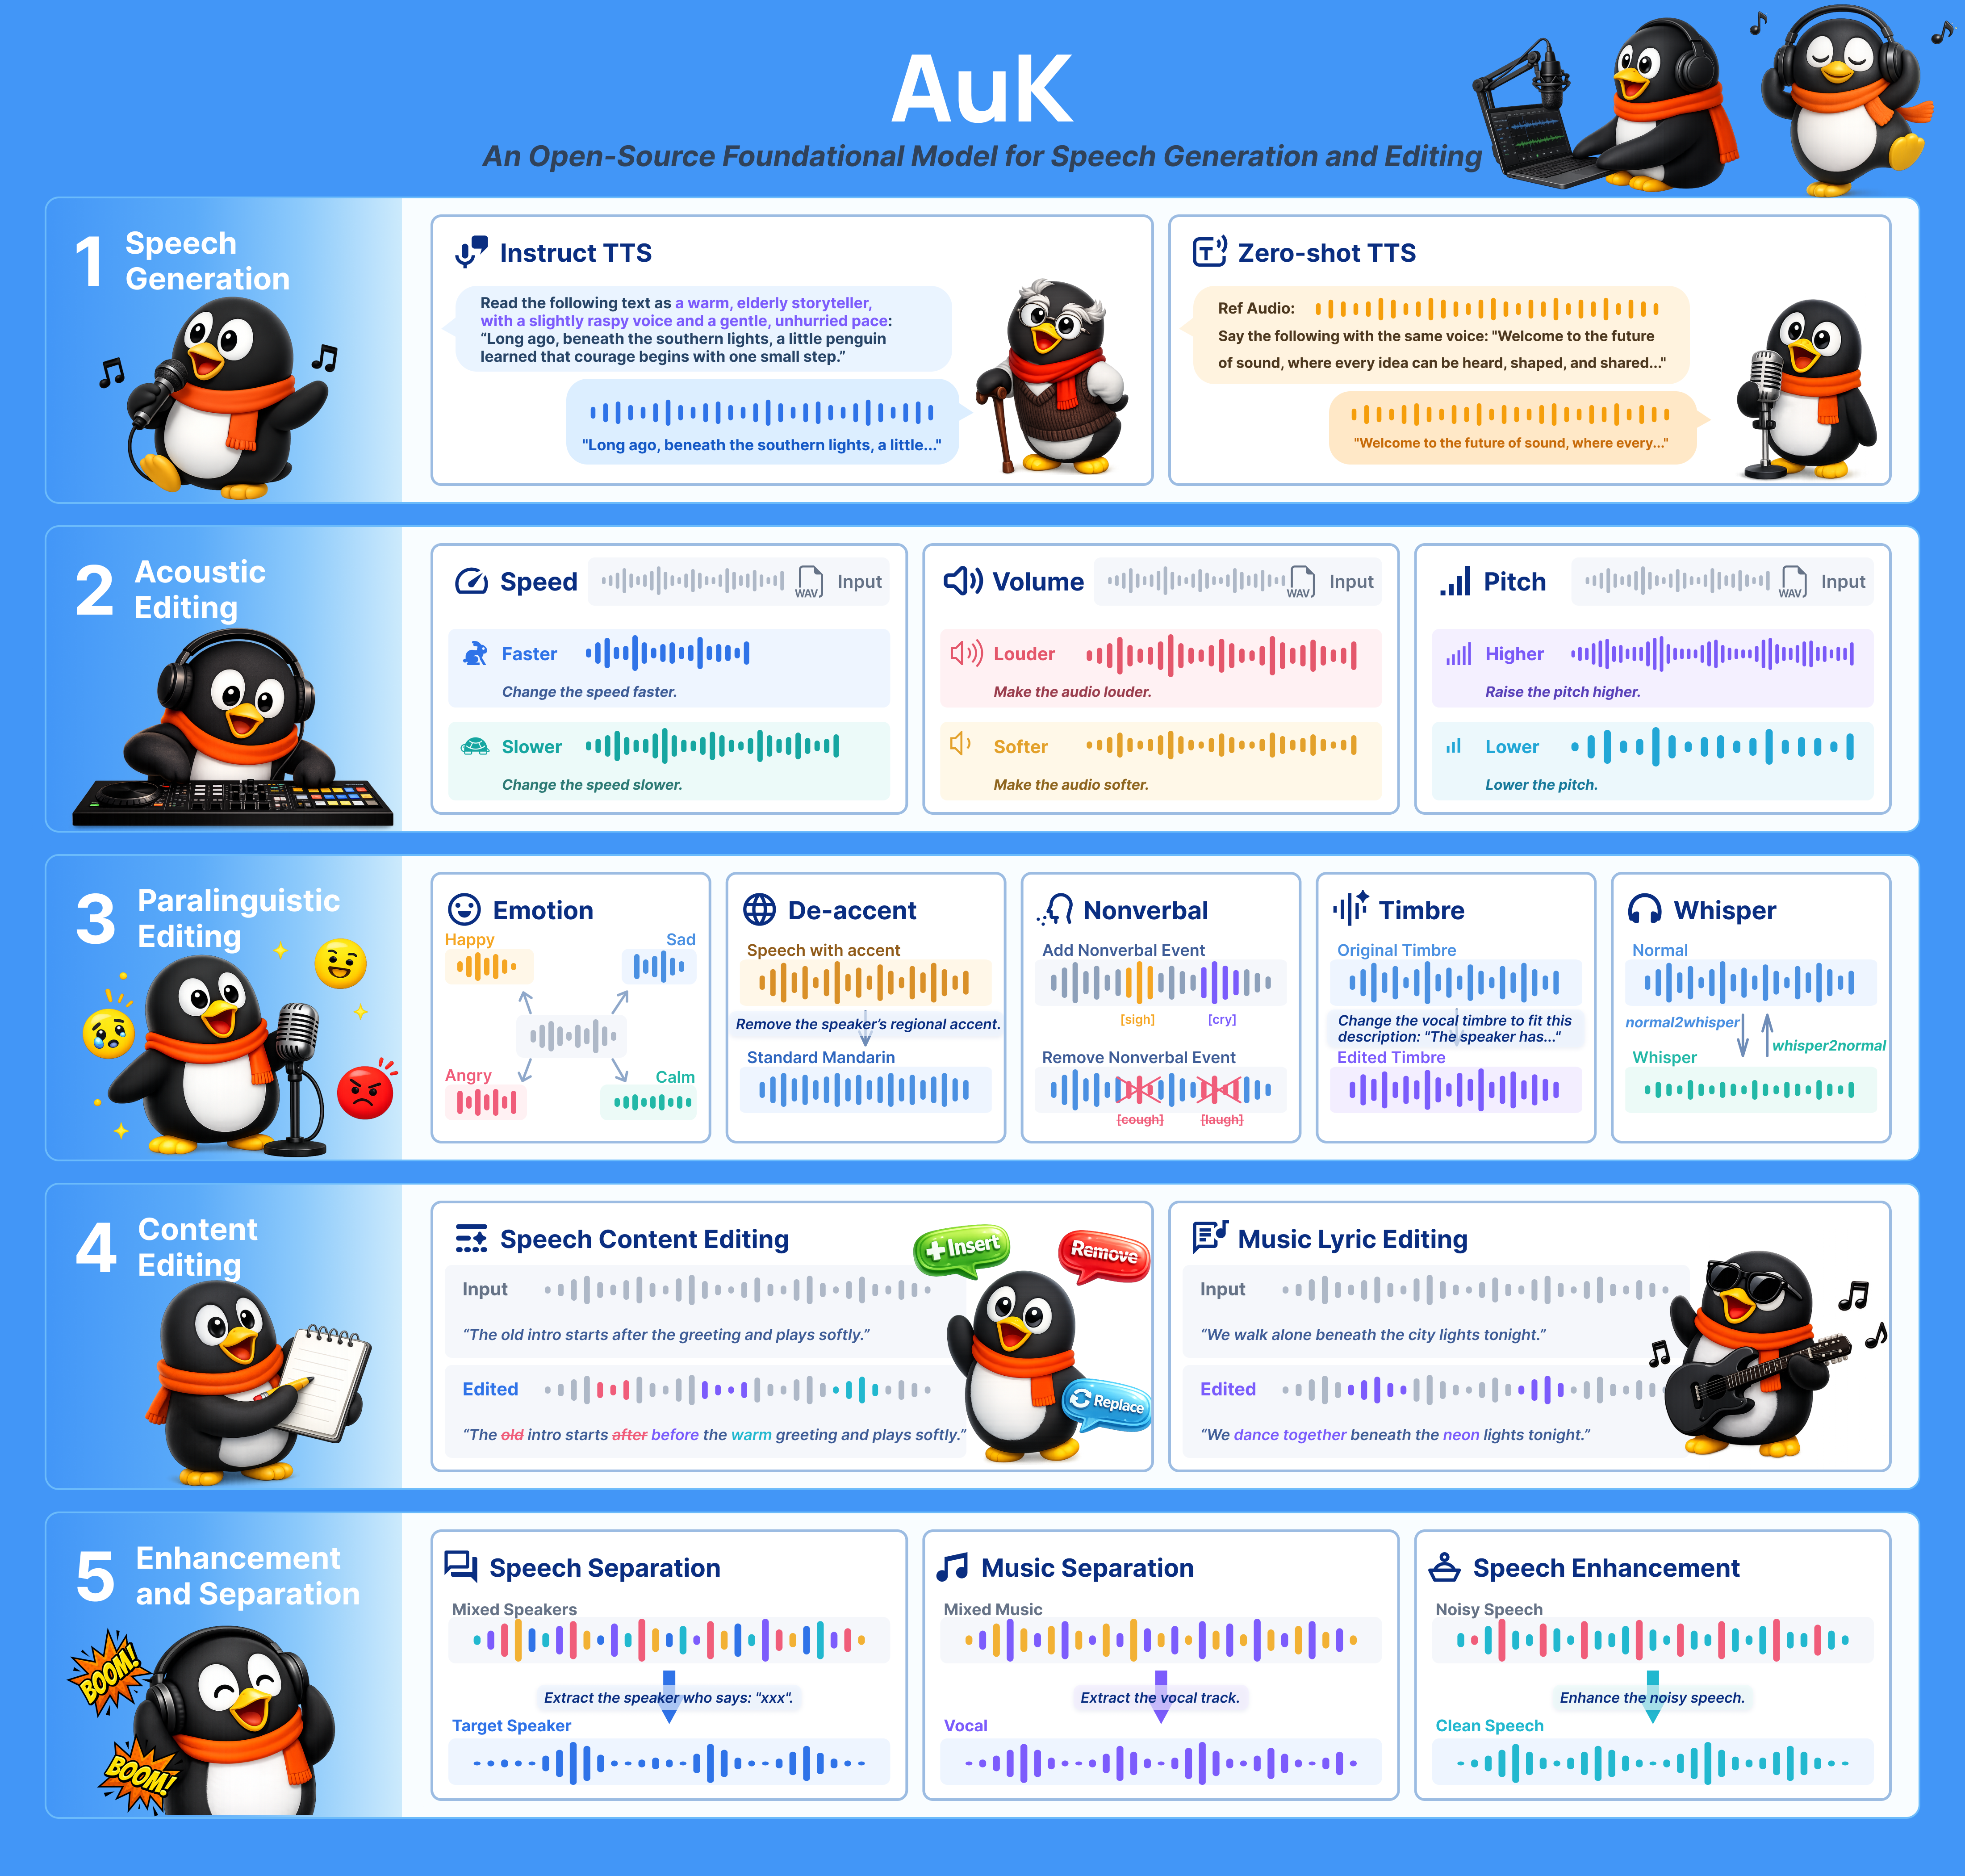
Figure 2 — AuK의 다목적 기능
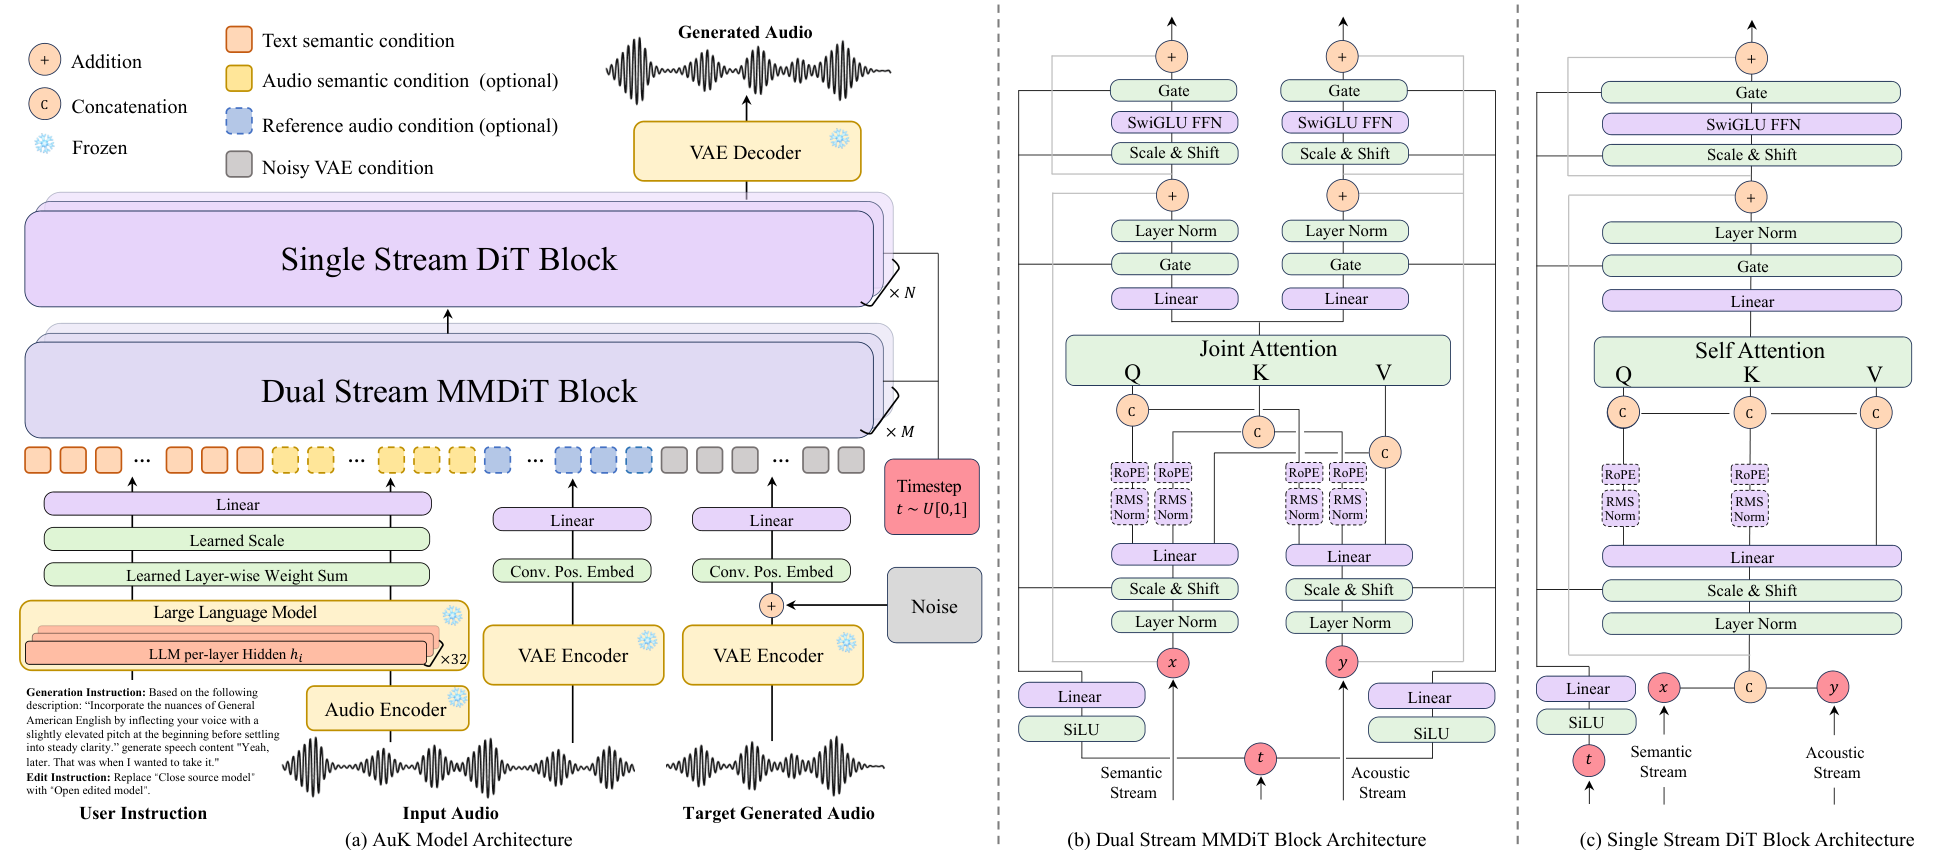
Figure 4 — AuK 모델 아키텍처
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] X-AuT: Progressive Audio-Encoder Compression for Speech LLMs with Cross-Scale Distillation
- [논문리뷰] World in World: Explore the World with World Models
- [논문리뷰] UniH^3: Unifying Hierarchical Homogeneity and Heterogeneity for All-in-One Medical Image Restoration
- [논문리뷰] SpatialBlock: Enhancing Spatial Intelligence in LVLMs via Synthetic Block-Stacking Problem
Review 의 다른글
- 이전글 [논문리뷰] Agentic Visual Generation: From Generative Models to Agentic Control
- 현재글 : [논문리뷰] AuK Technical Report: An Open-Source Foundational Model for Speech Generation and Editing
- 다음글 [논문리뷰] BeaconKV: Key-Value Cache Compression Guided by Beacon Queries for Efficient Large Reasoning Model Inference
댓글