[논문리뷰] VidaForge: Open Research Infrastructure for Video Pretraining Data Recipes
링크: 논문 PDF로 바로 열기
메타데이터
저자: Yan Ma, Jiadi Su, Zhulin Hu, Ethan Chern, Linhao Zhang, Tiantian Mi, Pengfei Liu
1. Key Terms & Definitions (핵심 용어 및 정의)
- Data Recipe: Raw video 데이터를 모델 학습에 적합한 데이터셋으로 변환하는 일련의 5단계 변환 과정(Ingestion, Segmentation, Selection, Annotation, Packaging)을 지칭합니다.
- Attribution-ready: 모든 학습 샘플이 어떤 가공 과정을 거쳤는지에 대한 이력과 결정 근거가 보존되어, 최종 모델의 성능을 데이터 처리 단계의 특정 결정과 연계할 수 있는 시스템적 속성을 의미합니다.
- VidaForge-3M: 논문에서 함께 공개하는 대규모 데이터셋으로, 3.14백만 개의 scene-level 클립과 6,475시간의 영상 데이터 및 그에 대한 fine-grained annotation을 포함합니다.
- Wan 2.1 & V-JEPA 2.1: 연구에서 데이터 recipe가 모델 성능에 미치는 영향을 검증하기 위해 사용된 각각 생성 모델(generative) 및 자가 지도 학습(self-supervised) Representation Learning 모델입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 현대의 Video Foundation Models이 대규모 데이터를 필요로 함에도 불구하고, 이러한 데이터를 생성하는 End-to-End 데이터 파이프라인이 폐쇄적이고 불투명하다는 점을 해결하고자 합니다. 대다수의 주요 모델 기술 보고서는 데이터 필터링, deduplication, captioning 등 핵심적인 선택 과정을 거의 언급하지 않으며, 이로 인해 학계 연구자들은 새로운 가설을 검증하기 위해 처음부터 복잡한 데이터 인프라를 직접 구축해야 하는 어려움을 겪고 있습니다. 연구진은 이러한 공학적 진입 장벽을 낮추고, 데이터 recipe의 선택이 모델 성능에 미치는 영향을 체계적으로 분석할 수 있는 인프라의 필요성을 제기합니다 [Figure 1].
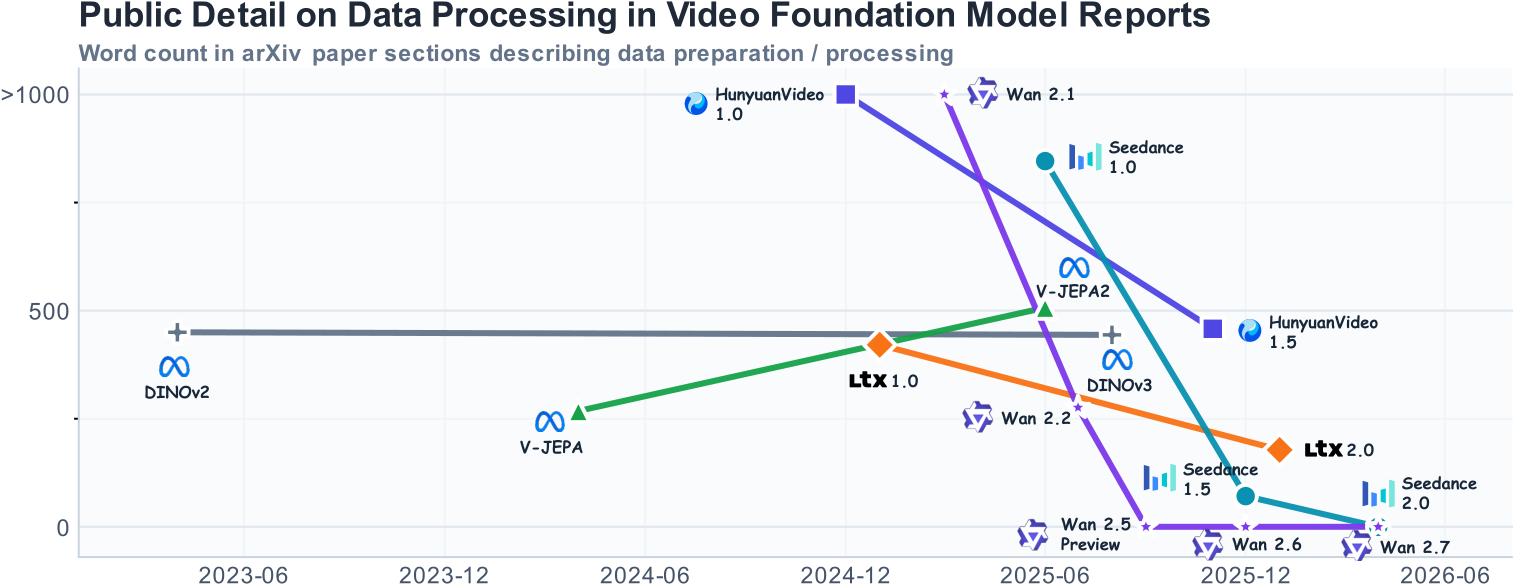
Figure 1 — 데이터 처리 상세 정보의 공개 수준
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 원본 영상부터 학습 데이터셋까지의 과정을 5단계로 체계화한 오픈 리서치 인프라 VidaForge를 제안합니다 [Figure 2]. VidaForge는 각 단계의 출력물과 결정 기록을 보존하여, 특정 recipe를 수정하더라도 기존 이력을 추적할 수 있도록 설계되었습니다. 연구진은 VidaForge를 활용하여 데이터 coverage와 품질(quality) 간의 균형이 초기 프리트레이닝에 미치는 영향을 분석했습니다 [Figure 3]. Wan 2.1 및 V-JEPA 2.1 모델을 대상으로 실험한 결과, 학습 손실(loss) 기반의 평가는 높은 필터링 점수를 가진 고품질 데이터셋을 선호하지만, 실제 다운스트림 벤치마크 점수(예: VBench의 Total 점수 및 SSv2 정확도)는 더 넓은 coverage를 갖는 Mixed 데이터셋이 우수함을 확인했습니다 [Figure 6, Figure 7]. 특히 Mixed 레시피는 Selected 레시피 대비 모든 학습 시드에서 더 높은 벤치마크 성능을 기록하며, 모델 성능 개선을 위해 단순히 고품질 샘플만 선택하는 것이 최선이 아닐 수 있음을 시사합니다 [Figure 6].
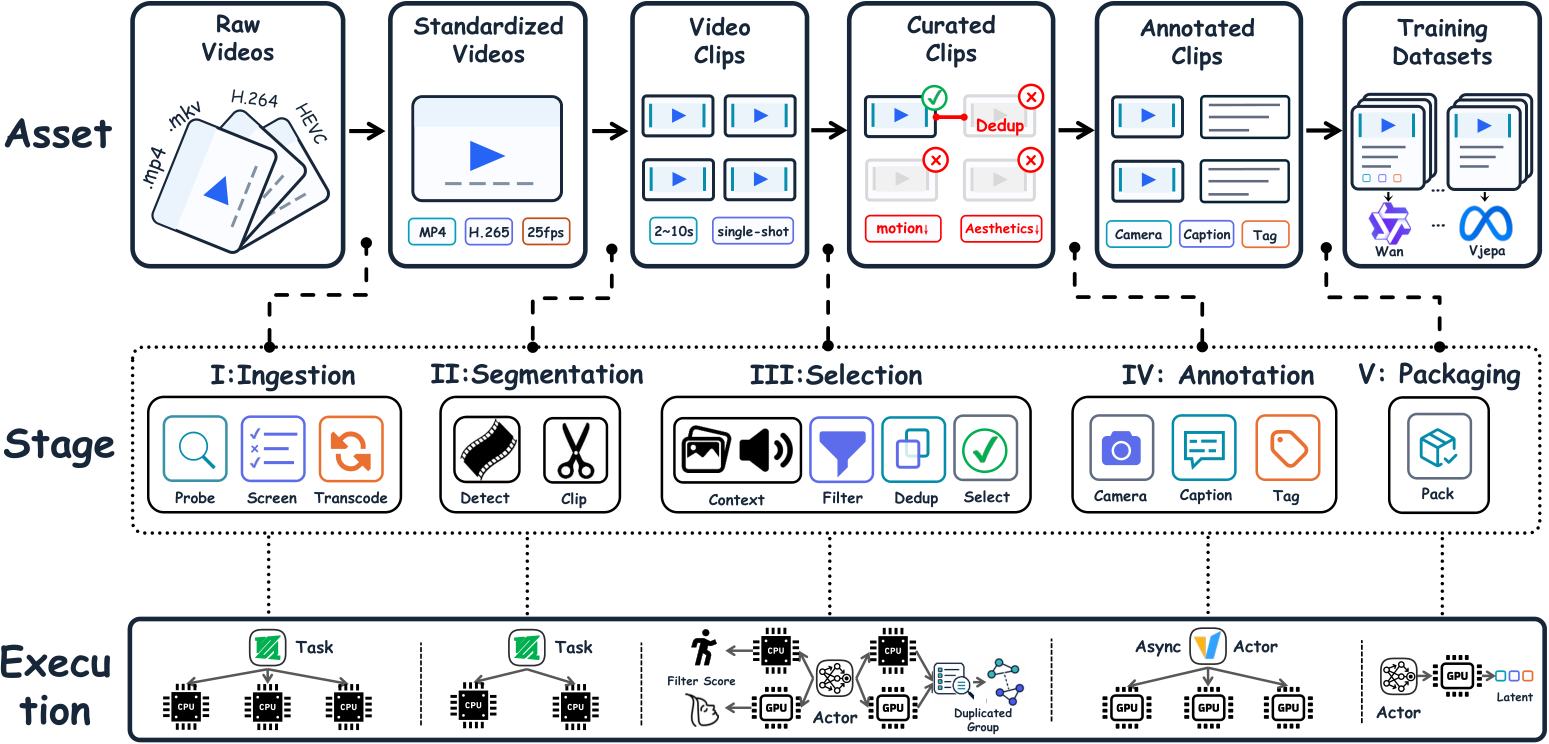
Figure 2 — VidaForge 전체 아키텍처
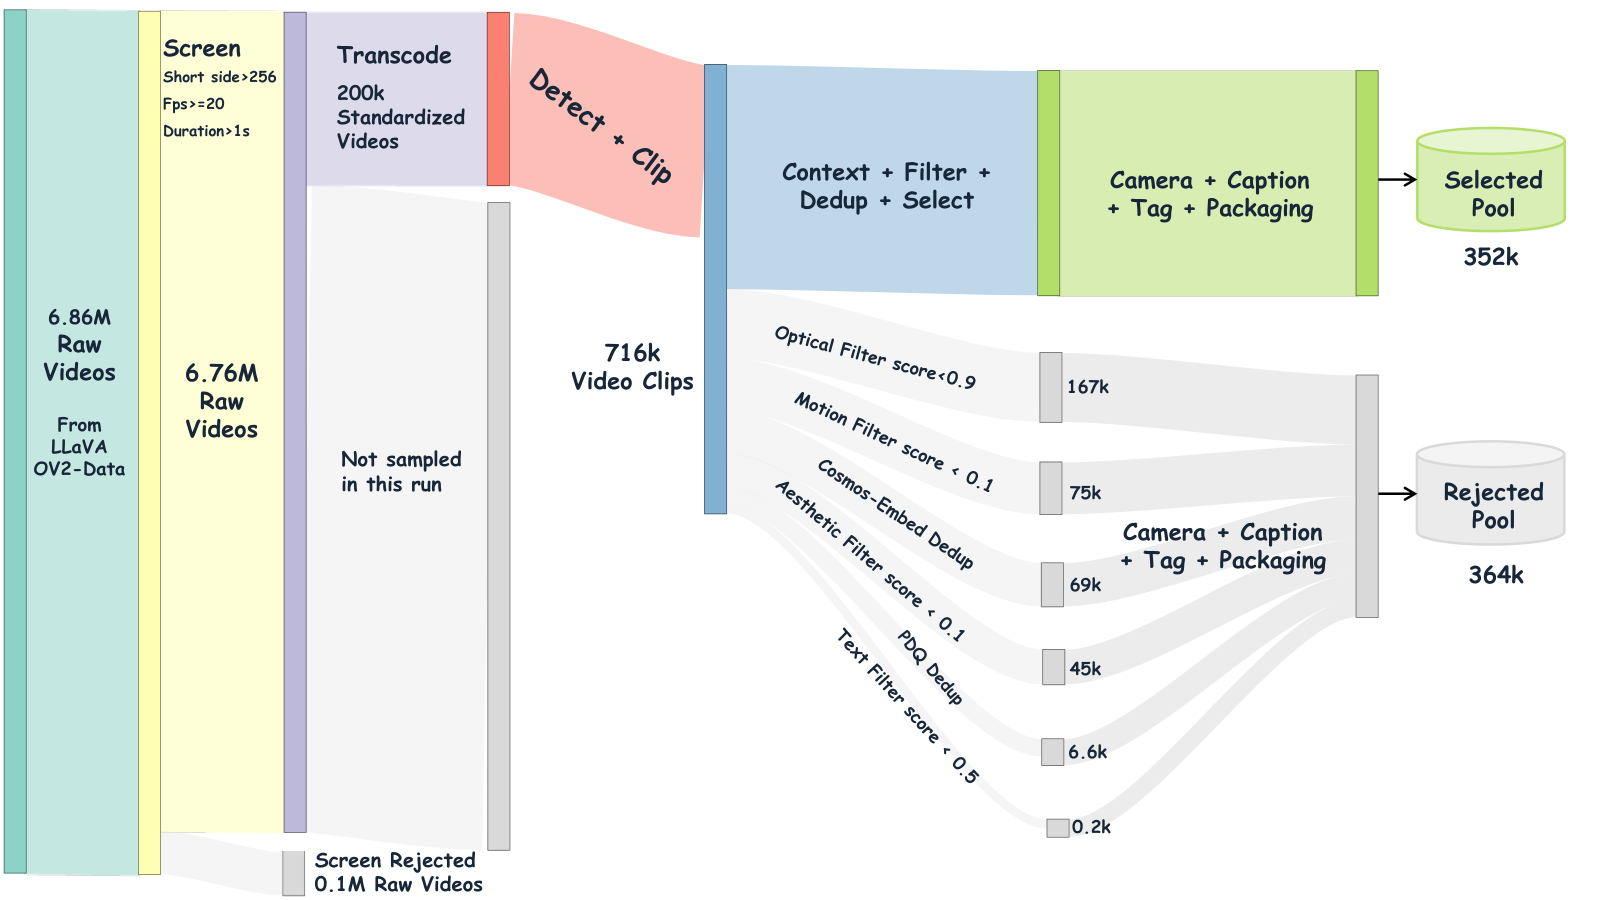
Figure 3 — Coverage-품질 연구 데이터 흐름
4. Conclusion & Impact (결론 및 시사점)
본 연구는 데이터 recipe의 선택과 모델 성능 간의 상관관계를 명확히 연결할 수 있는 실행 가능하고 투명한 인프라를 제공합니다. 연구를 통해 도출된 "더 넓은 coverage를 가진 데이터셋이 반드시 손실 값이 낮지 않더라도 downstream 작업에서는 더 나은 성능을 낼 수 있다"는 발견은 영상 모델 학습 전략에 중요한 통찰을 제공합니다. 향후 학계 및 산업계는 VidaForge를 통해 데이터 처리의 각 단계(segmentation, annotation 등)가 모델에 미치는 영향을 정밀하게 분석함으로써 영상 파운데이션 모델의 효율적 개발을 가속화할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] ODEWorld: A Continuous Predictive Architecture via Physical-Time Flow
- [논문리뷰] UniVBench: Towards Unified Evaluation for Video Foundation Models
- [논문리뷰] Motion Attribution for Video Generation
- [논문리뷰] Waver: Wave Your Way to Lifelike Video Generation
- [논문리뷰] World in World: Explore the World with World Models
Review 의 다른글
- 이전글 [논문리뷰] TransNormal-2: Geometry-Grounded Rectified Flow with Edge-Aware Decoding for Precise Normal Estimation
- 현재글 : [논문리뷰] VidaForge: Open Research Infrastructure for Video Pretraining Data Recipes
- 다음글 [논문리뷰] What Did I Just Say? Self-Listening for Full-Duplex Speech Models
댓글